Feature Engineering com PySpark
John Hogue
Lead Data Scientist, General Mills

df.select(['NO', 'UNITNUMBER', 'CLASS']).show()
+----+----------+-----+
| NO|UNITNUMBER|CLASS|
+----+----------+-----+
| 1| null| SF|
| 156| A8| SF|
| 157| 207| SF|
| 158| 701G| SF|
| 159| 36| SF|
Vários campos não são necessários para a análise
'NO' número de registro gerado automaticamente'UNITNUMBER' dado irrelevante'CLASS' constante em todos os registros drop(*cols)
*cols – um nome de coluna ou lista de colunas para excluir.# Lista de colunas para excluir cols_to_drop = ['NO', 'UNITNUMBER', 'CLASS']# Excluir as colunas df = df.drop(*cols_to_drop)
where(condition)types.BooleanType ou uma string de expressão SQL.like(other)~df = df.where(~df['POTENTIALSHORTSALE'].like('Not Disclosed'))
Filtre dados a até três desvios-padrão (3σ) da média (μ)
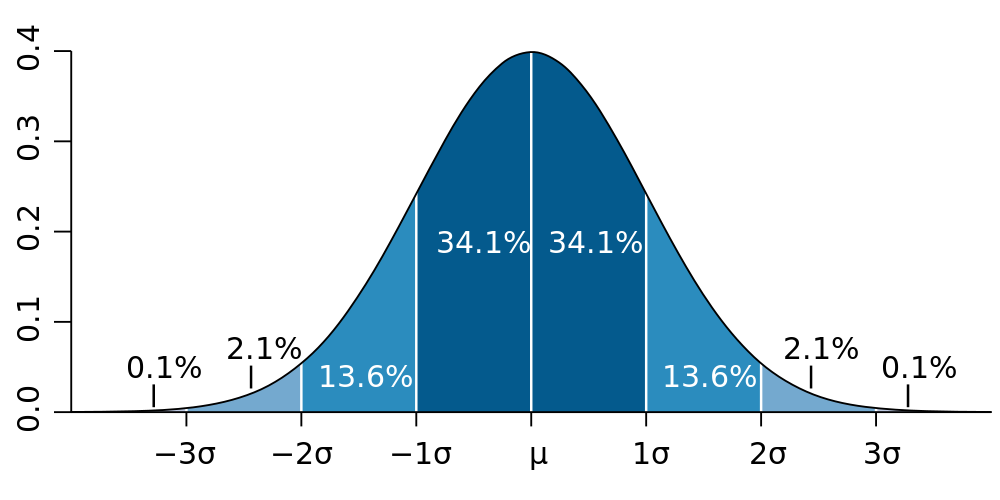
# Calcular valores usados no filtro std_val = df.agg({'SALESCLOSEPRICE': 'stddev'}).collect()[0][0] mean_val = df.agg({'SALESCLOSEPRICE': 'mean'}).collect()[0][0]# Criar limites superior e inferior de três desvios-padrão (μ ± 3σ) hi_bound = mean_val + (3 * std_val) low_bound = mean_val - (3 * std_val)# Usar where() para filtrar o DataFrame entre os valores df = df.where((df['LISTPRICE'] < hi_bound) & (df['LISTPRICE'] > low_bound))
DataFrame.dropna()
how: "any" ou "all". Se "any", remove o registro se tiver qualquer null. Se "all", remove apenas se todos os valores forem null.thresh: int, padrão None. Se definido, remove registros com menos que thresh valores não nulos. Substitui o parâmetro how.subset: lista opcional de nomes de colunas a considerar.# Remover registros com valores NULL df = df.dropna()# Remover registros se LISTPRICE e SALESCLOSEPRICE forem NULL df = df.dropna(how='all', subset['LISTPRICE', 'SALESCLOSEPRICE '])# Remover registros onde pelo menos duas colunas têm NULL df = df.dropna(thresh=2)
O que é um duplicado?
dropDuplicates()
# DataFrame inteiro df.dropDuplicates()# Verificar apenas uma lista de colunas df.dropDuplicates(['streetaddress'])
Feature Engineering com PySpark