Inspecionando dados visualmente

Feature Engineering com PySpark

John Hogue

Lead Data Scientist, General Mills

Usando DataFrame.describe() para descrever

df.describe(['LISTPRICE']).show()
+-------+------------------+
|summary|         LISTPRICE|
+-------+------------------+
|  count|              5000|
|   mean|        263419.365|
| stddev|143944.10818036905|
|    min|            100000|
|    max|             99999|
+-------+------------------+
Feature Engineering com PySpark

Muitas funções descritivas já estão disponíveis

  • Média
    • pyspark.sql.functions.mean(col)
  • Assimetria
    • pyspark.sql.functions.skewness(col)
  • Mínimo
    • pyspark.sql.functions.min(col)
  • Covariância
    • cov(col1, col2)
  • Correlação
    • corr(col1, col2)
Feature Engineering com PySpark

Exemplo com mean()

  • mean(col)
  • Função de agregação: retorna a média dos valores em um grupo.
df.agg({'SALESCLOSEPRICE': 'mean'}).collect()
[Row(avg(SALESCLOSEPRICE)=262804.4668)]
Feature Engineering com PySpark

Exemplo com cov()

  • cov(col1, col2)
  • Parâmetros:
    • col1 – primeira coluna
    • col2 – segunda coluna
df.cov('SALESCLOSEPRICE', 'YEARBUILT')
1281910.3840634783
Feature Engineering com PySpark

seaborn: visualização estatística de dados
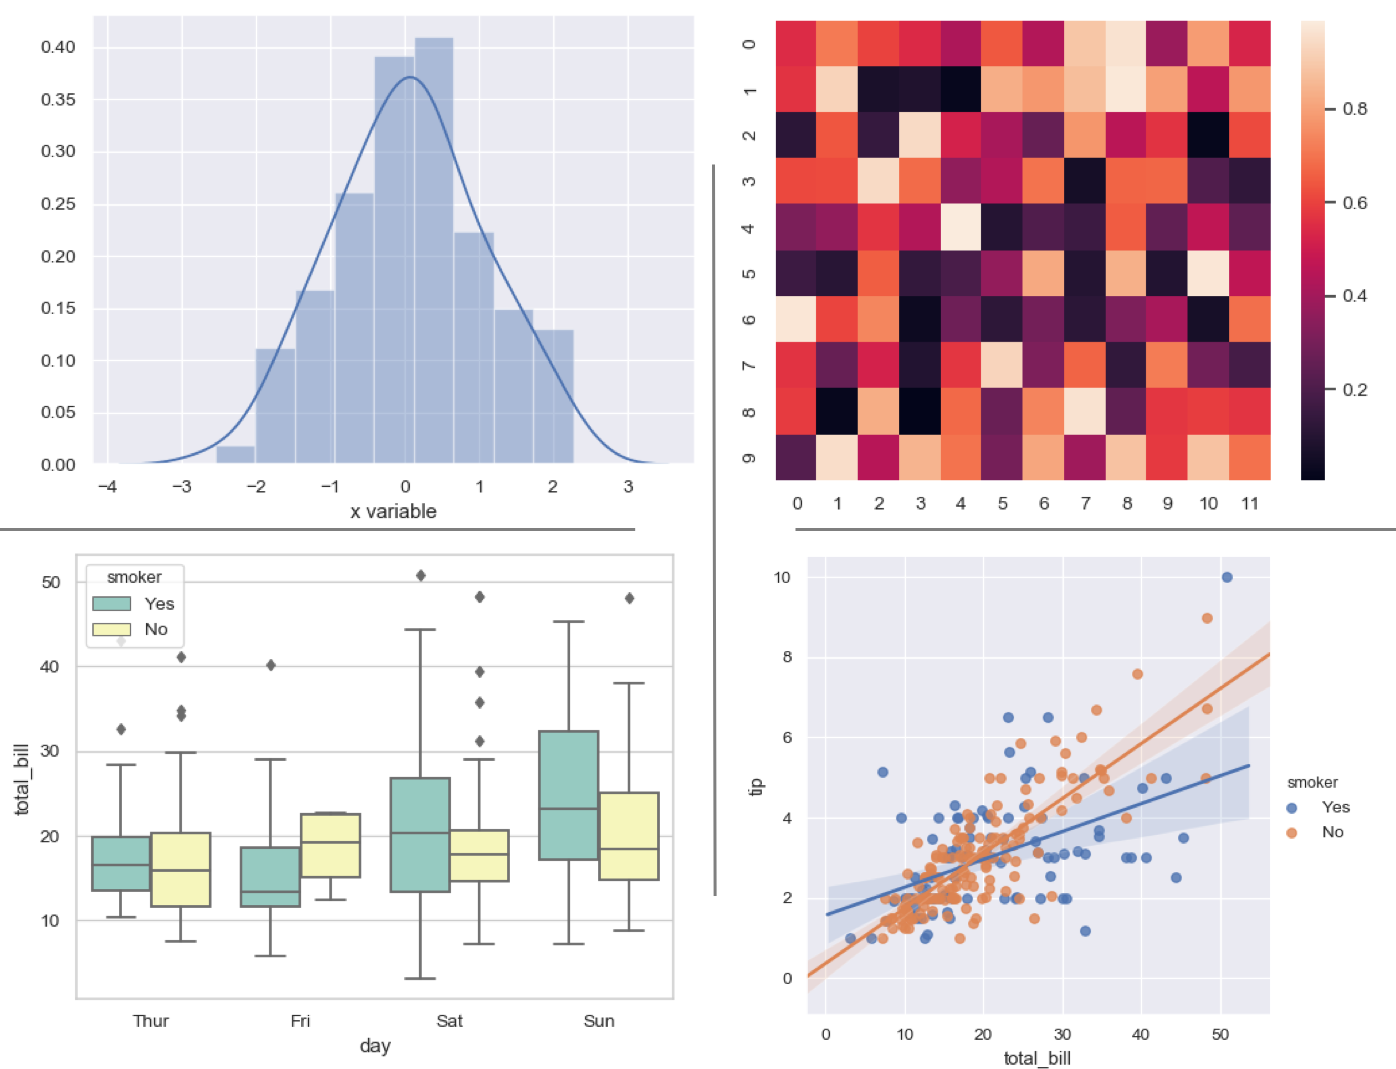
Seaborn

Feature Engineering com PySpark

Observações sobre plotagem

Plotar DataFrames do PySpark com bibliotecas como Seaborn exige converter para Pandas

AVISO: Faça amostras de DataFrames do PySpark antes de converter para Pandas!

  • sample(withReplacement, fraction, seed=None)
    • withReplacement permite repetição na amostra
    • fraction % de registros a manter
    • seed semente aleatória para reprodutibilidade
# Amostrar 50% do DataFrame do PySpark e contar linhas
df.sample(False, 0.5, 42).count()
2504
Feature Engineering com PySpark

Preparando para plotar uma distribuição

Seaborn distplot()

  • seaborn.distplot(a)
  • a : Series, array 1D ou lista. Dados observados.
# Importe sua biblioteca de visualização favorita
import seaborn as sns

# Faça a amostra do dataframe sample_df = df.select(['SALESCLOSEPRICE']).sample(False, 0.5, 42)
# Converta a amostra para um DataFrame do Pandas pandas_df = sample_df.toPandas()
# Plote sns.distplot(pandas_df)
Feature Engineering com PySpark

Gráfico de distribuição do preço de fechamento
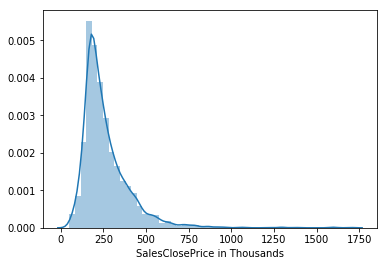
Displot

Feature Engineering com PySpark

Plotando relações

Seaborn lmplot()

  • seaborn.lmplot(x, y, data)
  • x, y : strings. Variáveis de entrada; devem ser nomes de colunas em data.
  • data : DataFrame do Pandas
# Importe sua biblioteca de visualização favorita
import seaborn as sns

# Selecione as colunas s_df = df.select(['SALESCLOSEPRICE', 'SQFTABOVEGROUND']) # Amostre o dataframe s_df = s_df.sample(False, 0.5, 42)
# Converta para DataFrame do Pandas pandas_df = s_df.toPandas()
# Plote sns.lmplot(x='SQFTABOVEGROUND', y='SALESCLOSEPRICE', data=pandas_df)
Feature Engineering com PySpark

Modelo linear entre área acima do solo (SQFT) e preço de venda
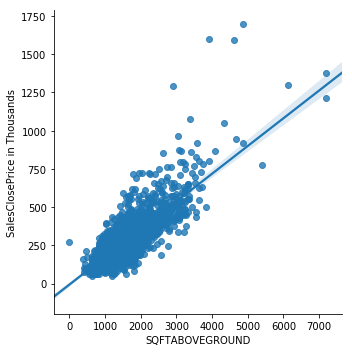
Gráfico de modelo linear

Feature Engineering com PySpark

Vamos praticar!

Feature Engineering com PySpark

Preparing Video For Download...