Ajustando os dados

Feature Engineering com PySpark

John Hogue

Lead Data Scientist, General Mills

Por que transformar dados?
Transformação

Feature Engineering com PySpark

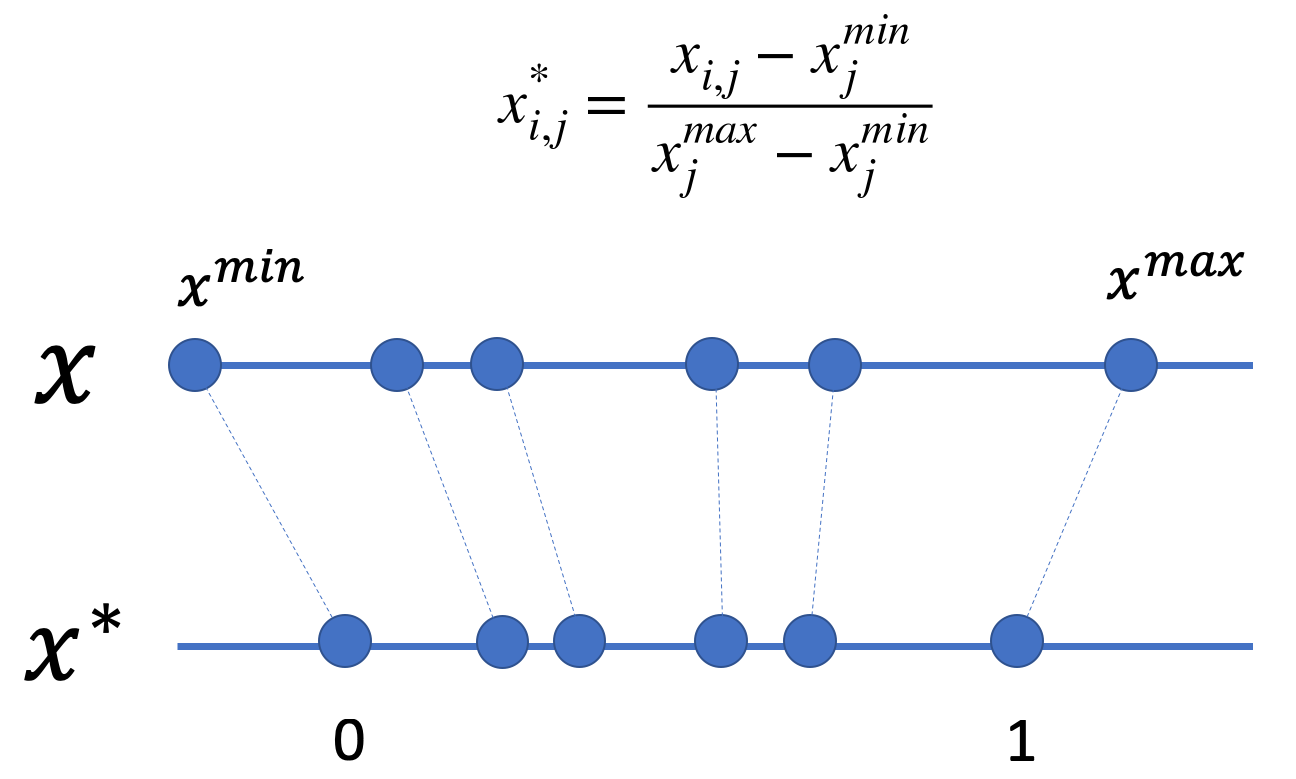
O que é MinMax Scaling

Escalonamento Min-Max

Feature Engineering com PySpark

Escalonamento Min-Max

# defina os valores mínimo e máximo e colete-os
max_days = df.agg({'DAYSONMARKET': 'max'}).collect()[0][0]
min_days = df.agg({'DAYSONMARKET': 'min'}).collect()[0][0]

# crie uma nova coluna com os dados escalonados df = df.withColumn("scaled_days", (df['DAYSONMARKET'] - min_days) / (max_days - min_days))
df[['scaled_days']].show(5)
+--------------------+
|         scaled_days|
+--------------------+
|0.044444444444444446|
|0.017777777777777778|
| 0.12444444444444444|
| 0.08444444444444445|
| 0.09333333333333334|
+--------------------+
only showing top 5 rows
Feature Engineering com PySpark

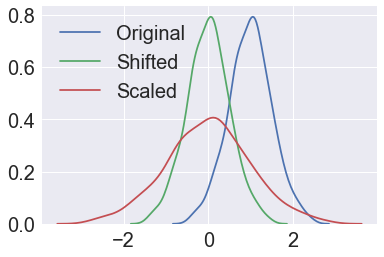
O que é Padronização?

Transforme para distribuição normal padrão

  • z = (x - μ)/ σ
  • Média, μ igual a 0
  • Desvio padrão, σ igual a 1

Padronização

Feature Engineering com PySpark

Padronização

mean_days = df.agg({'DAYSONMARKET': 'mean'}).collect()[0][0]
stddev_days = df.agg({'DAYSONMARKET': 'stddev'}).collect()[0][0]

# Crie uma nova coluna com os dados escalonados df = df.withColumn("ztrans_days", (df['DAYSONMARKET'] - mean_days) / stddev_days)
df.agg({'ztrans_days': 'mean'}).collect()
[Row(avg(ztrans_days)=-3.6568525985103407e-16)]
df.agg({'ztrans_days': 'stddev'}).collect()
[Row(stddev(ztrans_days)=1.0000000000000009)]
Feature Engineering com PySpark

O que é Log Scaling

Distribuição sem escala
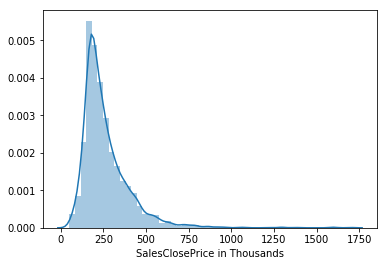
Gráfico da distribuição bruta

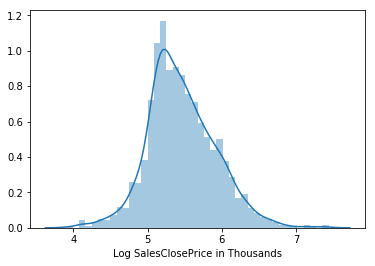
Distribuição com escala log

Gráfico da distribuição com log

Feature Engineering com PySpark

Escala log

# importe a função log
from pyspark.sql.functions import log
# Recalcule o log de SALESCLOSEPRICE
df = df.withColumn('log_SalesClosePrice', log(df['SALESCLOSEPRICE']))
Feature Engineering com PySpark

Vamos praticar!

Feature Engineering com PySpark

Preparing Video For Download...