Introdução ao Spark SQL em Python
Mark Plutowski
Data Scientist
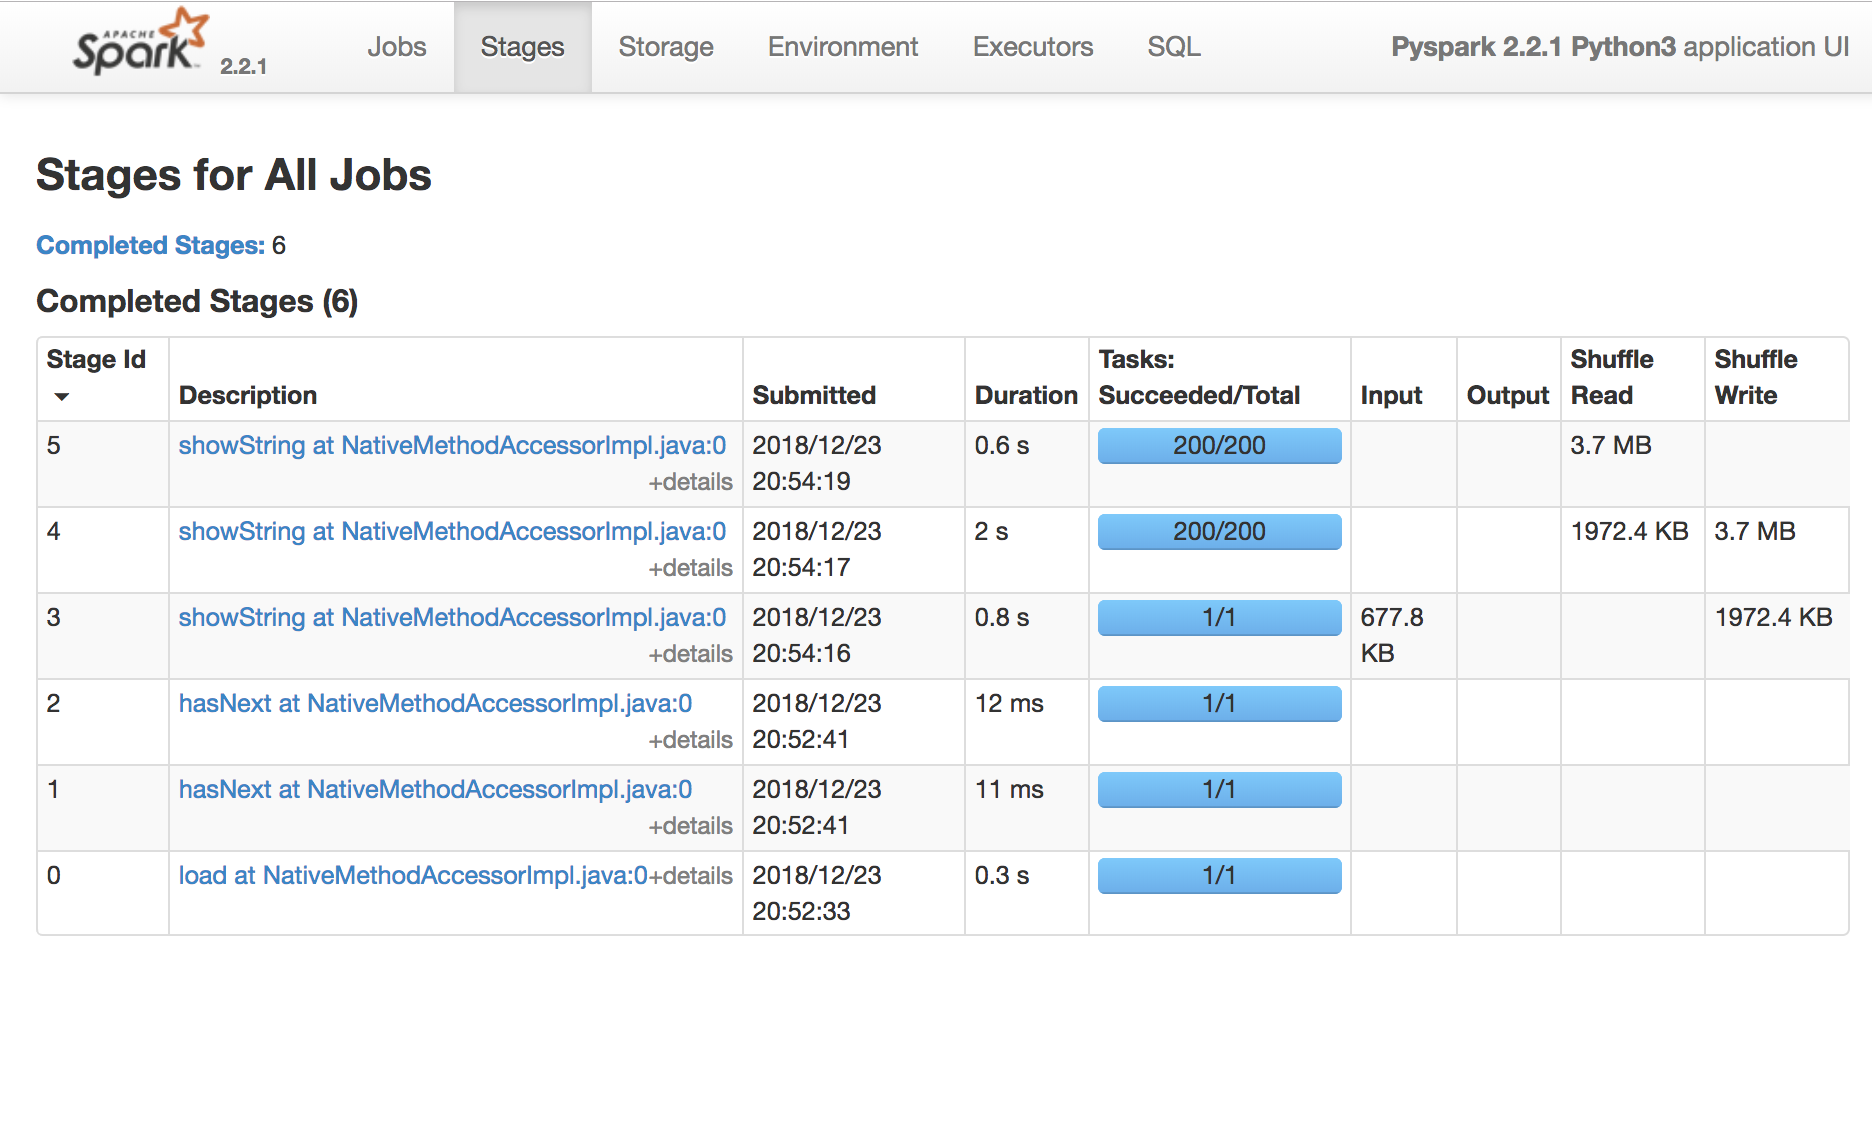
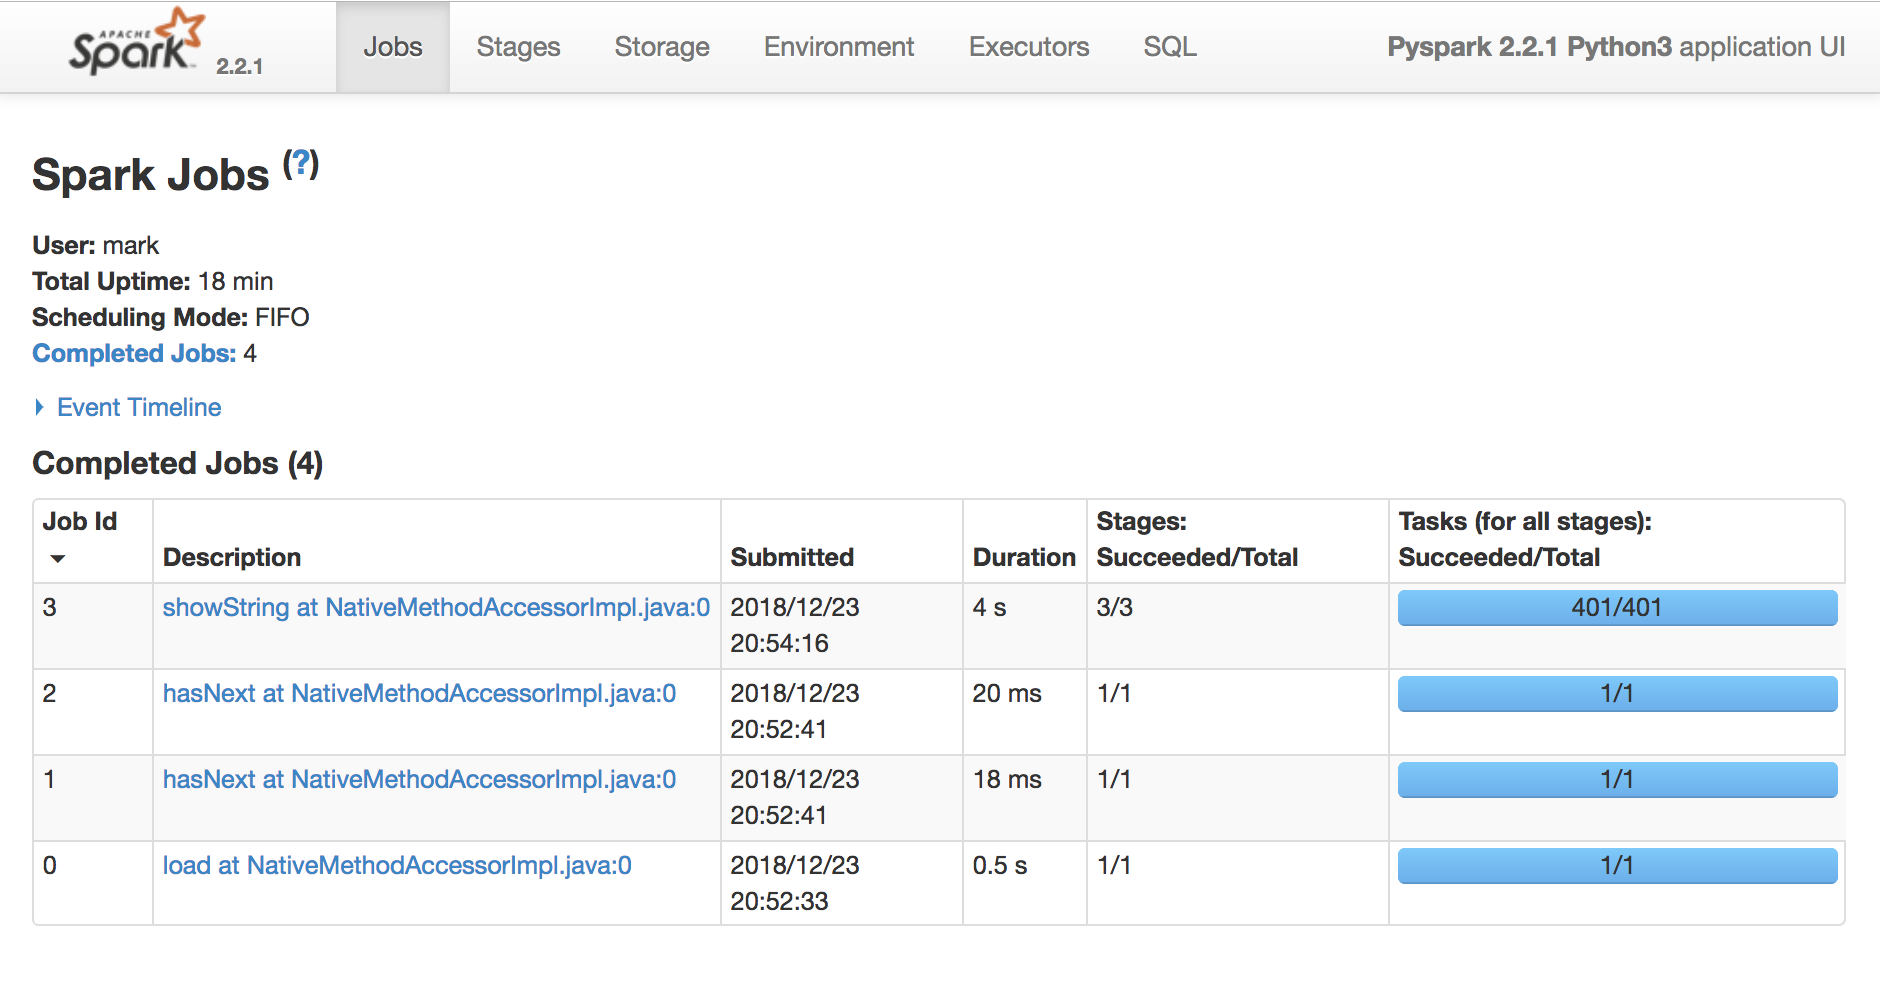
Spark Task é uma unidade de execução que roda em uma única CPU
Spark Stage é um grupo de tasks que fazem o mesmo cálculo em paralelo, cada uma geralmente em um subconjunto dos dados
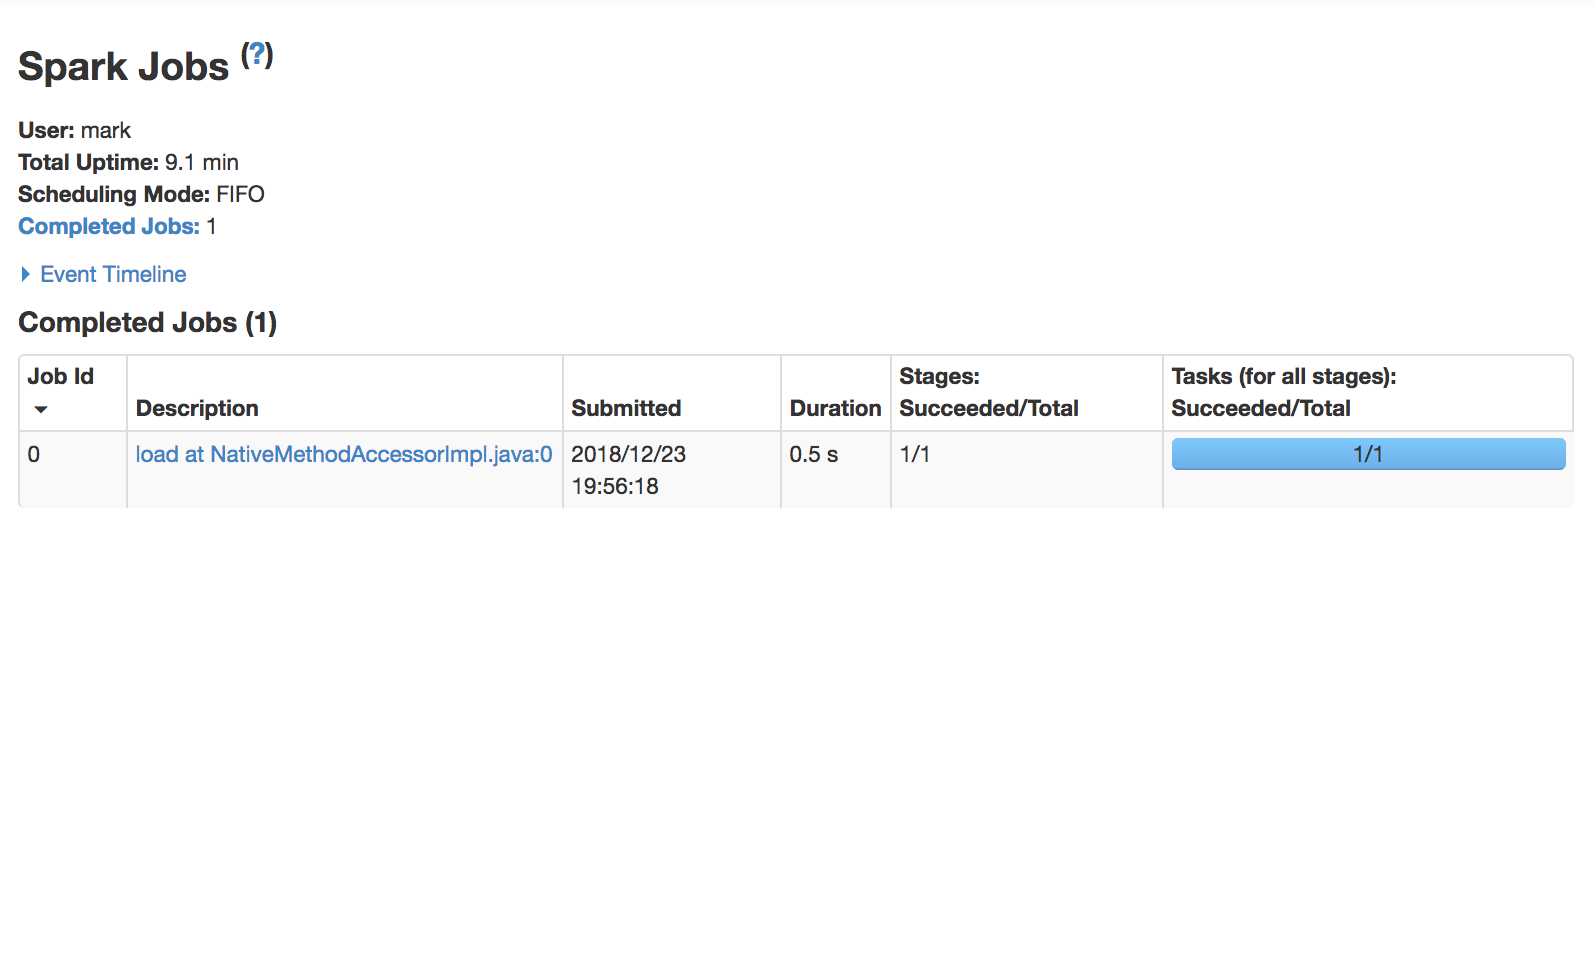
Spark Job é um cálculo disparado por uma ação, dividido em uma ou mais stages.

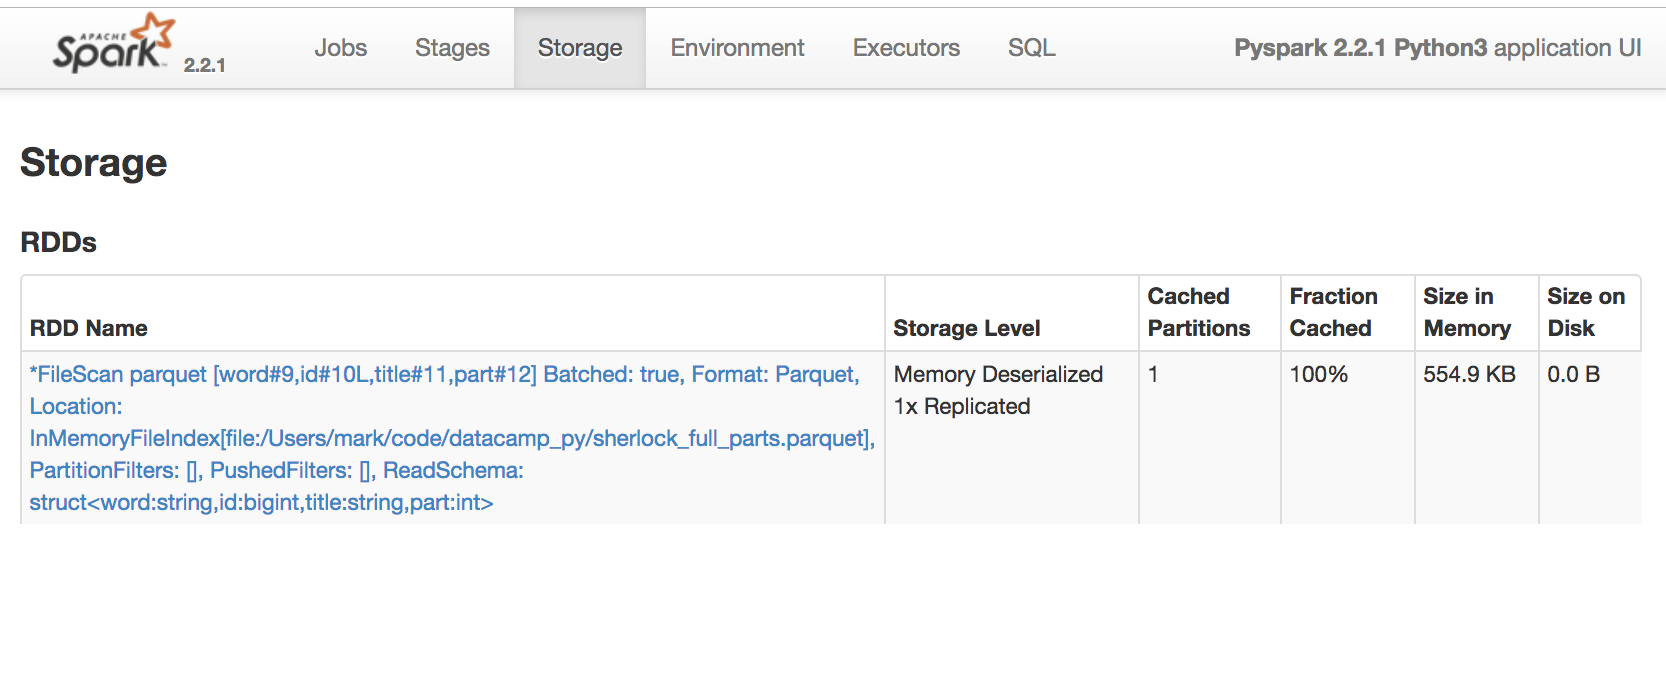
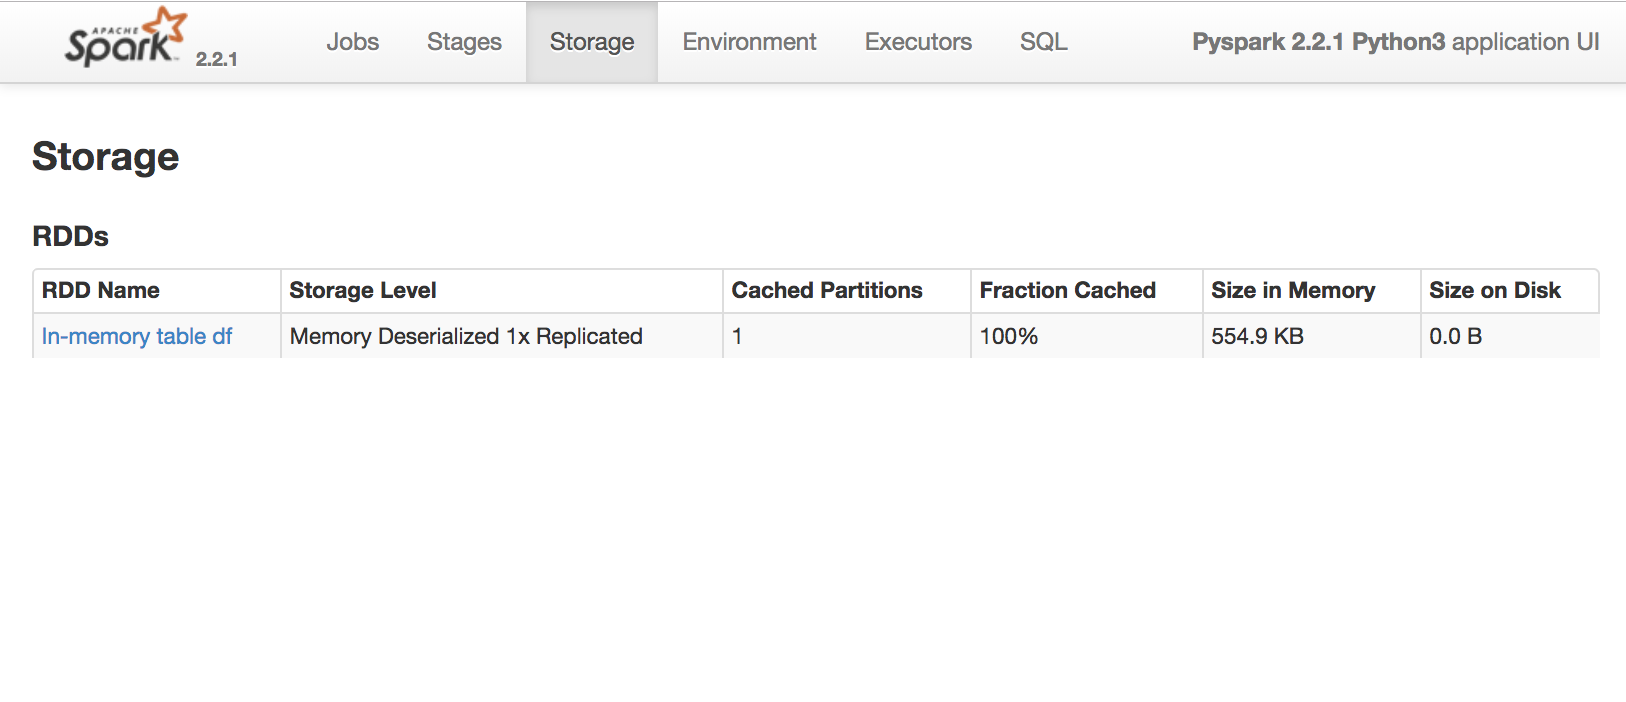
spark.catalog.cacheTable('table1')spark.catalog.uncacheTable('table1')spark.catalog.isCached('table1')spark.catalog.dropTempView('table1')spark.catalog.listTables()
[Table(name='text', database=None, description=None, tableType='TEMPORARY', isTemporary=True)]


Mostra onde as partições de dados estão
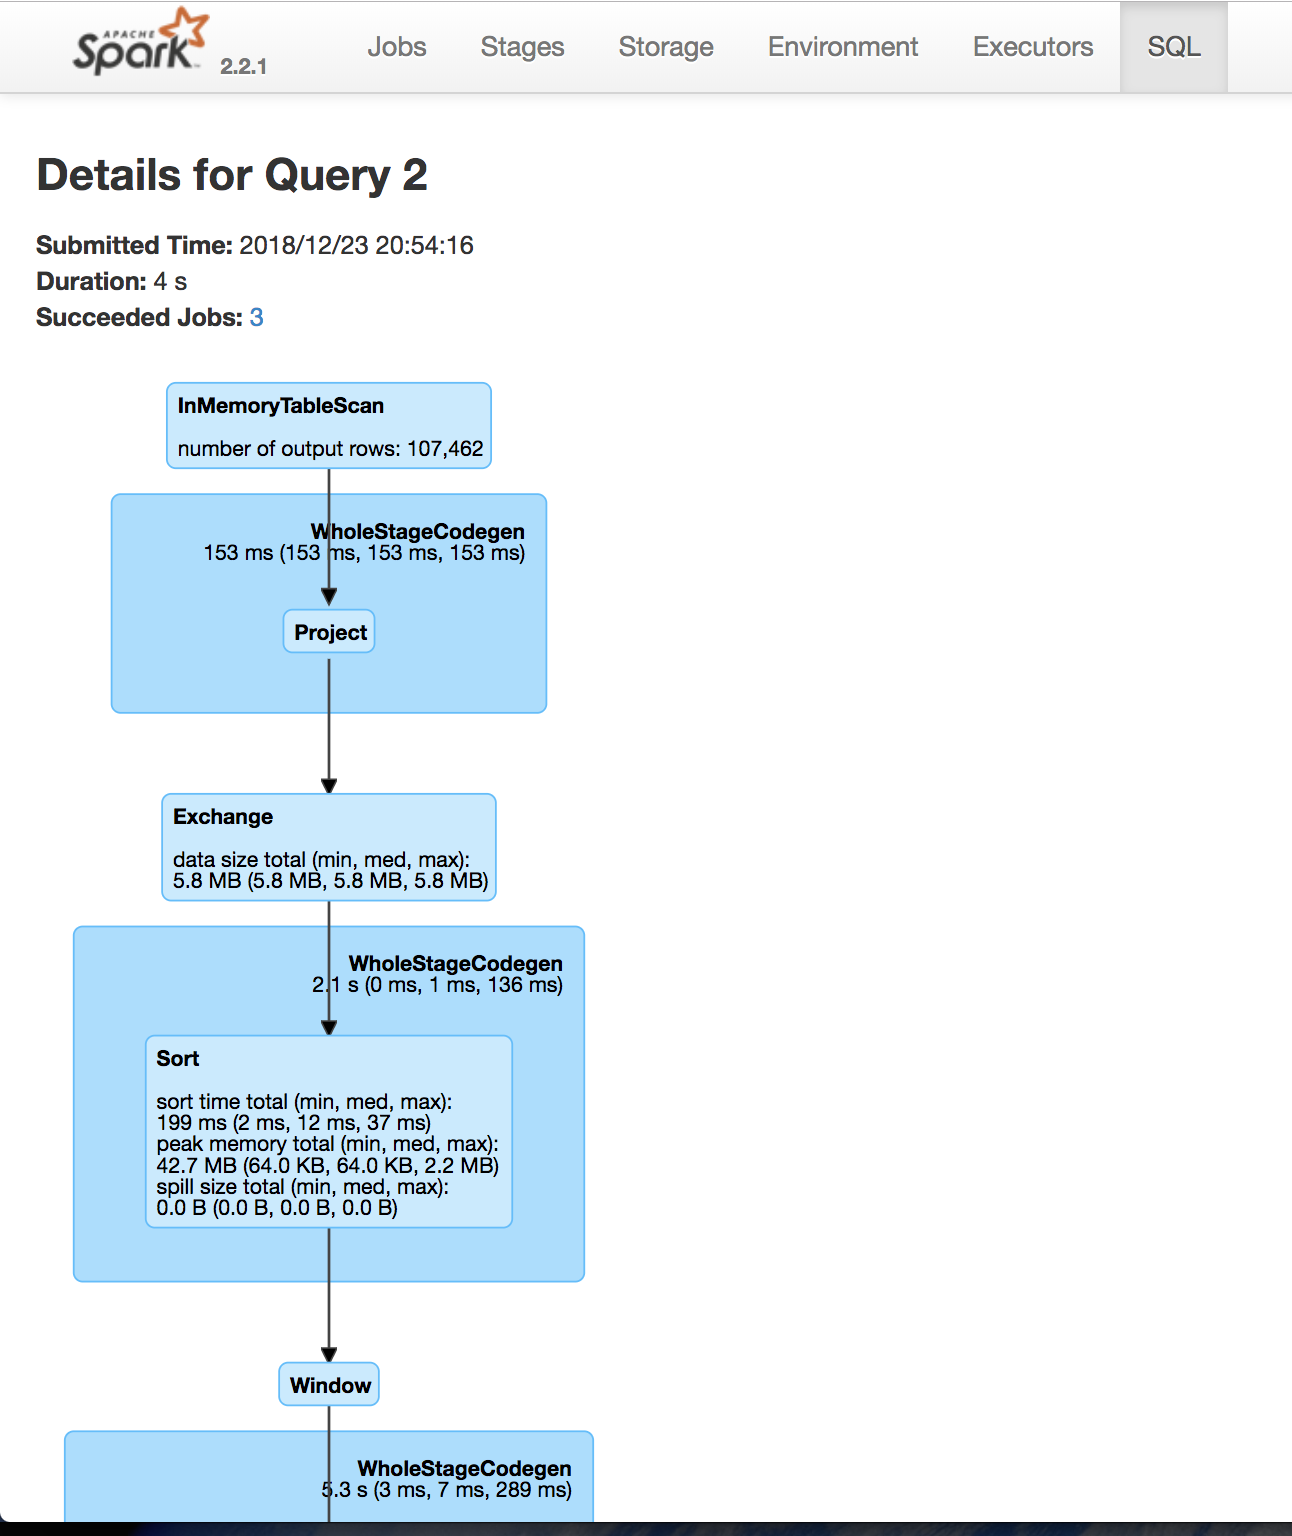
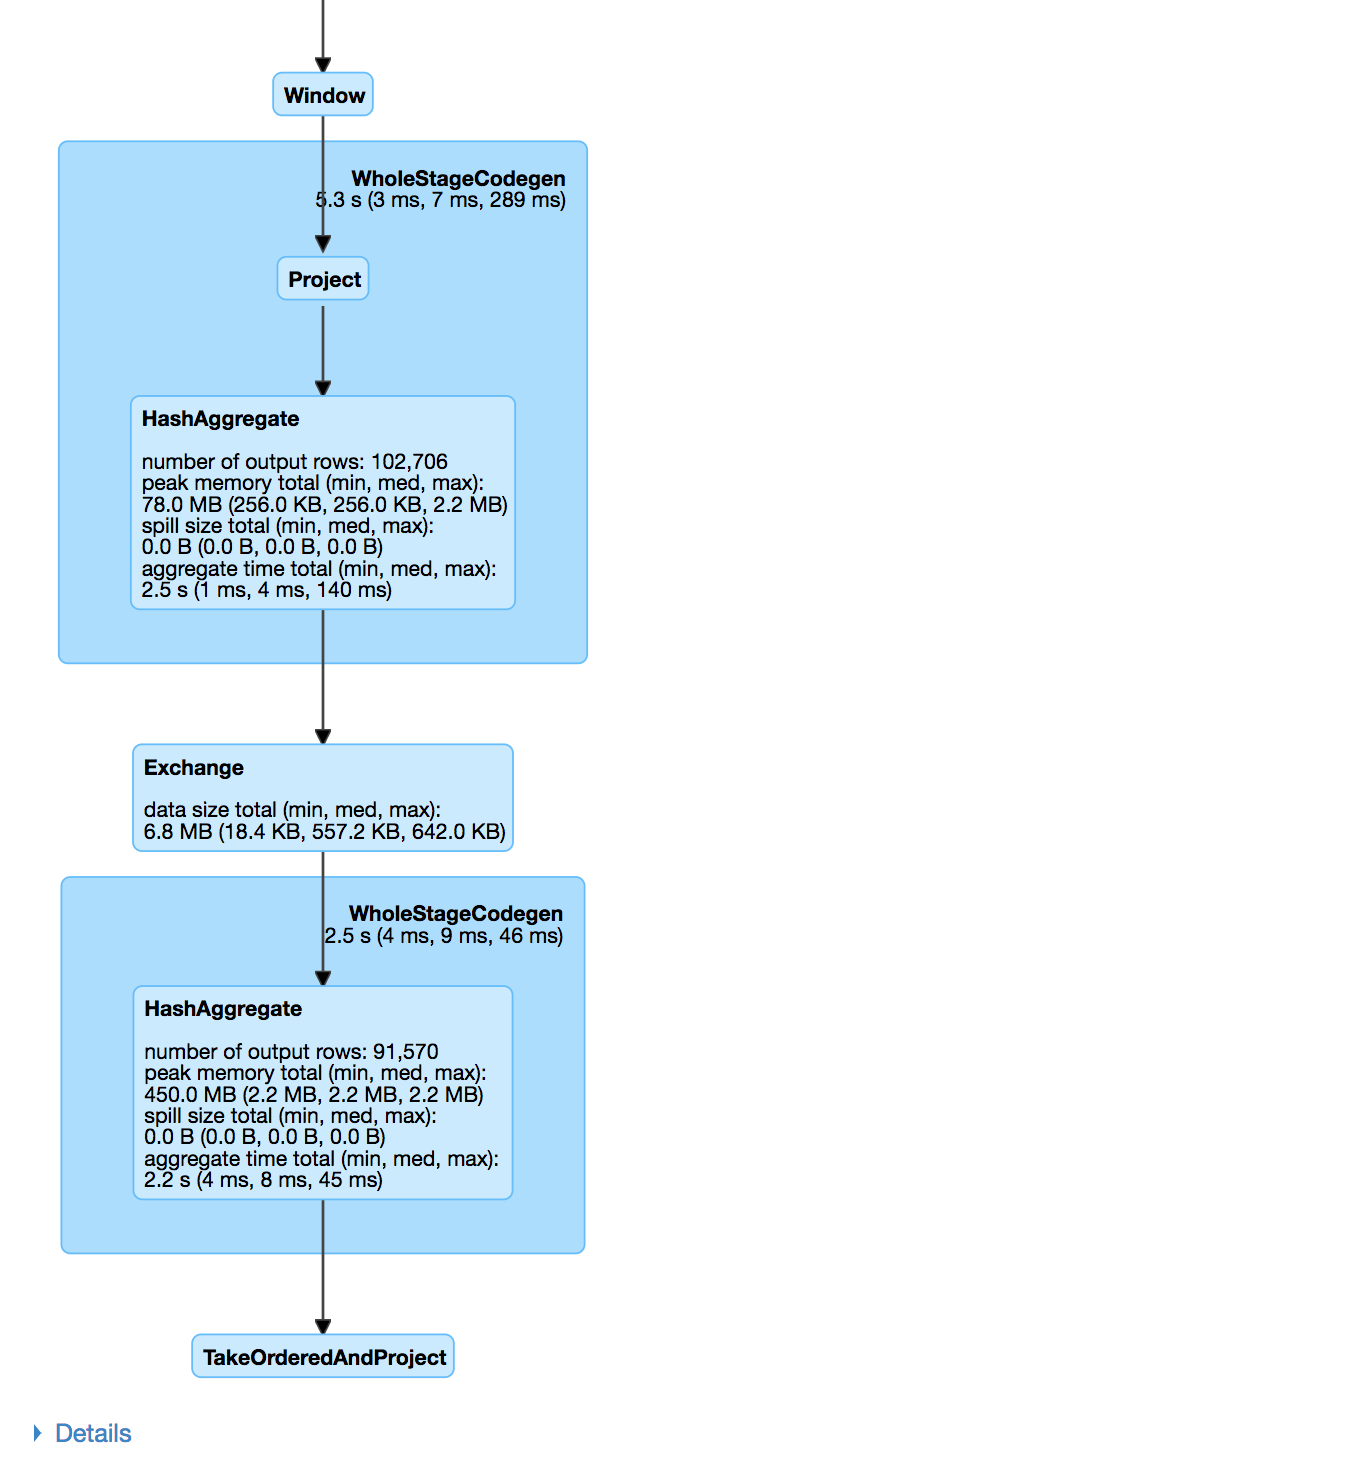
query3agg = """ SELECT w1, w2, w3, COUNT(*) as count FROM ( SELECT word AS w1, LEAD(word,1) OVER(PARTITION BY part ORDER BY id ) AS w2, LEAD(word,2) OVER(PARTITION BY part ORDER BY id ) AS w3 FROM df ) GROUP BY w1, w2, w3 ORDER BY count DESC """spark.sql(query3agg).show()


Introdução ao Spark SQL em Python