Engenharia de Dados no Microsoft Fabric
Transforme e analise dados com o Microsoft Fabric
Luis Silva
Solution Architect - Data & AI
Analytics de Dados de Ponta a Ponta
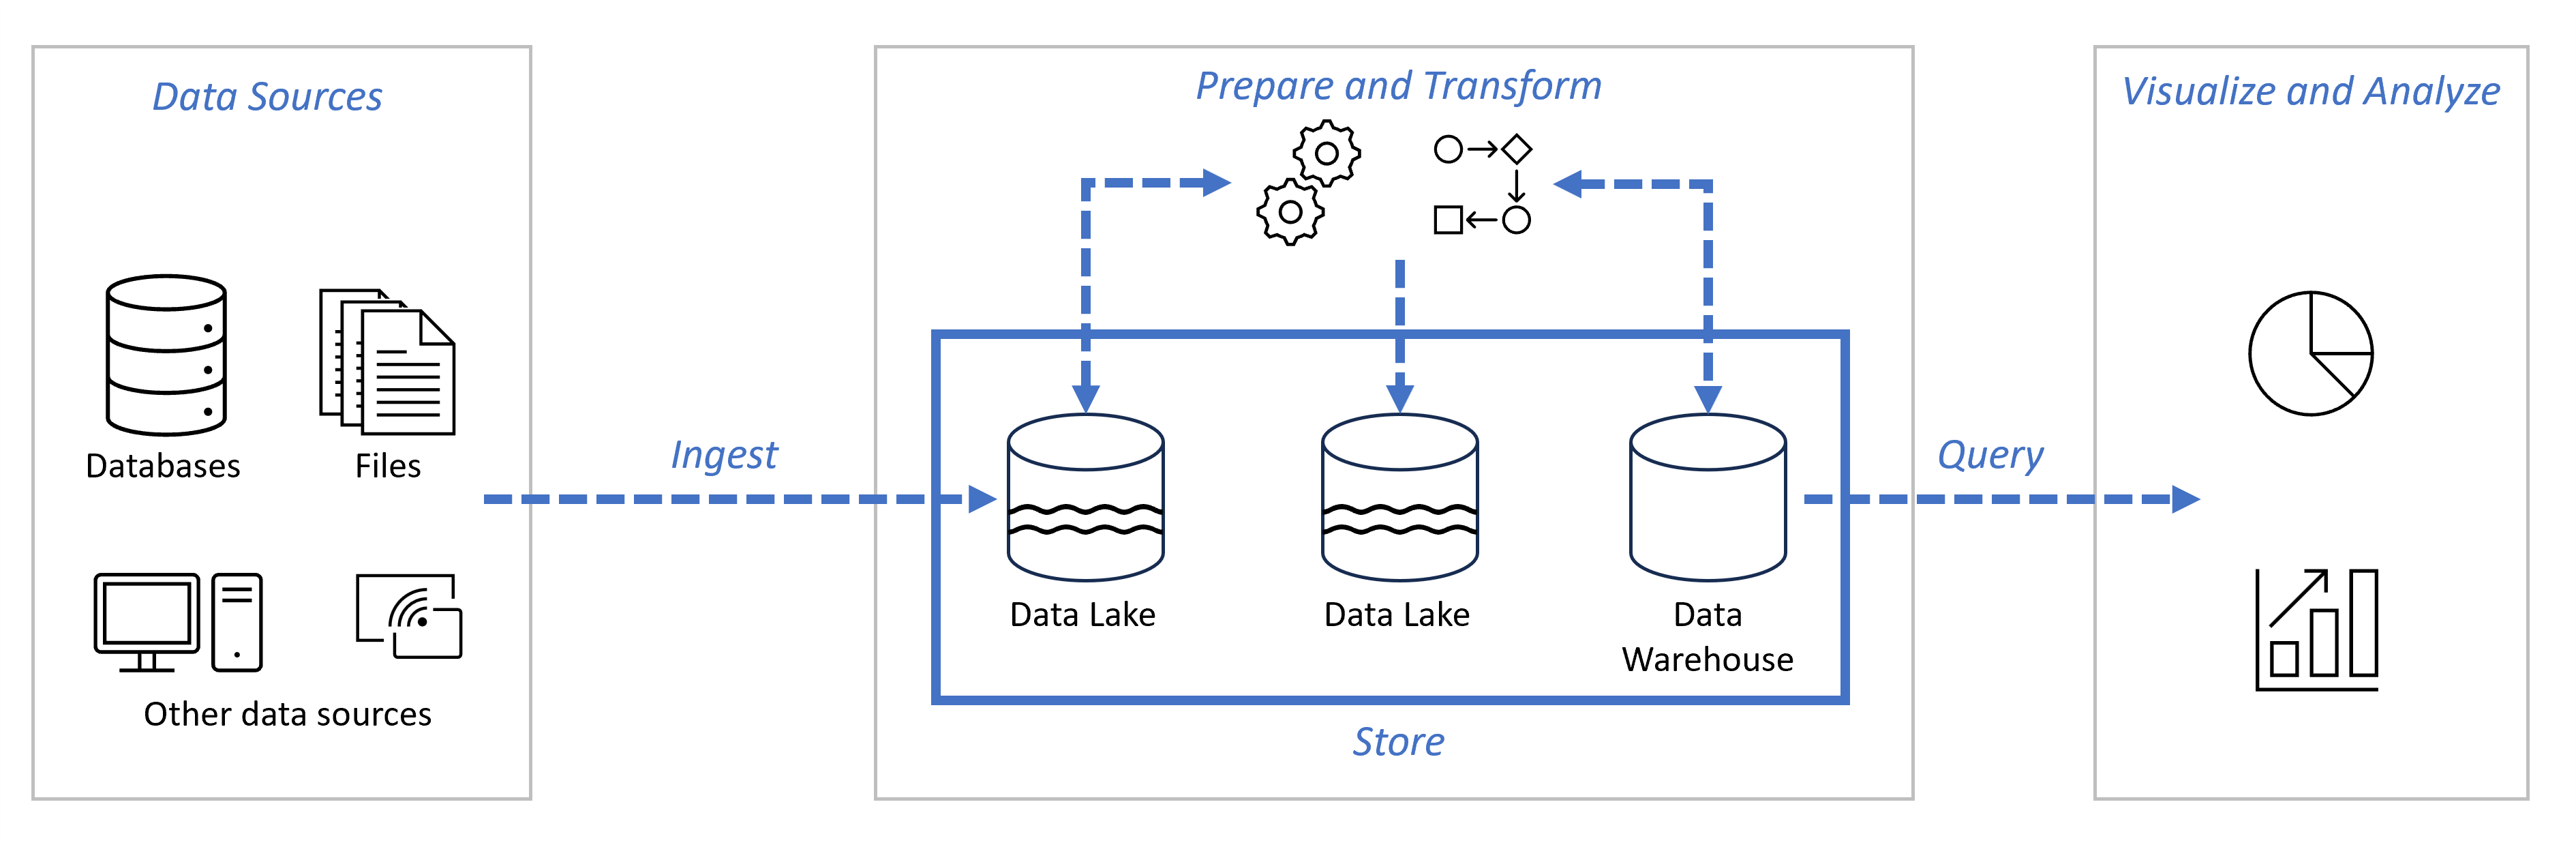
Ingerir dados da fonte e armazenar em um data lake
Preparar e transformar os dados
Visualizar e analisar os dados
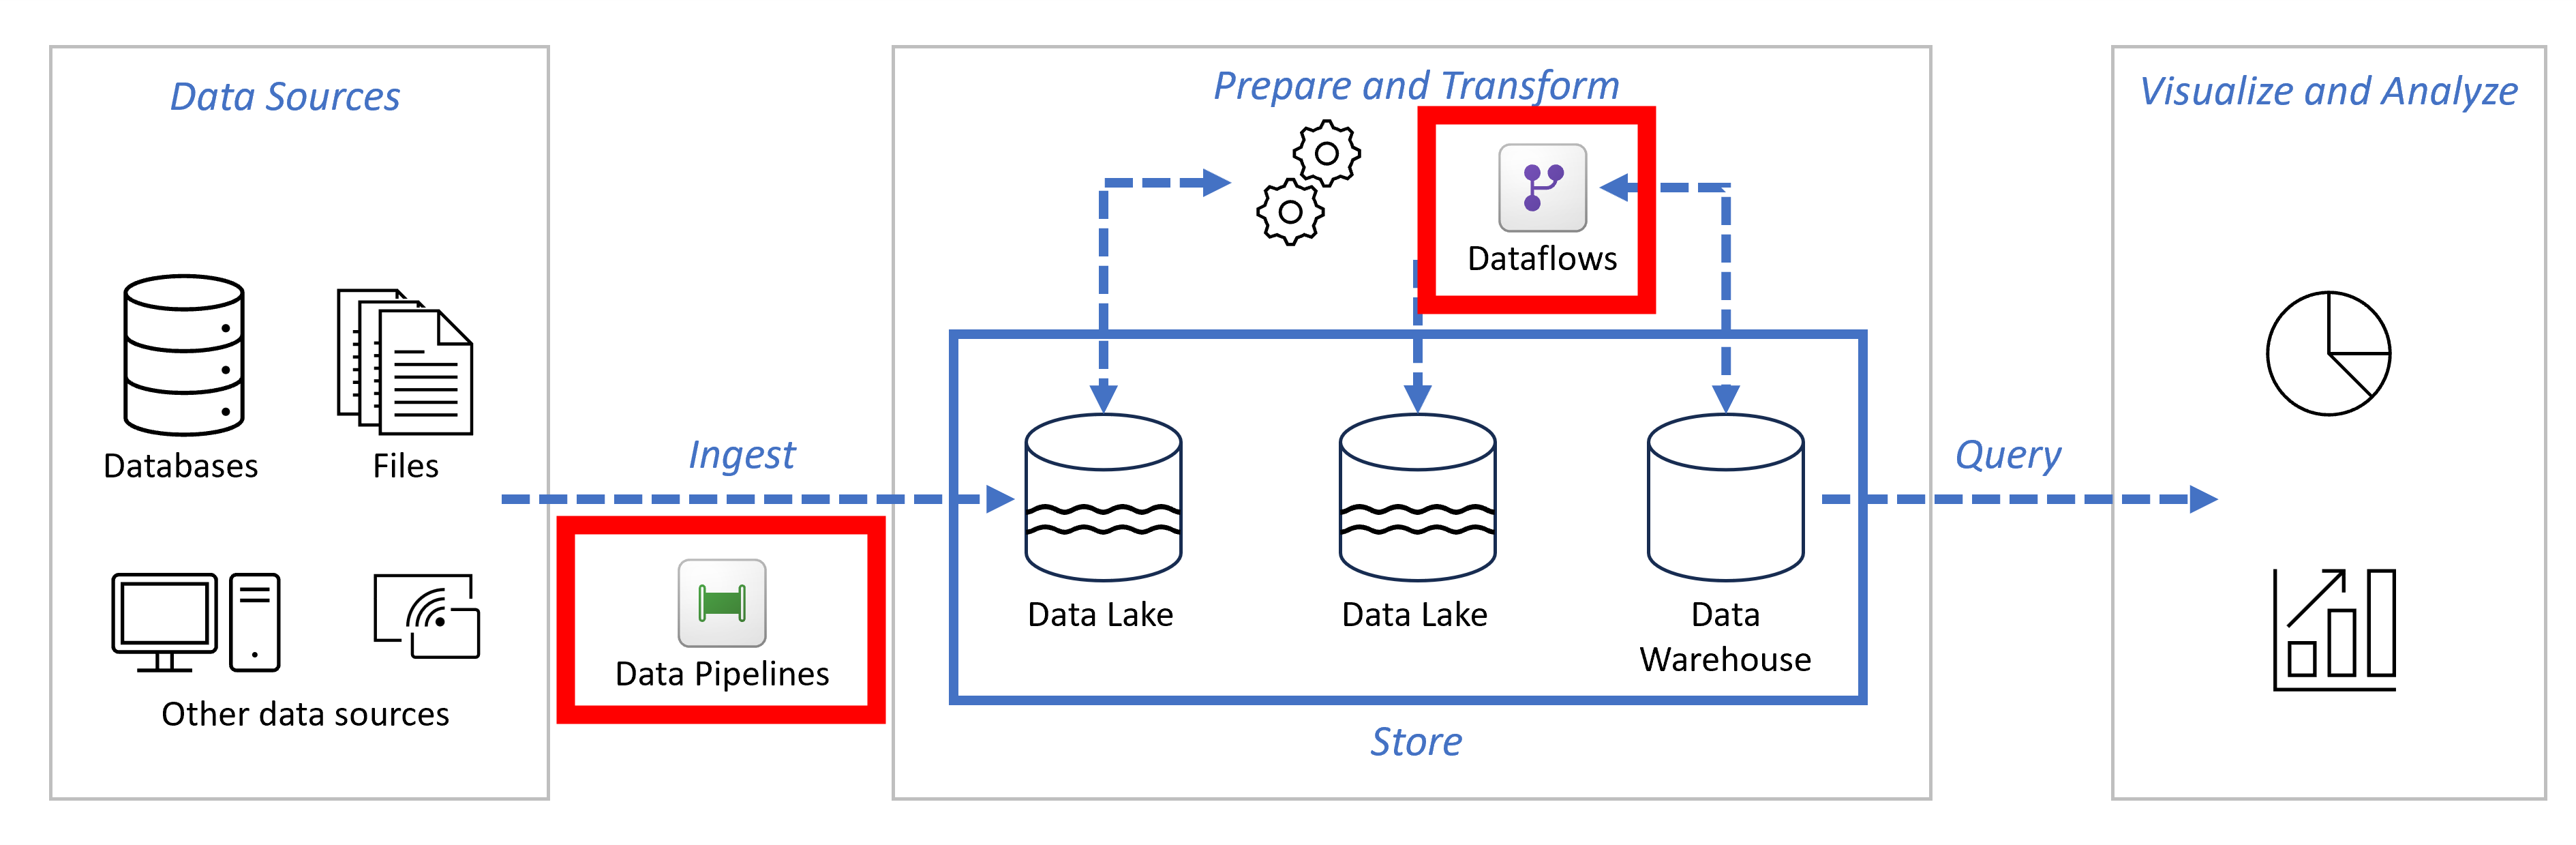
Data Factory
Ingerir, preparar e transformar dados
Dataflows e Data Pipelines
Dataflows
Interface low-code para ingestão e transformação
Mecanismo de transformação Power Query
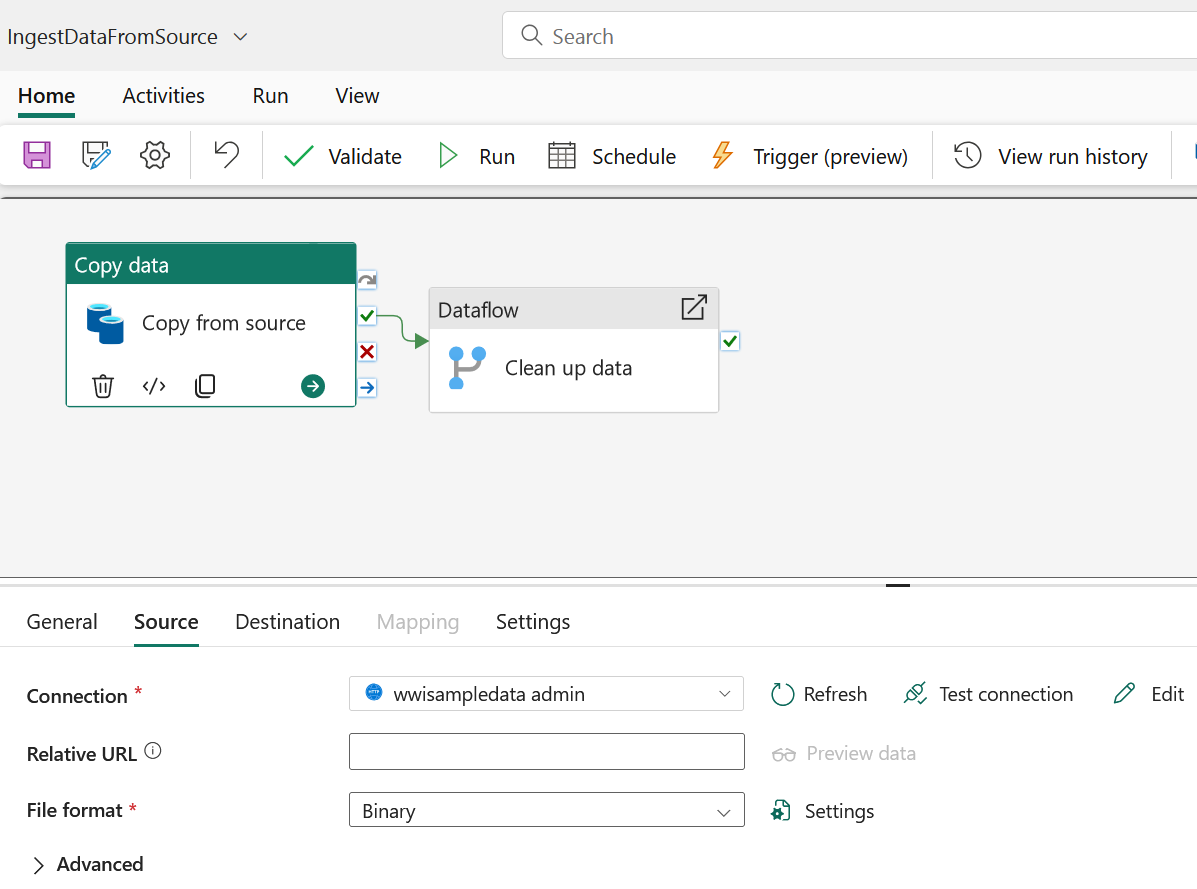
Data Pipelines
Conjunto de atividades que executam uma tarefa
Tipos de atividades:
Movimentação de dados (Copy activity, Dataflow)
Transformação de dados (Notebook, Stored Procedure, Script)
Controle (Switch, If, ForEach, Wait)
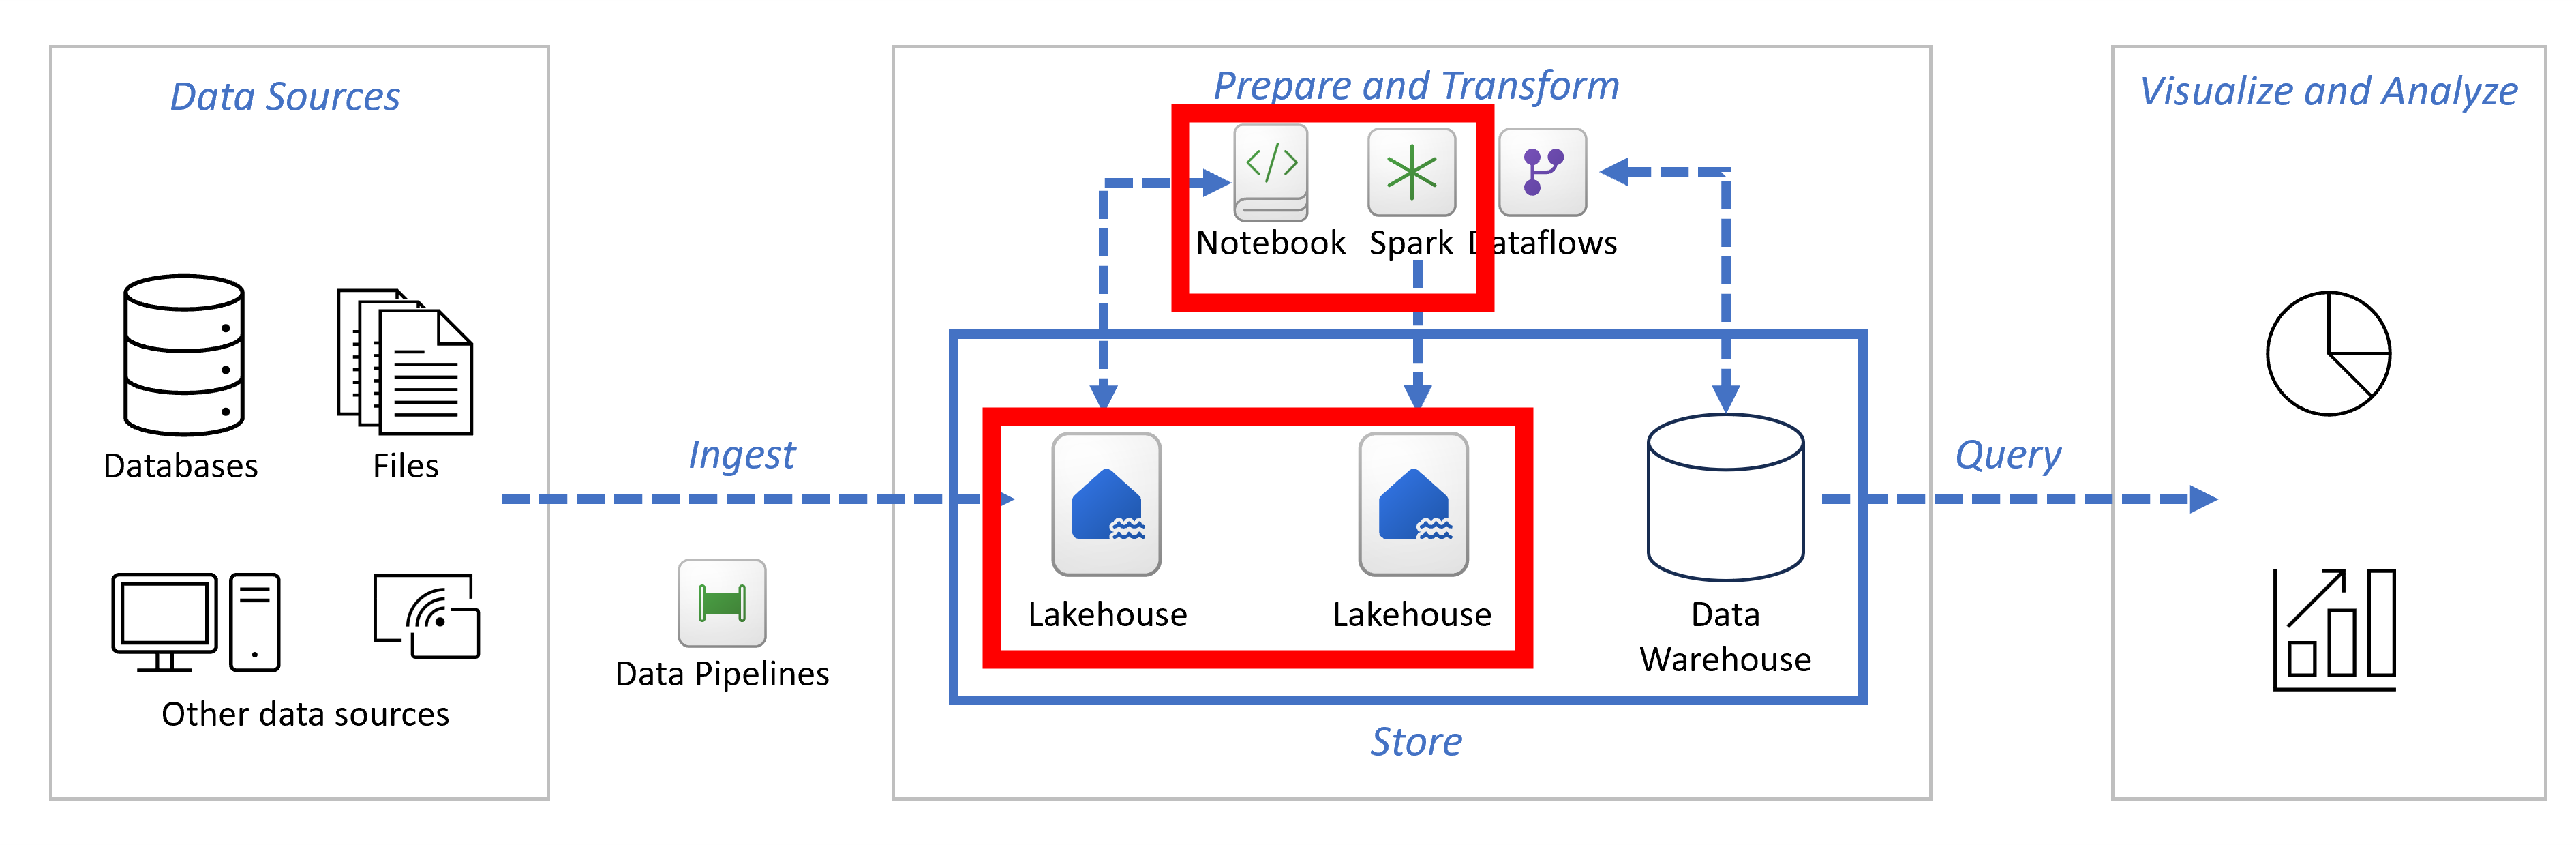
Synapse Data Engineering
Lakehouses
Notebooks
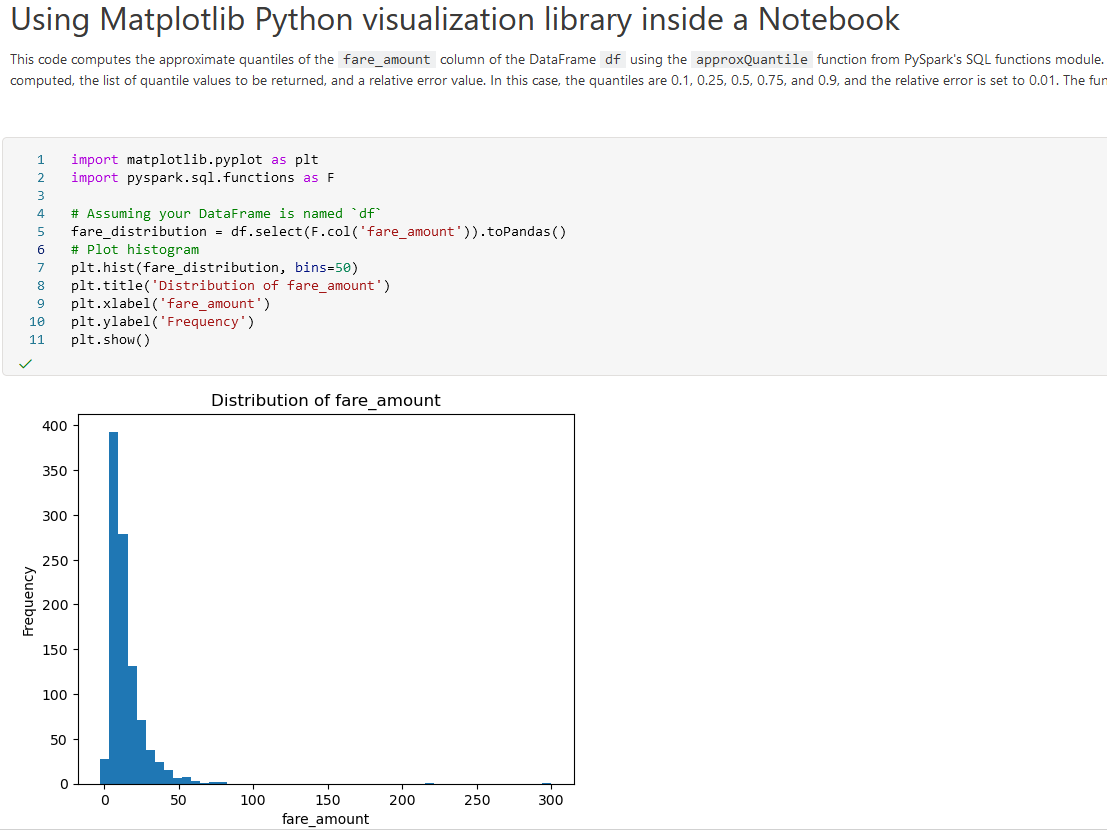
Definições de Apache Spark Job
Lakehouses
Dados estruturados (tabelas)
Dados não estruturados (arquivos)
Notebooks
Interface web interativa
Código de manipulação de dados
Visualizações de dados
Comentários / explicações
Suporte multilíngue:
PySpark (Python)
Spark (Scala)
Spark SQL (SQL)
SparkR (R)
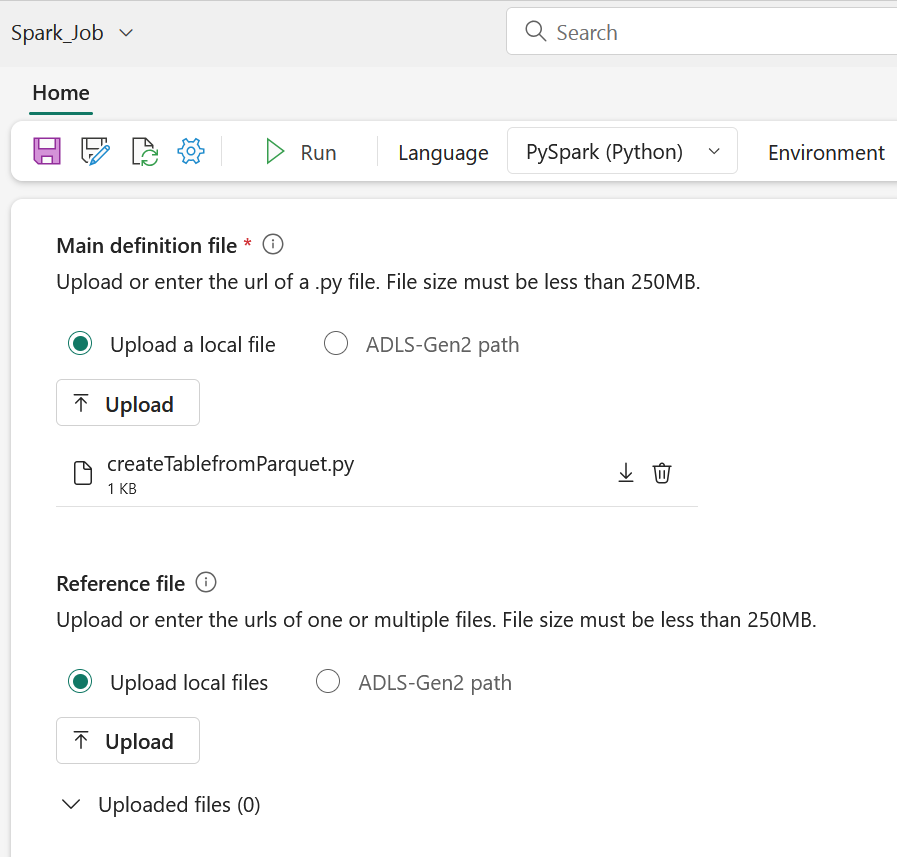
Definições de Apache Spark Job
Enviar jobs em lote/streaming para clusters Spark
Alternativa ou complemento aos Notebooks:
Notebooks para exploração, prototipagem e desenvolvimento colaborativo
Spark Job Definition para automatizar código de processamento pronto para produção
Synapse Data Warehouse
Comporta-se como um data warehouse relacional tradicional
Armazena dados no OneLake usando o formato aberto Delta Lake
Permite interoperar com outras workloads do Fabric
Sem necessidade de múltiplas cópias de dados
Escolhendo um Armazenamento de Dados
Lakehouse
Dados não estruturados (arquivos)
Spark como principal interface de desenvolvimento
Warehouse
Dados estruturados (tabelas)
T-SQL como principal interface de desenvolvimento
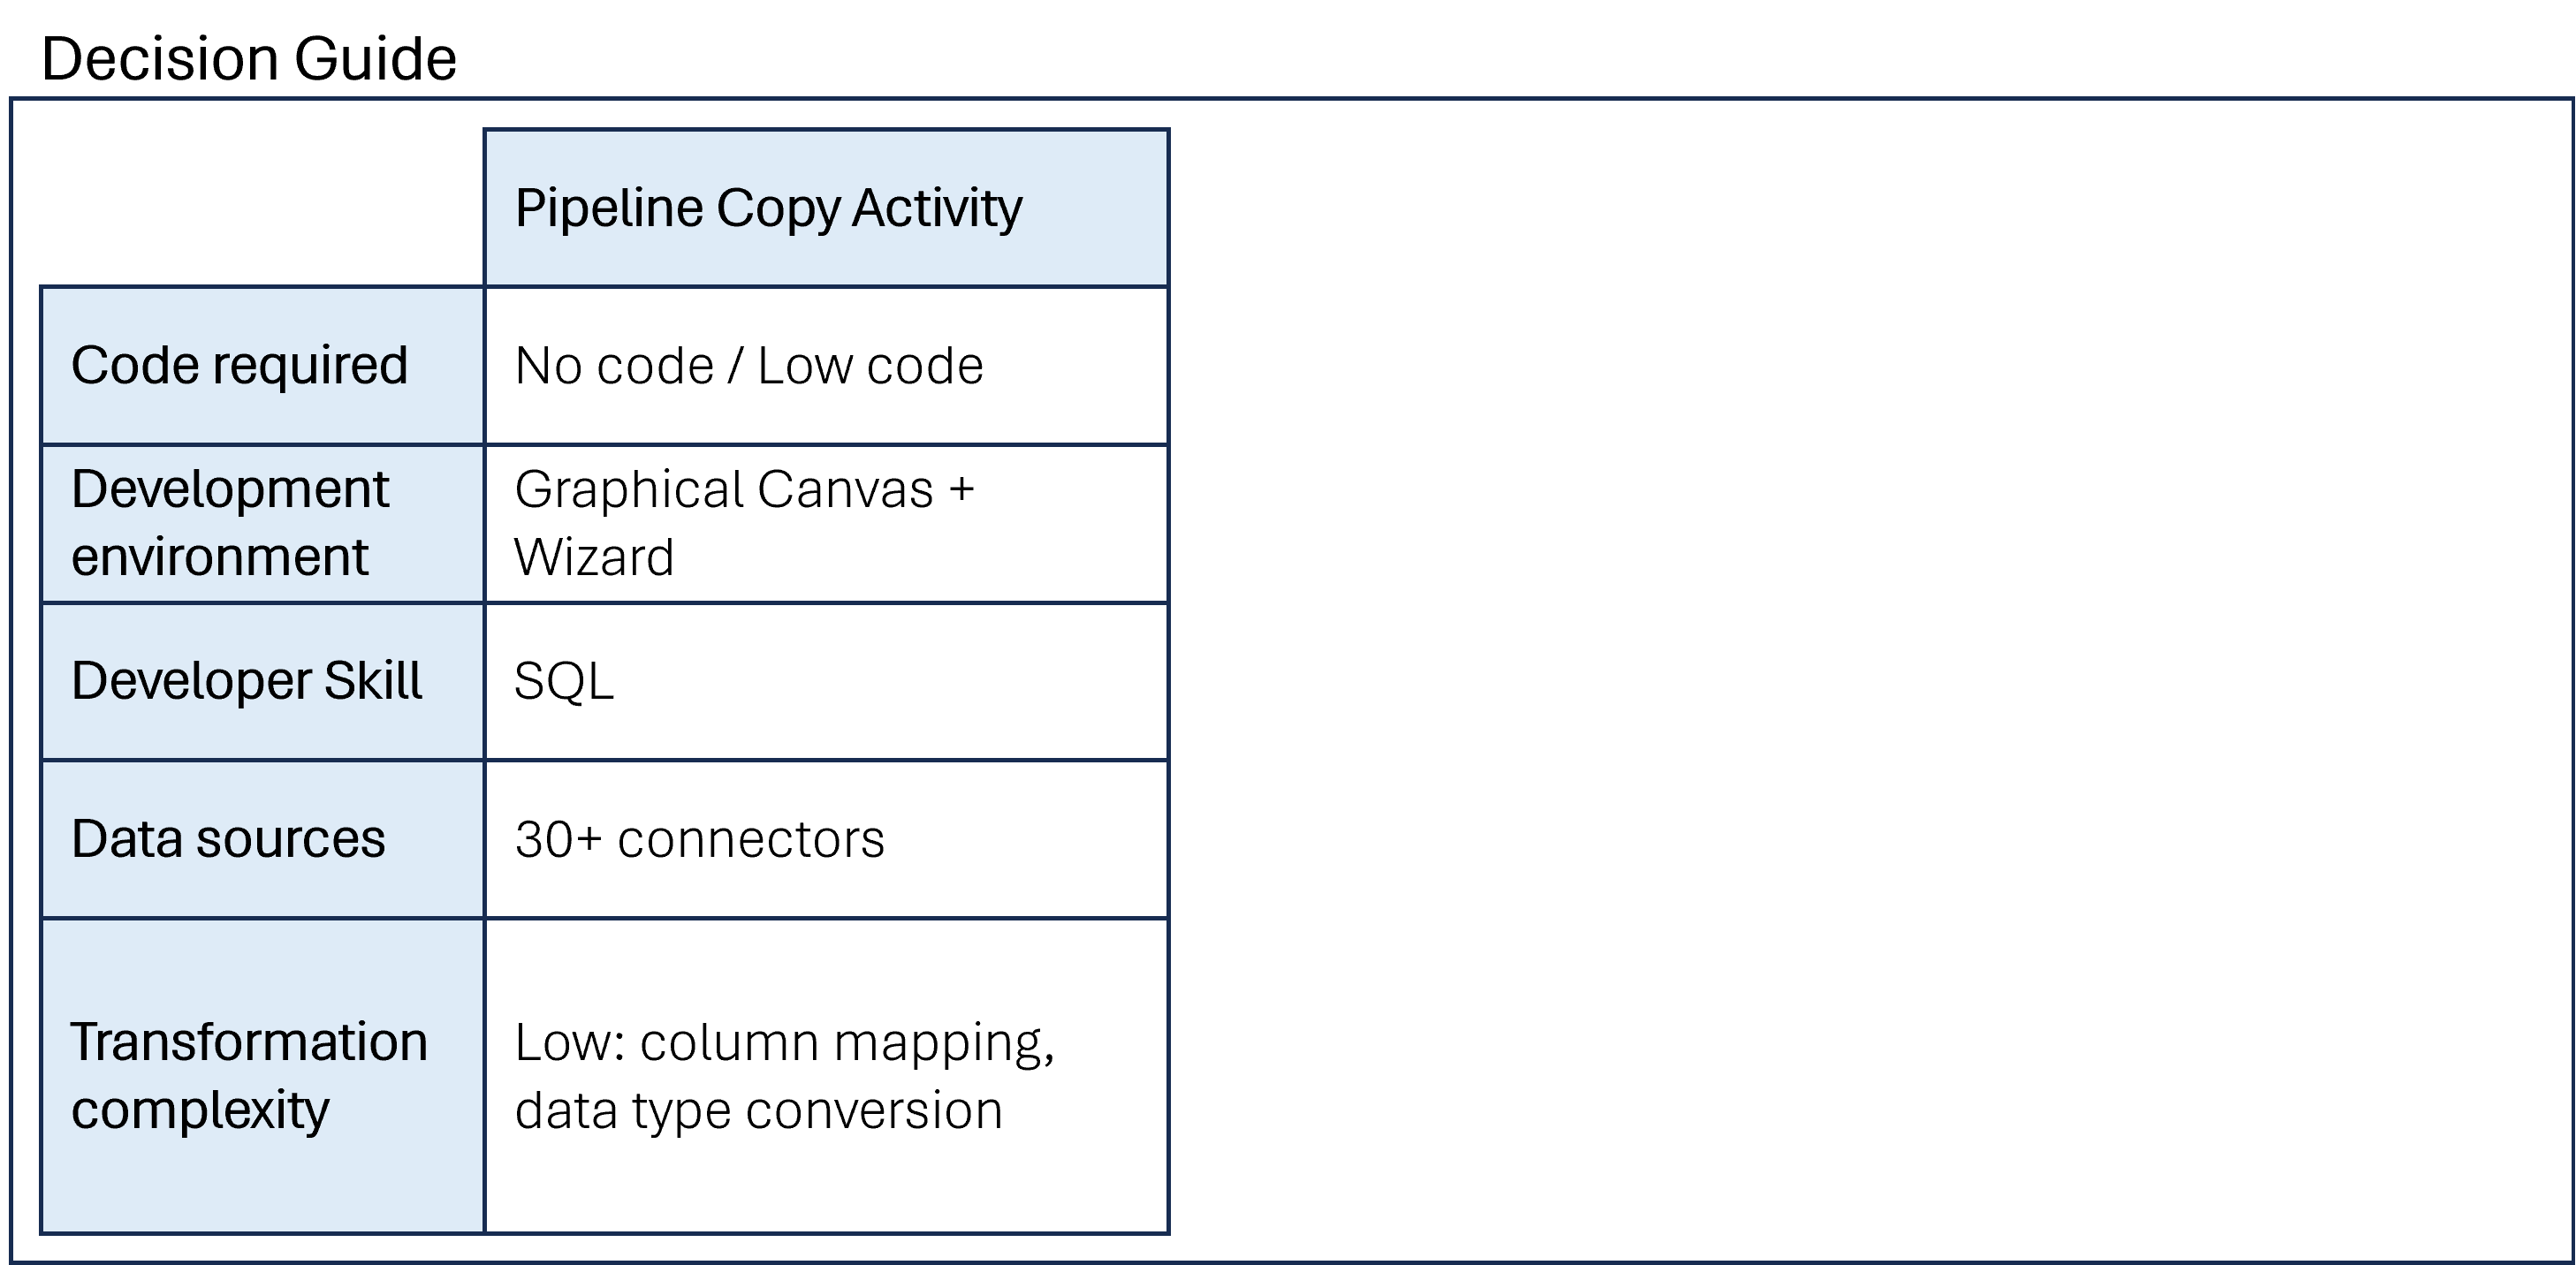
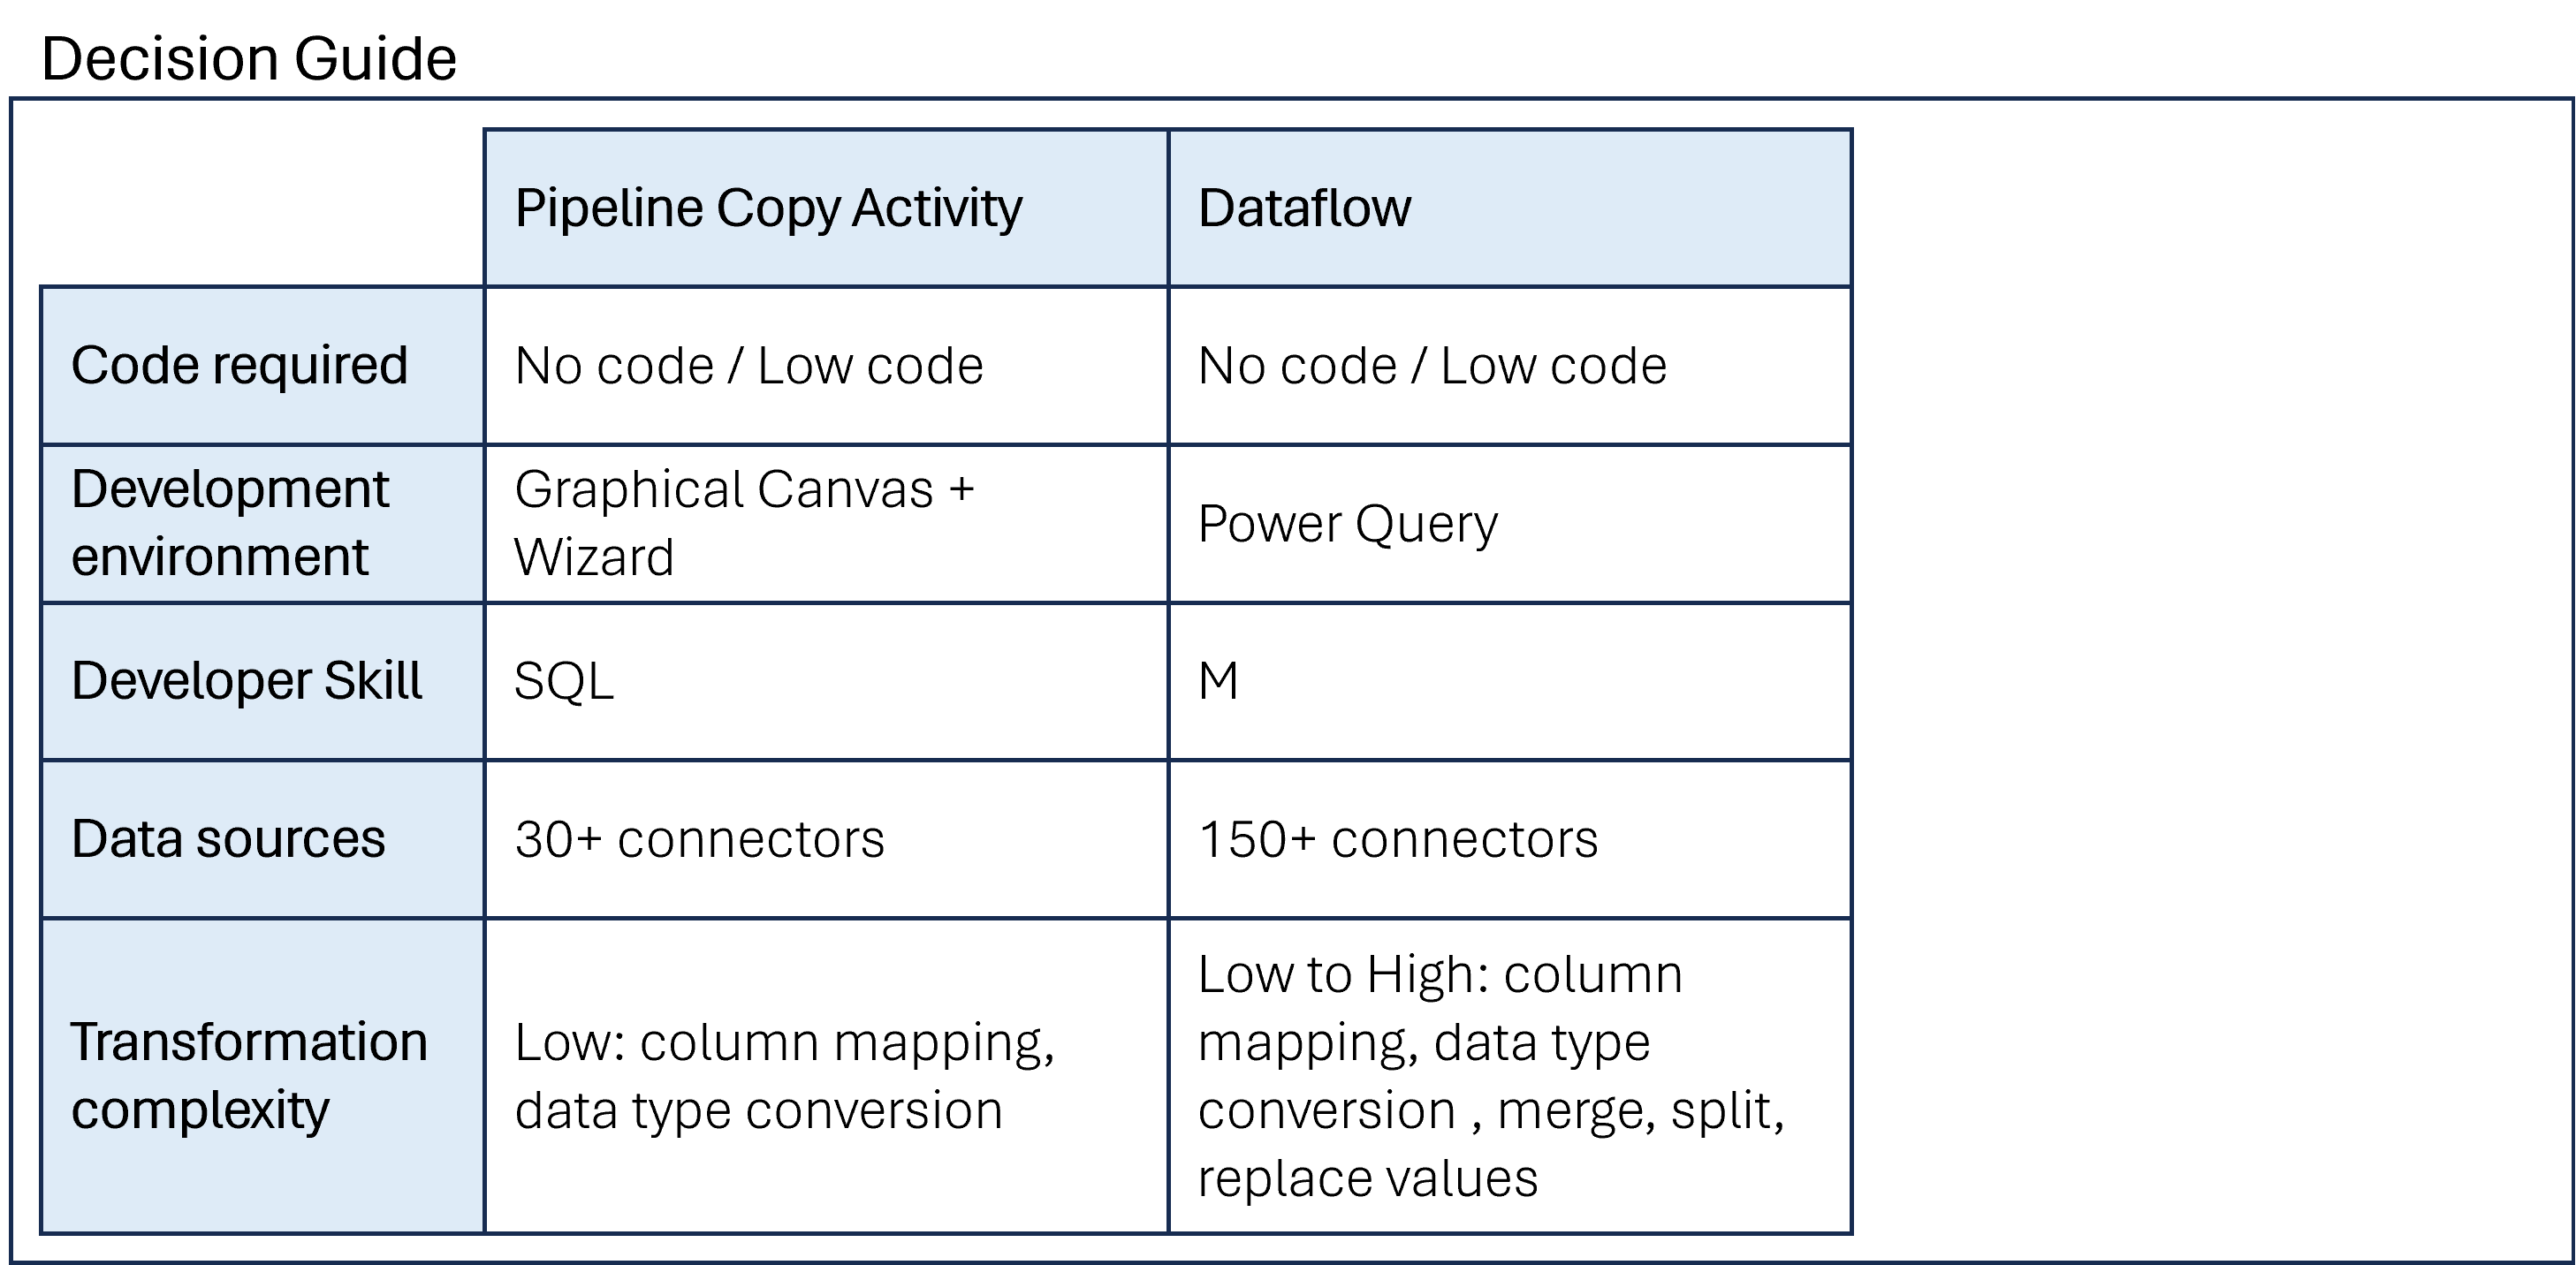
Escolhendo uma Ferramenta de Cópia de Dados
Vamos praticar!
Transforme e analise dados com o Microsoft Fabric
Preparing Video For Download...