Implementação prática do k-means

Segmentação de Clientes em Python

Karolis Urbonas

Head of Data Science, Amazon

Etapas principais

  • Pré-processamento de dados
  • Escolha do número de clusters
  • Execução do k-means nos dados pré-processados
  • Análise dos valores médios de RFM por cluster
Segmentação de Clientes em Python

Pré-processamento de dados

Concluímos o pré-processamento e temos estes dois objetos:

  • datamart_rfm
  • datamart_normalized
import numpy as np
datamart_log = np.log(datamart_rfm)

from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
scaler.fit(datamart_log)

datamart_normalized = scaler.transform(datamart_log)
Segmentação de Clientes em Python

Como definir o número de clusters

  • Método visual: critério do cotovelo
  • Método matemático: coeficiente de silhueta
  • Experimentação e interpretação
Segmentação de Clientes em Python

Executando k-means

# Importar pacote
from sklearn.cluster import KMeans
kmeans = KMeans(n_clusters=2, random_state=1)
# Rodar k-means nos dados pré-processados
kmeans.fit(datamart_normalized)
# Extrair rótulos do atributo labels_
cluster_labels = kmeans.labels_
Segmentação de Clientes em Python

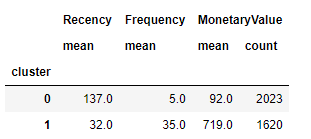
Analisando os valores médios de RFM por cluster

# Criar coluna de rótulo de cluster no DataFrame original
datamart_rfm_k2 = datamart_rfm.assign(Cluster = cluster_labels)
# Calcular valores médios de RFM e tamanho por cluster
datamart_rfm_k2.groupby(['Cluster']).agg({
    'Recency': 'mean',
    'Frequency': 'mean',
    'MonetaryValue': ['mean', 'count'],
}).round(0)
Segmentação de Clientes em Python

Analisando os valores médios de RFM por cluster

Resultado de uma solução simples com 2 clusters:
Segmentação de Clientes em Python

Vamos praticar!

Segmentação de Clientes em Python

Preparing Video For Download...