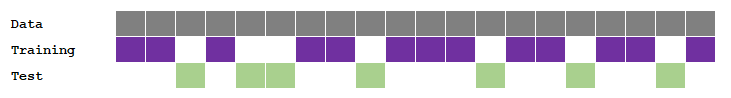
Como fazer sua árvore crescer

Machine Learning com modelos baseados em árvores em R

Sandro Raabe

Data Scientist

Conjunto de dados de diabetes

head(diabetes)
# A tibble: 6 x 9
  outcome pregnancies glucose blood_pressure skin_thickness insulin   bmi    age
  <fct>         <int>   <int>          <int>          <int>   <int> <dbl>  <int>
1 yes               6     148             72             35       0  33.6     50
2 no                1      85             66             29       0  26.6     31
3 yes               8     183             64              0       0  23.3     32
Machine Learning com modelos baseados em árvores em R

Usando o conjunto inteiro

  • Usou todos os dados no treino — não sobrou nada para testar o modelo
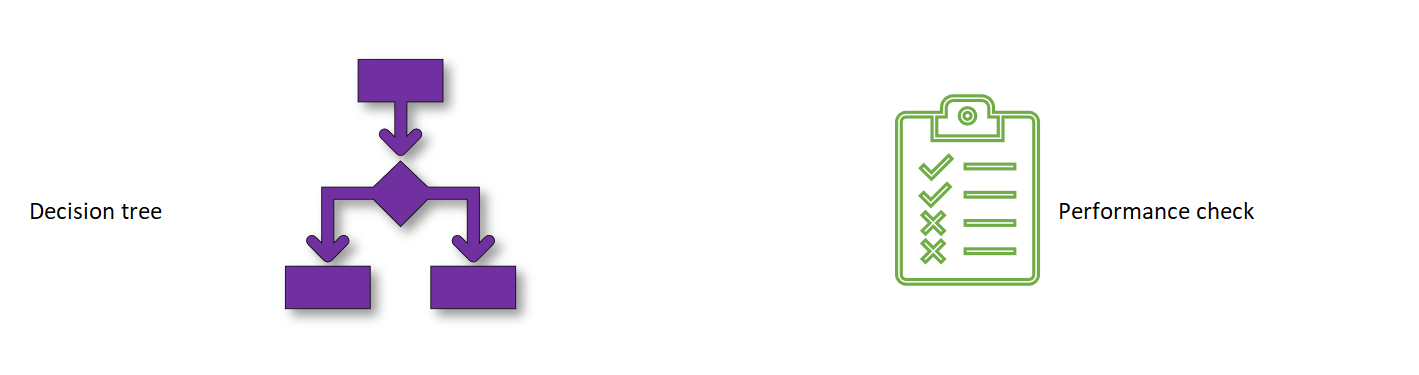
model_flow_1

Machine Learning com modelos baseados em árvores em R

Divisão dos dados

datasplit

model and evaluation

Machine Learning com modelos baseados em árvores em R

Métodos de divisão

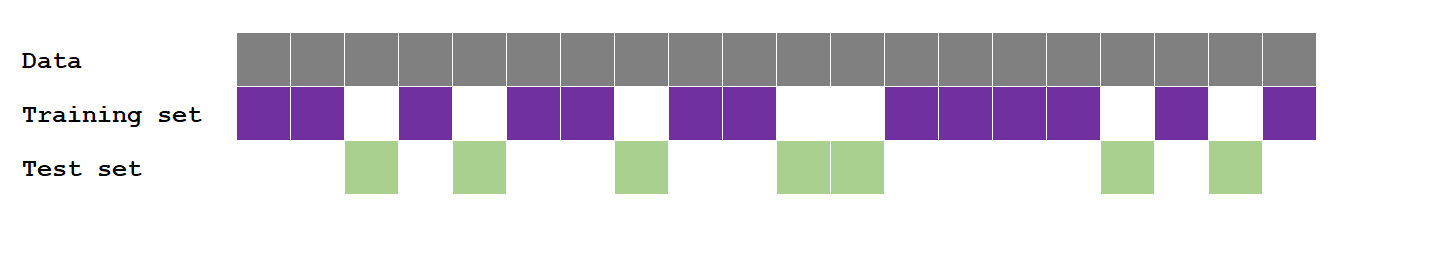
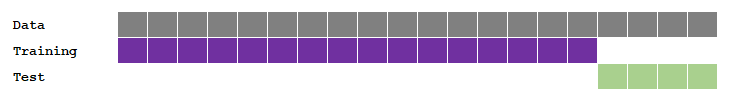
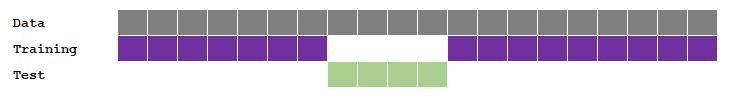
splitting methods

splitting_methods2

splitting_methods3

Machine Learning com modelos baseados em árvores em R

A função initial_split()

  • Divide os dados aleatoriamente em um único treino e um único teste
# Divide os dados proporcionalmente (padrão: 0.75)
diabetes_split <- initial_split(diabetes, prop = 0.9)
diabetes_split
<Analysis/Assess/Total>
<692/76/768>
1 do pacote rsample
Machine Learning com modelos baseados em árvores em R

Funções training() e testing()

  • Extraia os conjuntos de treino e teste de uma divisão
diabetes_train <- training(diabetes_split)

diabetes_test <- testing(diabetes_split)
  • Verificação:
    nrow(diabetes_train)/nrow(diabetes)
    
[1] 0.9007812
1 de rsample
Machine Learning com modelos baseados em árvores em R

Evite desbalanceamentos de classe

# Contagem de desfechos 'yes' e 'no' no treino
counts_train <- table(diabetes_train$outcome)
counts_train
 no yes 
490 86
# Proporção de 'yes' no treino
prop_yes_train <- counts_train["yes"]/ 
                  sum(counts_train)
prop_yes_train
0.15
# Contagem de 'yes' e 'no' no teste
counts_test <- table(diabetes_test$outcome)
counts_test
 no yes 
 28  48
# Proporção de 'yes' no teste
prop_yes_test <- counts_test["yes"]/ 
                  sum(counts_test)
prop_yes_test
0.63
Machine Learning com modelos baseados em árvores em R

Solução — impor distribuições semelhantes

initial_split(diabetes, 
              prop = 0.9, 
              strata = outcome)
  • Garante divisão aleatória com distribuição semelhante da variável outcome
Machine Learning com modelos baseados em árvores em R

Vamos dividir!

Machine Learning com modelos baseados em árvores em R

Preparing Video For Download...