Machine Learning para Marketing em Python
Karolis Urbonas
Head of Analytics & Science, Amazon
# Explore a distribuição mensal das observações
online.groupby(['InvoiceMonth']).size()
InvoiceMonth
2010-12 4893
2011-01 3580
2011-02 3648
2011-03 4764
2011-04 4148
2011-05 5018
2011-06 4669
2011-07 4610
2011-08 4744
2011-09 7189
2011-10 8808
2011-11 9513
dtype: int64
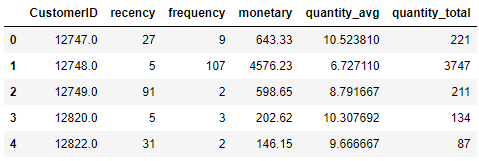
# Exclua a variável-alvo online_X = online[online['InvoiceMonth']!='2011-11']# Defina a data de referência NOW = dt.datetime(2011,11,1)# Construa os atributos features = online_X.groupby('CustomerID').agg({ 'InvoiceDate': lambda x: (NOW - x.max()).days, 'InvoiceNo': pd.Series.nunique, 'TotalSum': np.sum, 'Quantity': ['mean', 'sum'] }).reset_index()features.columns = ['CustomerID', 'recency', 'frequency', 'monetary', 'quantity_avg', 'quantity_total']
print(features.head())
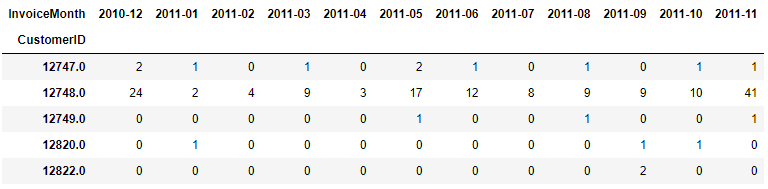
# Construa uma tabela dinâmica com transações mensais por cliente
cust_month_tx = pd.pivot_table(data=online, index=['CustomerID'],
values='InvoiceNo',
columns=['InvoiceMonth'],
aggfunc=pd.Series.nunique, fill_value=0)
print(cust_month_tx.head())
# Armazene os nomes das colunas de identificador e alvo custid = ['CustomerID'] target = ['2011-11']# Extraia a variável-alvo Y = cust_month_tx[target]# Extraia os nomes das colunas de atributos cols = [col for col in features.columns if col not in custid]# Armazene os atributos X = features[cols]
# Separe aleatoriamente 25% dos dados para teste from sklearn.model_selection import train_test_split train_X, test_X, train_Y, test_Y = train_test_split(X, Y, test_size=0.25, random_state=99)# Imprima as dimensões dos conjuntos print(train_X.shape, train_Y.shape, test_X.shape, test_Y.shape)
(2529, 5) (2529, 1) (843, 5) (843, 1)
Machine Learning para Marketing em Python