Detecção de drift univariada

Monitoramento de Machine Learning em Python

Hakim Elakhrass

CEO and co-founder

O que é detecção de drift univariada?
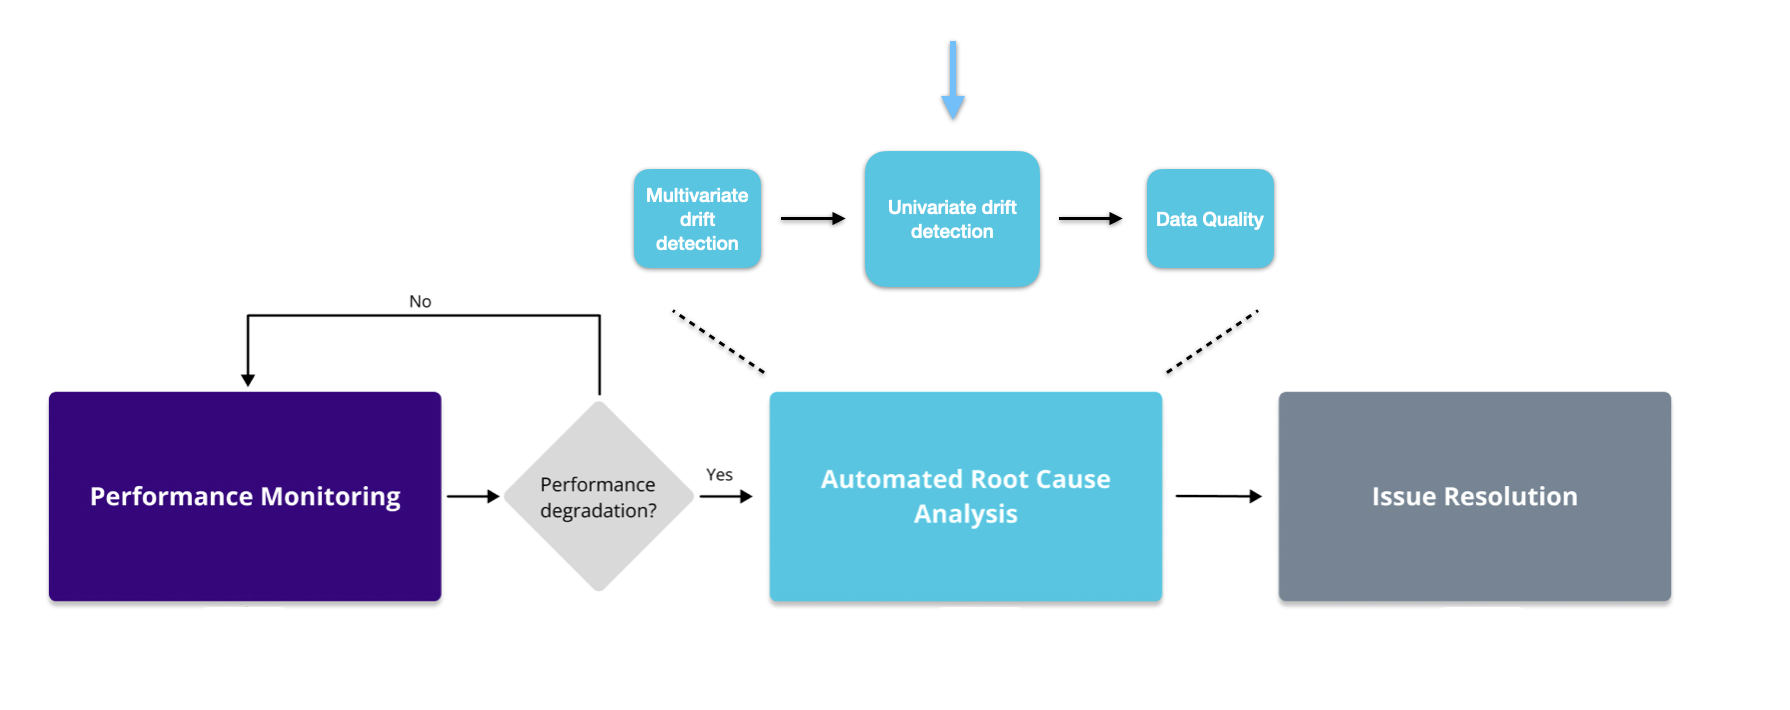
A imagem mostra o fluxo de monitoramento e onde o método univariado se encaixa.

Monitoramento de Machine Learning em Python

Métodos univariados

  • Distância de Jensen-Shannon — categóricas e contínuas
  • Hellinger — categóricas e contínuas
  • Wasserstein — apenas contínuas
  • Kolmogorov-Smirnov — apenas contínuas

  • L-infinito — apenas categóricas

  • Qui-quadrado — apenas categóricas

1 https://nannyml.readthedocs.io/en/stable/how_it_works/univariate_drift_comparison.html
Monitoramento de Machine Learning em Python

Implementação em código

# Inicializar o calculador de drift univariado
uv_calc = nannyml.UnivariateDriftCalculator(
    continuous_methods=['wasserstein', 'hellinger'],
    categorical_methods=['jensen_shannon', 'l_infinity', 'chi2'],
    column_names=feature_column_names,
    timestamp_column_name='timestamp',
    chunk_period='d'
    )
# Ajustar, calcular e plotar os resultados
uv_calc.fit(reference)
uv_results = uv_calc.calculate(analysis)
uv_results.plot().show()
Monitoramento de Machine Learning em Python

Filtragem

  • Com base nos nomes das colunas
  • Com base nos métodos univariados
# Filtrar os resultados univariados
filtered_figure = uv_results.filter(column_names=['trip_distance', 'fare_amount'], 
            methods=['jensen_shannon'])

# Plotar os resultados filtrados
filtered_figure.show().plot()
Monitoramento de Machine Learning em Python

Ranqueador por contagem de alertas

  • Ranqueia features pelo número de alertas
# Inicializar o ranqueador por contagem de alertas
alert_count_ranker = nannyml.AlertCountRanker()
alert_count_ranked_results = alert_count_ranker.rank(
    uv_results,
    only_drifting=False)
# Exibir os resultados
display(alert_count_ranked_results)
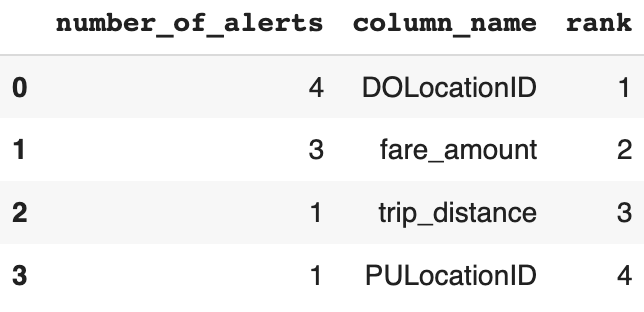
A imagem mostra o dataframe com informações sobre o número de alertas por feature específica.

Monitoramento de Machine Learning em Python

Ranqueador por correlação

  • Ranqueia features pelo quanto correlacionam com mudanças absolutas na performance
# Inicializar o ranqueador por correlação
correlation_ranker = nannyml.CorrelationRanker()
correlation_ranker.fit(perf_results.filter(period='reference'))
correlation_ranked_results = correlation_ranker.rank(uv_results, perf_results)

# Exibir os resultados
display(correlation_ranked_results)
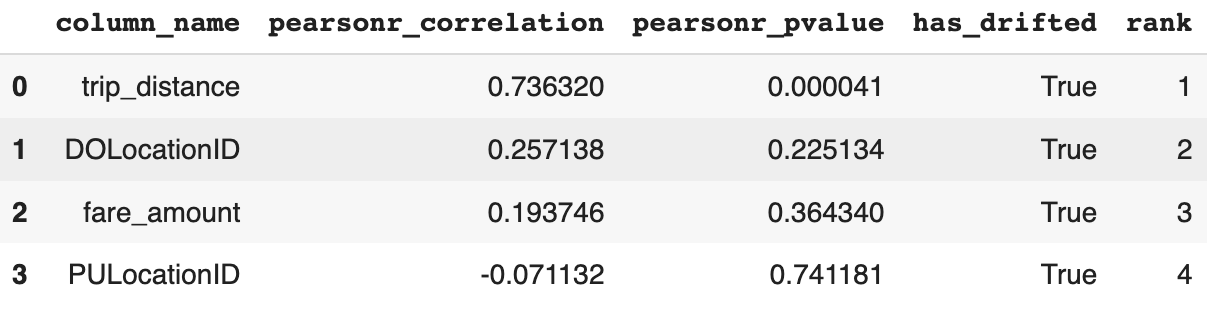
A imagem mostra o dataframe com correlação de Pearson e p-valor para cada feature.

Monitoramento de Machine Learning em Python

Monitorar a distribuição das features

  • Gera melhores insights e melhora a explicabilidade
# Criar gráficos de distribuição
distribution_results = uv_results.plot(kind='distribution')

# Mostrar os gráficos
distribution_results.show()
Monitoramento de Machine Learning em Python

Gráfico de distribuição das features


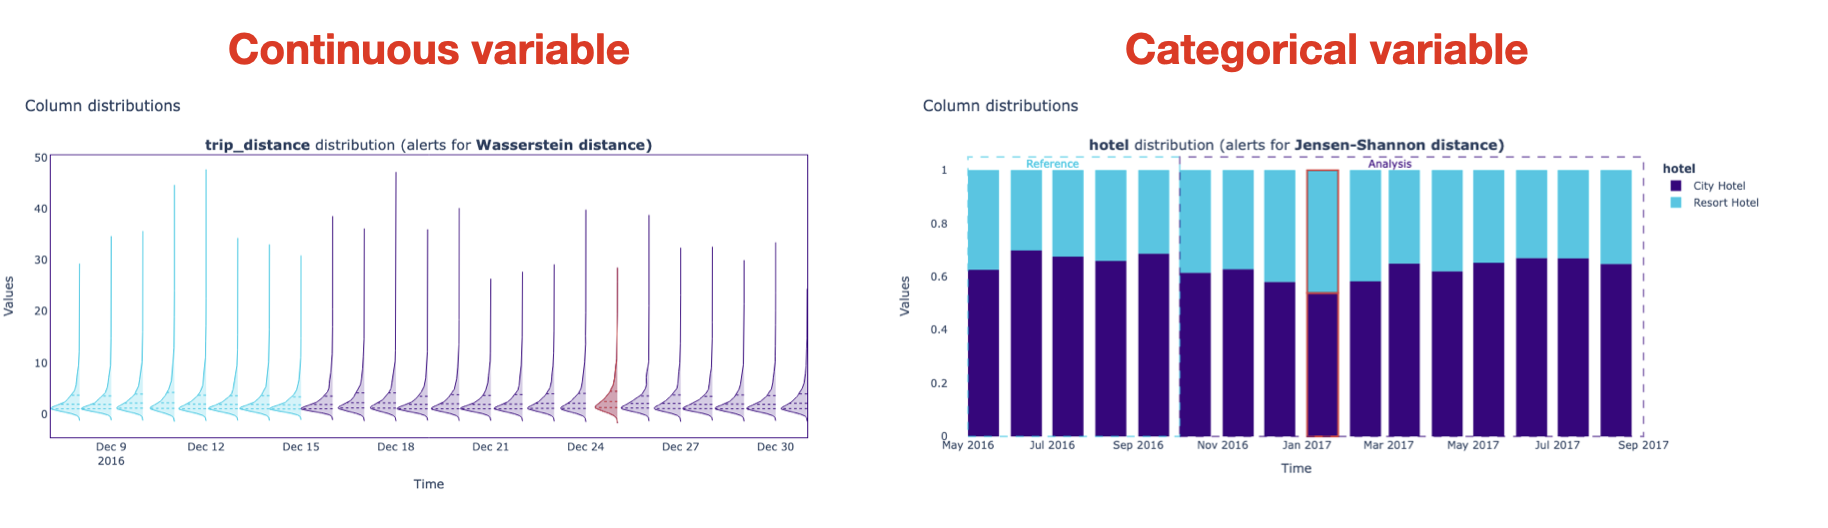
A imagem mostra gráficos de distribuição para features contínuas e categóricas.

Monitoramento de Machine Learning em Python

Vamos praticar!

Monitoramento de Machine Learning em Python

Preparing Video For Download...