Preparação de dados para NannyML

Monitoramento de Machine Learning em Python

Hakim Elakhrass

Co-founder and CEO of NannyML

Carregando os dados
dataset_name = "green_taxi_dataset.csv"
data = pd.read_csv(dataset_name)
data.head()

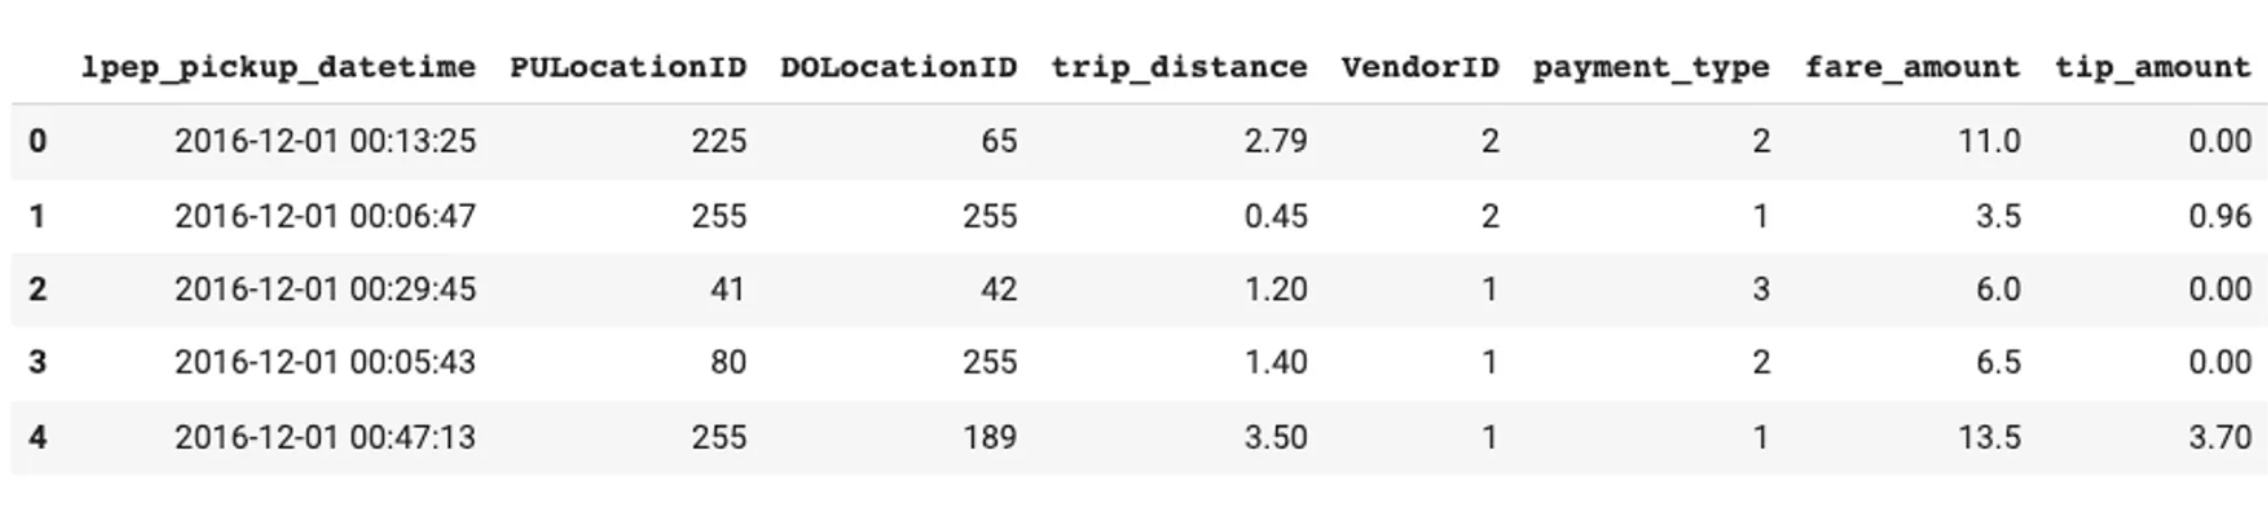
A imagem é uma captura das cinco primeiras linhas do conjunto de dados.

Monitoramento de Machine Learning em Python

Processando os dados

# Create data partition
data['partition'] = pd.cut(
    data['lpep_pickup_datetime'],
    bins= [pd.to_datetime('2016-12-01'),
           pd.to_datetime('2016-12-08'),
           pd.to_datetime('2016-12-16'),
           pd.to_datetime('2017-01-01')],
    right=False,
    labels= ['train', 'test', 'prod']
)
Monitoramento de Machine Learning em Python

Dividindo os dados

# Target column name
target = 'tip_amount'
# Features column name
features = ["PULocationID", "DOLocationID", "trip_distance", "VendorID", "pickup_time"]
# Train set
X_train = data.loc[data['partition'] == 'train', features]
y_train = data.loc[data['partition'] == 'train', target]

# Test set (later reference set)
X_test = data.loc[data['partition'] == 'test', features]
y_test = data.loc[data['partition'] == 'test', target]

# Production set (later analysis set)
X_prod = data.loc[data['partition'] == 'prod', features]
y_prod = data.loc[data['partition'] == 'prod', target]
Monitoramento de Machine Learning em Python

Construindo o modelo

  • Treinar LGBMRegressor usando a biblioteca lightgbm
  • Avaliar o modelo no conjunto de teste
  • Colocar o modelo em produção
# Training the model
model = LGBMRegressor(random_state=42)
model.fit(X_train, y_train)

# Making predictions
y_pred_train = model.predict(X_train)
y_pred_test = model.predict(X_test)

# Evaluating the model on train and test set
mae_train = MAE(y_train, y_pred_train)
mae_test = MAE(y_test, y_pred_test)

# Deploying the model to production
y_pred_prod = model.predict(X_prod)
Monitoramento de Machine Learning em Python

Criando conjuntos de referência e análise

Período de referência

  • Usa um conjunto de teste

  • Exige ground truth

  • Define a performance de base

Período de análise

  • Dados mais recentes de produção

  • Ground truth é opcional

  • NannyML analisa drift de dados e performance

# Creating reference set
reference = X_test.copy() # Test set features
reference['y_pred'] = y_pred_test # Predictions
reference['tip_amount'] = y_test # Labels
reference = reference.join(
    data['lpep_pickup_datetime']) # Timestamp
# Creating analysis set
analysis = X_prod.copy() # Production features
analysis['y_pred'] = y_pred_prod # Predictions
analysis = analysis.join(
    data['lpep_pickup_datetime']) # Timestamp
Monitoramento de Machine Learning em Python

Exemplo de conjunto de referência

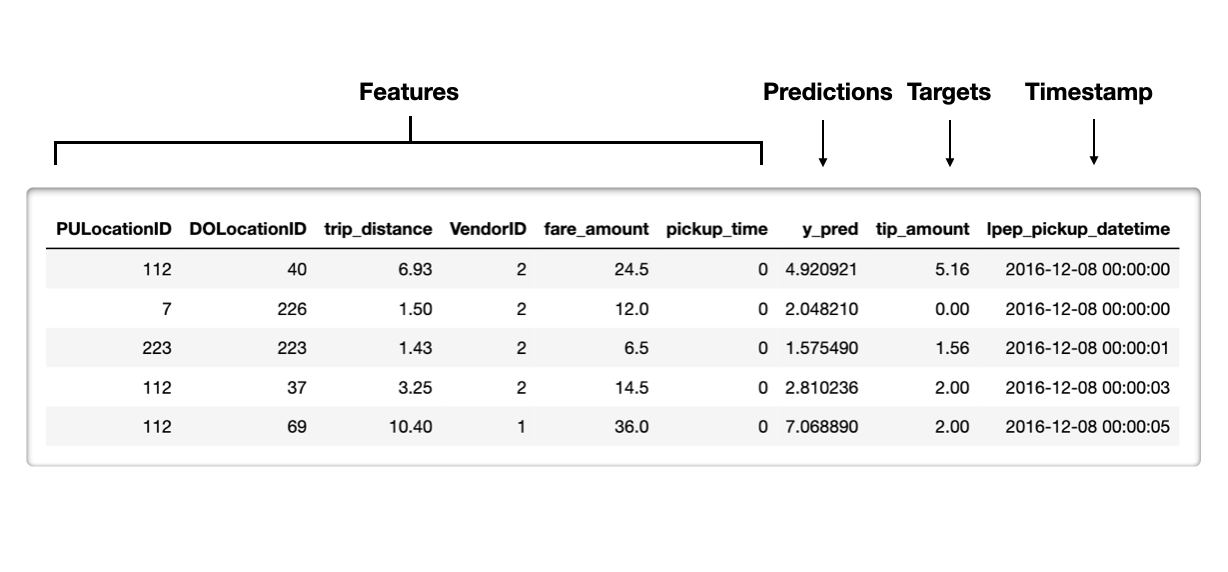
  • Timestamp — instante em que a observação ocorreu (opcional)
  • Features — variáveis usadas no modelo
  • Saídas do modelo
    • Predictions — pontuação prevista pelo modelo
    • Prediction class labels — probabilidades limiarizadas
  • Target — contém o ground truth

A imagem mostra as cinco primeiras linhas do conjunto de referência.

Monitoramento de Machine Learning em Python

Vamos praticar!

Monitoramento de Machine Learning em Python

Preparing Video For Download...