Codificando dados categóricos usando aprendizado supervisionado
Feature Engineering em R

Jorge Zazueta
Research Professor and Head of the Modeling Group at the School of Economics, UASLP
Introdução à codificação supervisionada
A codificação supervisionada, por sua vez, usa os valores do desfecho para criar recursos numéricos a partir de preditores nominais.
Introdução à codificação supervisionada
A codificação supervisionada usa os valores do desfecho para criar recursos numéricos a partir de preditores nominais.
Algumas funções de codificação supervisionada disponíveis no pacote embed
| Function | Definition |
|---|---|
| step_lencode_glm() | Usa codificações por verossimilhança para converter um preditor nominal em um único conjunto de pontuações derivadas de um modelo linear generalizado. |
| step_lencode_bayes() | Aplica codificações bayesianas de verossimilhança para converter um preditor nominal em um único conjunto de pontuações derivadas de um modelo linear generalizado estimado por análise bayesiana. |
| step_lencode_mixed() | Converte preditores nominais em um único conjunto de pontuações derivadas de um modelo linear generalizado misto. |
Prevendo o sucesso de pedidos de bolsa
Queremos prever o sucesso de pedidos de bolsa usando apenas o código do patrocinador.
lr_model <- logistic_reg() # declare model

lr_recipe_glm <- # Set recipe glm
  recipe(class ~ sponsor_code,
         data = grants_train) %>%
  step_lencode_glm(sponsor_code,
                   # Declare outcome variable
                   outcome = vars(class))

lr_workflow_glm <- # Create Workflow
  workflow() %>%
  add_model(lr_model) %>%
  add_recipe(lr_recipe_glm)
Resumo do workflow
lr_workflow_glm
-- Workflow ------------------------------------
Preprocessor: Recipe
Model: logistic_reg()

-- Preprocessor --------------------------------
1 Recipe Step

- step_lencode_glm()

-- Model --------------------------------------
Logistic Regression Model Specification (classification)

Computational engine: glm
Ajustar, aumentar e avaliar
Ajustamos e avaliamos nosso modelo
lr_fit_glm <- # Fit
  lr_workflow_glm %>%
  fit(grants_train)

lr_aug_glm <- # Augment
  lr_fit_glm %>%
  augment(grants_test)

glm_model <- lr_aug_glm %>% # Assess
  class_evaluate(truth = class,
                 estimate = .pred_class,
                 .pred_successful)
Os resultados de desempenho ficam em glm_model
glm_model
# A tibble: 2 × 3
  .metric  .estimator .estimate
  <chr>    <chr>          <dbl>
1 accuracy binary         0.728
2 roc_auc  binary         0.684
Unindo os modelos
Criamos bayes_model e mixed_model para comparar o desempenho dos passos correspondentes.
# Define model names
model <- c("glm", "glm",
           "bayes","bayes",
           "mixed", "mixed")
# Bind models in a tibble
models <-
bind_rows(glm_model,
          bayes_model,
          mixed_model)%>%
  add_column(model = model)%>%
  select(-.estimator) %>%
  spread(model,.estimate)
Uma tabela de desempenho prática
models
# A tibble: 2 × 4
  .metric  bayes   glm mixed
  <chr>    <dbl> <dbl> <dbl>
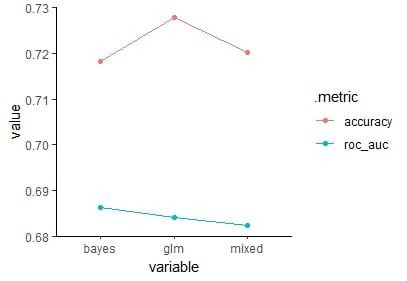
1 accuracy 0.718 0.728 0.720
2 roc_auc  0.686 0.684 0.682
Visualizando os resultados
Visualize os resultados em um gráfico de coordenadas paralelas do pacote GGally.
# Libraries
library(GGally)

# Parallel coordinates chart
ggparcoord(models,
           columns = 2:4,
           groupColumn = 1,
           scale="globalminmax",
           showPoints = TRUE)
Gráfico de coordenadas paralelas de accuracy e roc_auc comparando todos os modelos.
Vamos praticar!
Feature Engineering em R

