Inferência para Dados Numéricos em R
Mine Cetinkaya-Rundel
Associate Professor of the Practice, Duke University
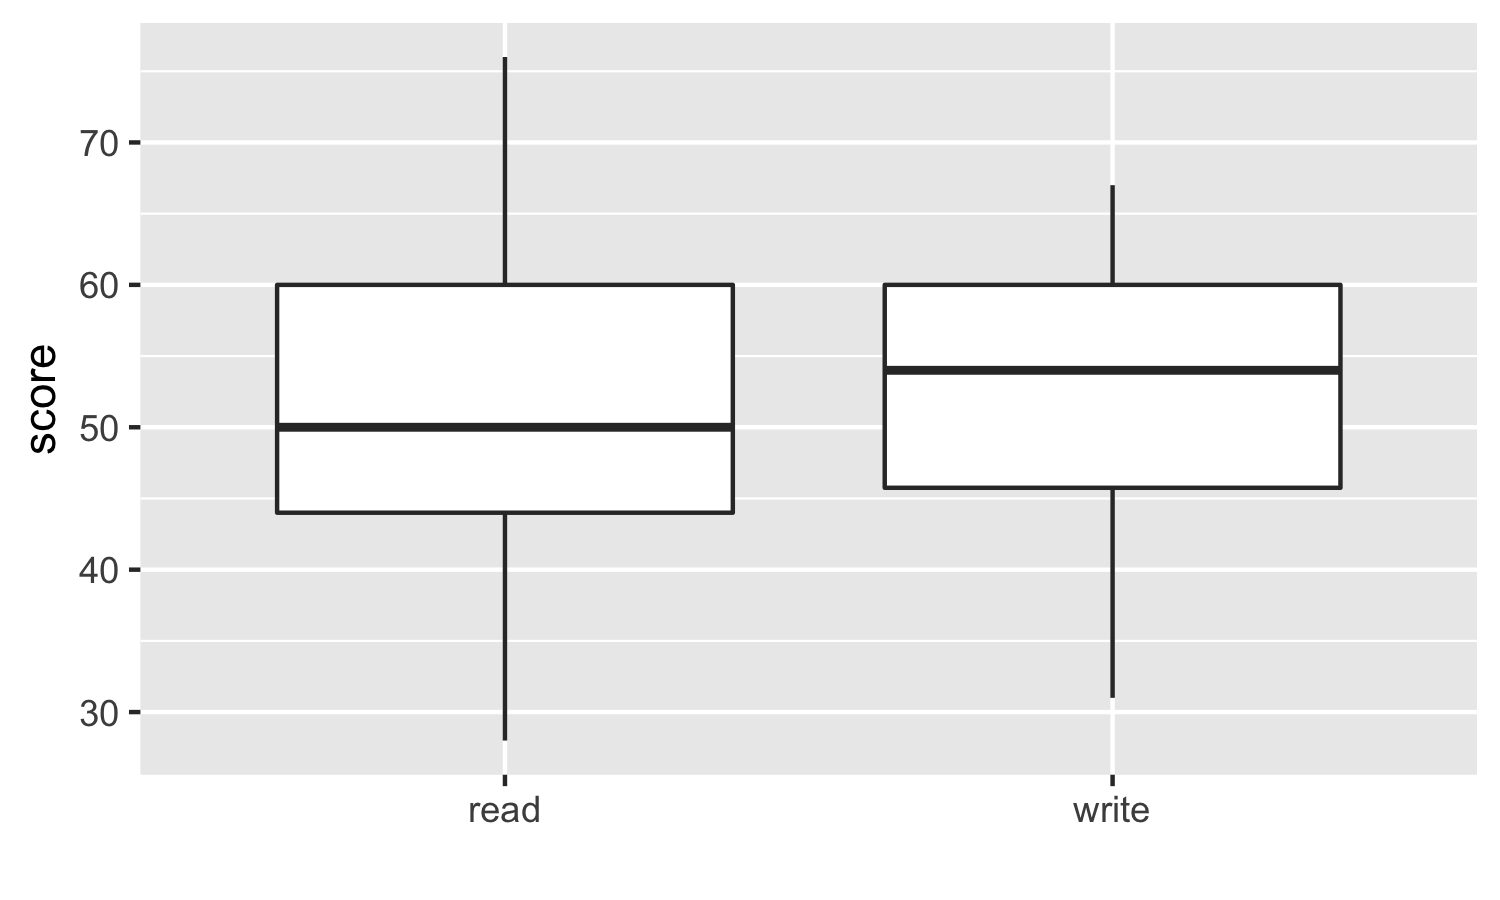
200 observações foram amostradas aleatoriamente da pesquisa High School and Beyond. Os mesmos alunos fizeram testes de leitura e escrita. À primeira vista, como as distribuições das notas de leitura e escrita são parecidas? E como diferem?

As notas de leitura e escrita de um mesmo aluno podem ser consideradas independentes?
Provavelmente não!
Quando dois conjuntos de observações têm essa correspondência especial (não são independentes), dizemos que são pareados.
Para analisar dados pareados, é útil olhar a diferença nos resultados de cada par de observações:
diff = read − write.
| student | read | write | diff |
|---|---|---|---|
| 1 | 57 | 52 | 5 |
| 2 | 68 | 59 | 9 |
| 3 | 44 | 33 | 11 |
| ... | ... | ... | ... |
| 200 | 63 | 65 | -2 |
Construa um intervalo de confiança de 95% para a diferença média entre as notas de leitura e escrita.
t.test(hsb2$diff, conf.level = 0.95)
Construa um intervalo de confiança de 95% para a diferença média entre as notas de leitura e escrita.
t.test(hsb2$diff, conf.level = 0.95)
One Sample t-test
data: hsb2$diff
t = -0.86731, df = 199, p-value = 0.3868
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
-1.7841424 0.6941424
sample estimates:
mean of x
-0.545
O IC de 95% para a diferença média das notas de leitura e escrita (read - write) é (-1.78, 0.69).
vs.
Temos 95% de confiança de que a média de leitura está de 1,78 pontos abaixo até 0,69 pontos acima da média de escrita.
Inferência para Dados Numéricos em R