Pipelines de aprendizado supervisionado
Projetando Workflows de Machine Learning em Python

Dr. Chris Anagnostopoulos
Honorary Associate Professor
Dados rotulados
- Variáveis de atributos (abreviação:
X) - Rótulos ou classe (abreviação:
y)
credit_scoring.head(4)
  checking_status  duration  ...  foreign_worker class
0            '<0'         6  ...             yes  good
1      '0<=X<200'        48  ...             yes   bad
2   'no checking'        12  ...             yes  good
3            '<0'        42  ...             yes  good
Engenharia de atributos
- A maioria dos classificadores espera atributos numéricos
- É preciso converter colunas de texto em números
Pré-processe usando LabelEncoder de sklearn.preprocessing:
le = LabelEncoder()
le.fit_transform(credit_scoring['checking_status'])[:4]
array([1, 0, 3, 1])
Ajuste do modelo
.fit(features, labels).predict(features)
features, labels = credit_scoring.drop('class', 1), credit_scoring['class']model_nb = GaussianNB() model_nb.fit(features, labels) model_nb.predict(features.head(5))
['good' 'bad' 'good' 'bad' 'good']
60% de acurácia nos 5 primeiros exemplos.
Seleção de modelo
.fit()otimiza os parâmetros do modelo escolhido- E quanto a outros modelos?
AdaBoostClassifier supera GaussianNB nos cinco primeiros pontos:
model_ab = AdaBoostClassifier()
model_ab.fit(features, labels)
model_ab.predict(features.head(5))
numpy.array(labels[0:5])
['good' 'bad' 'good' 'good' 'bad']
['good' 'bad' 'good' 'good' 'bad']
Avaliação de desempenho
Amostras maiores $\Rightarrow$ estimativas de acurácia melhores:
from sklearn.metrics import accuracy_score
accuracy_score(labels, model_nb.predict(features)) # naive bayes
0.706
accuracy_score(labels, model_ab.predict(features)) # adaboost
0.802
O que há de errado nesse cálculo?
Overfitting e divisão dos dados
Overfitting: um modelo sempre terá desempenho melhor nos dados de treino do que em dados novos.
Treine em X_train, y_train e avalie a acurácia em X_test, y_test:
from sklearn.model_selection import train_test_split X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)GaussianNB().fit(X_train, y_train).predict(X_test)
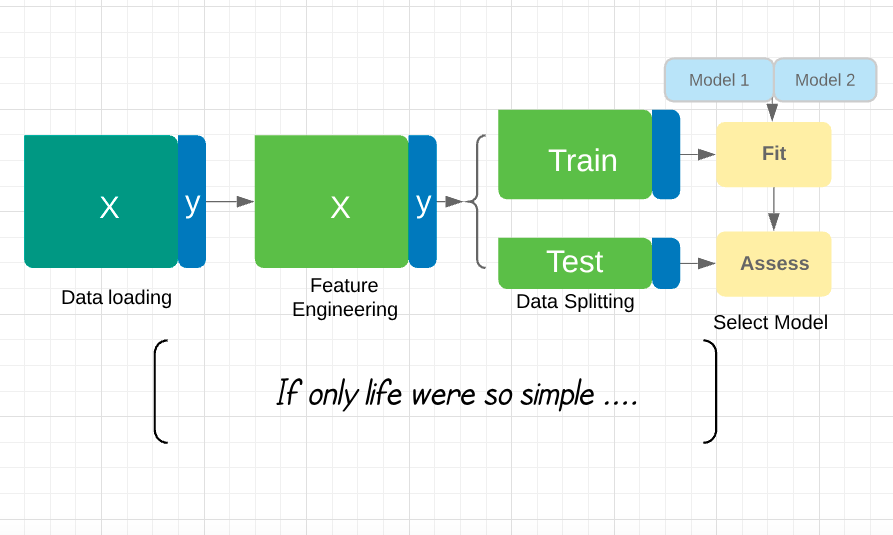
Então, sobre o que é este curso?
- Maneiras escaláveis de ajustar seu pipeline.
- Garantir que suas previsões sejam relevantes envolvendo especialistas de domínio.
- Garantir que seu modelo continue bom ao longo do tempo.
- Ajustar modelos quando você não tem rótulos suficientes.
Você poderia ter evitado a crise das hipotecas?
Projetando Workflows de Machine Learning em Python

