Funções de perda Parte I

Projetando Workflows de Machine Learning em Python

Dr. Chris Anagnostopoulos

Honorary Associate Professor

O conjunto de dados KDD '99 cup

kdd.iloc[0]
kdd.iloc[0]
duration                         51
protocol_type                   tcp
service                        smtp
flag                             SF
src_bytes                      1169
dst_bytes                       332
land                              0
...
dst_host_rerror_rate              0
dst_host_srv_rerror_rate          0
label                          good
Projetando Workflows de Machine Learning em Python

Falsos positivos vs falsos negativos

Binarizar rótulo:

kdd['label'] = kdd['label'] == 'bad'

Ajustar um classificador Gaussian Naive Bayes:

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
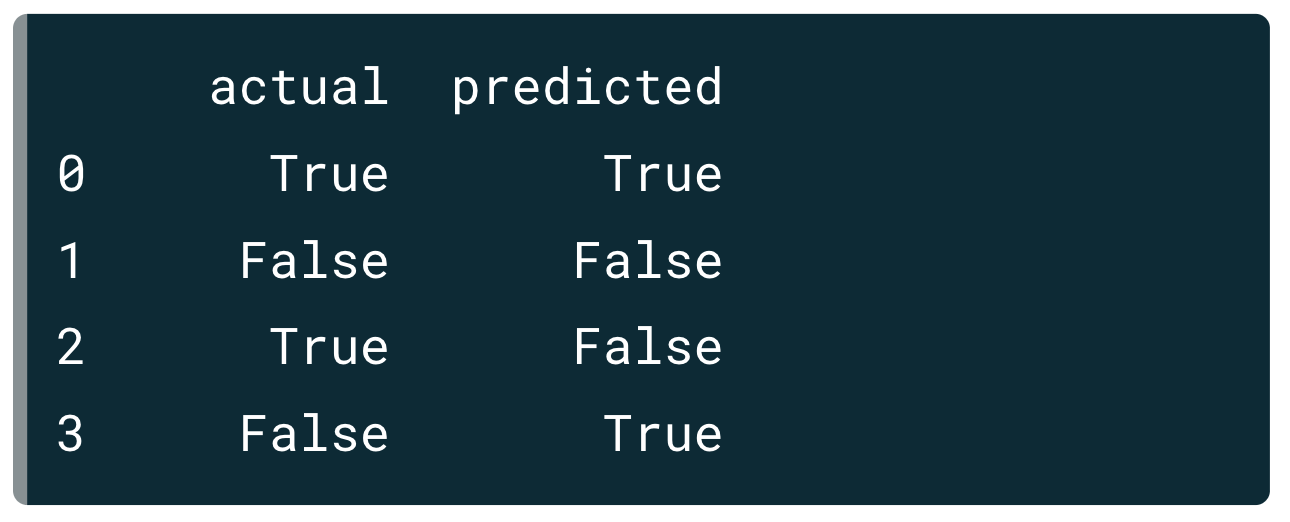
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

Projetando Workflows de Machine Learning em Python

Falsos positivos vs falsos negativos

Binarizar rótulo:

kdd['label'] = kdd['label'] == 'bad'

Ajustar um classificador Gaussian Naive Bayes:

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

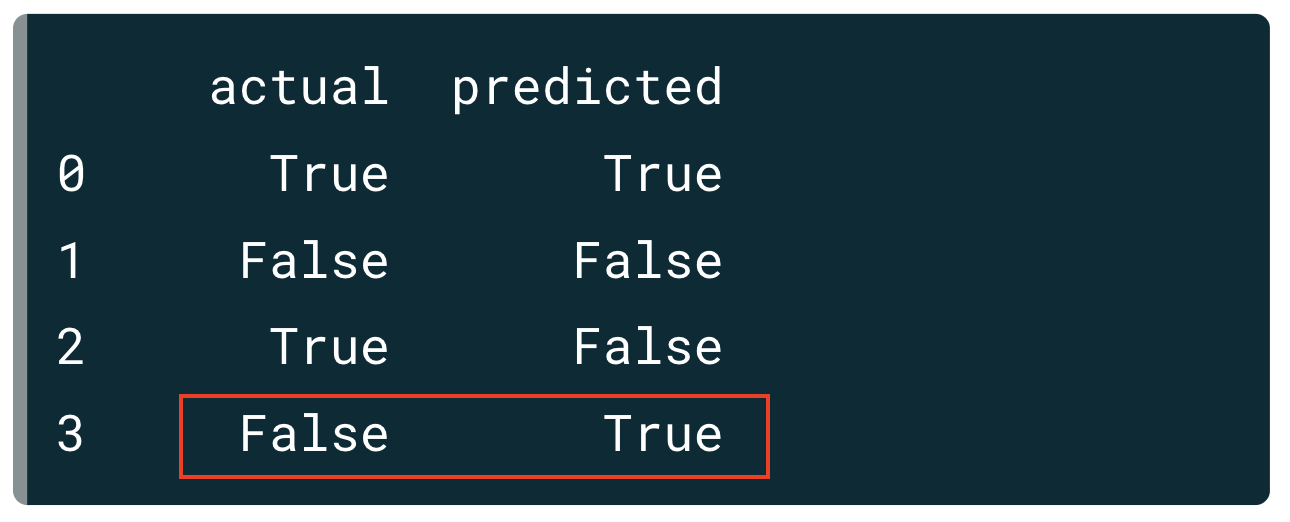
Há quatro configurações possíveis de rótulos vs previsões: ambos True, ambos False, rótulo True com previsão False e rótulo False com previsão True. Esta última combinação está destacada aqui.

Projetando Workflows de Machine Learning em Python

Falsos positivos vs falsos negativos

Binarizar rótulo:

kdd['label'] = kdd['label'] == 'bad'

Ajustar um classificador Gaussian Naive Bayes:

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

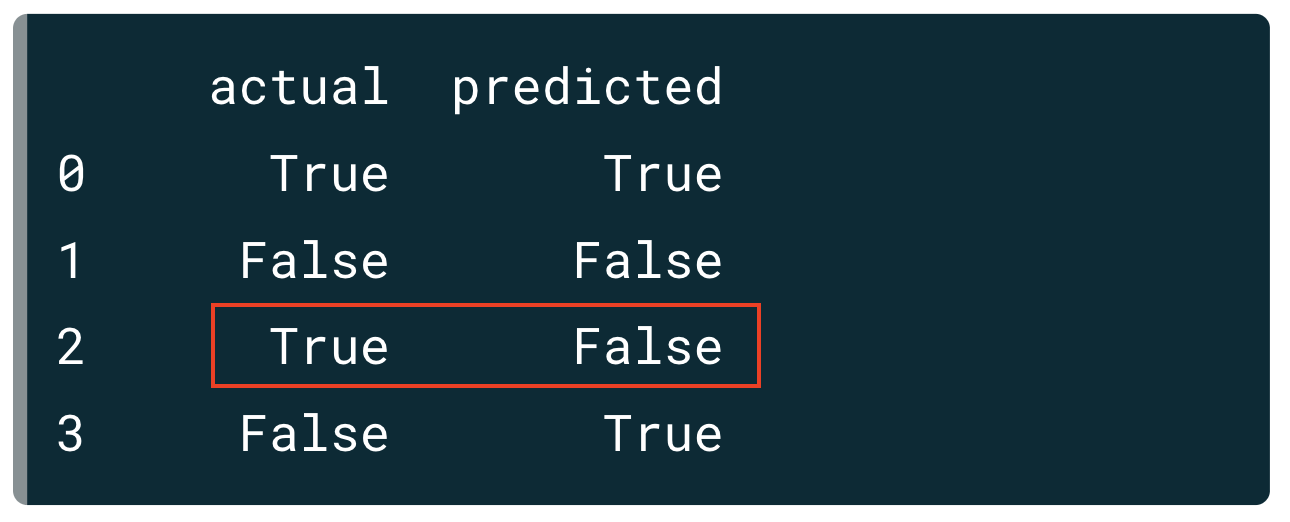
Agora, a combinação rótulo True e previsão False está destacada.

Projetando Workflows de Machine Learning em Python

Falsos positivos vs falsos negativos

Binarizar rótulo:

kdd['label'] = kdd['label'] == 'bad'

Ajustar um classificador Gaussian Naive Bayes:

clf = GaussianNB().fit(X_train, y_train)
predictions = clf.predict(X_test)
results = pd.DataFrame({
    'actual': y_test,
    'predicted': predictions
})

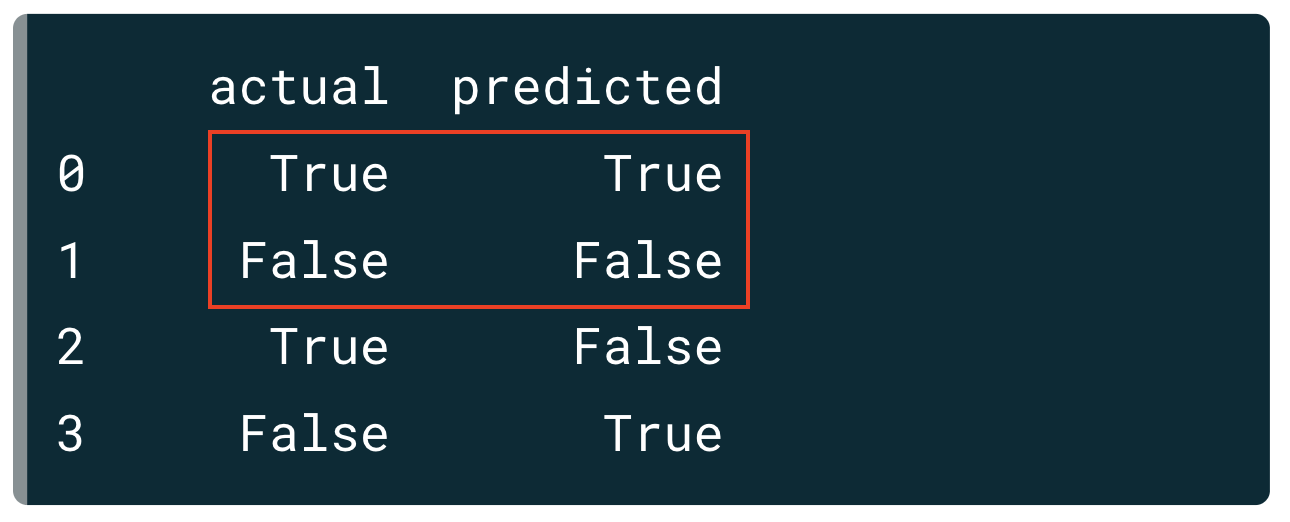
Agora, os dois casos em que a previsão concorda com os rótulos estão destacados.

Projetando Workflows de Machine Learning em Python

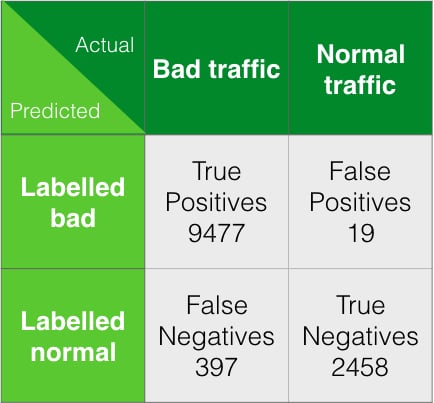
A matriz de confusão

conf_mat = confusion_matrix(
    ground_truth, predictions)
array([[9477,   19],
       [ 397, 2458]])
tn, fp, fn, tp = conf_mat.ravel()
(fp, fn)
(19, 397)

Uma matriz de confusão, contando os casos para cada uma das quatro combinações mencionadas antes neste conjunto de dados.

Projetando Workflows de Machine Learning em Python

Métricas de desempenho escalares

accuracy = 1-(fp + fn)/len(ground_truth)

recall = tp/(tp+fn)
fpr = fp/(tn+fp)
precision = tp/(tp+fp)
f1 = 2*(precision*recall)/(precision+recall)
accuracy_score(ground_truth, predictions)
recall_score(ground_truth, predictions)
precision_score(ground_truth, predictions)
f1_score(ground_truth, predictions)
Projetando Workflows de Machine Learning em Python

Falsos positivos vs falsos negativos

Classificador A:

tn, fp, fn, tp = confusion_matrix(
    ground_truth, predictions_A).ravel()
(fp,fn)
(3, 3)
cost = 10 * fp + fn
33

Classificador B:

tn, fp, fn, tp = confusion_matrix(
    ground_truth, predictions_B).ravel()
(fp,fn)
(0, 26)

cost = 10 * fp + fn
26
Projetando Workflows de Machine Learning em Python

Qual classificador é melhor?

Projetando Workflows de Machine Learning em Python

Preparing Video For Download...