Complexidade do modelo e overfitting

Projetando Workflows de Machine Learning em Python

Dr. Chris Anagnostopoulos

Honorary Associate Professor

O que é complexidade do modelo?

RandomForestClassifier() aceita argumentos extras, como max_depth:

help(RandomForestClassifier)
Help on class RandomForestClassifier in module sklearn.ensemble.forest:
...
 |  max_depth : integer or None, optional (default=None)
 |      The maximum depth of the tree. If None, then nodes are expanded until
 |      all leaves are pure or until all leaves contain less than
 |      min_samples_split samples.
Projetando Workflows de Machine Learning em Python
m2 = RandomForestClassifier(
    max_depth=2)
m2.fit(X_train, y_train)

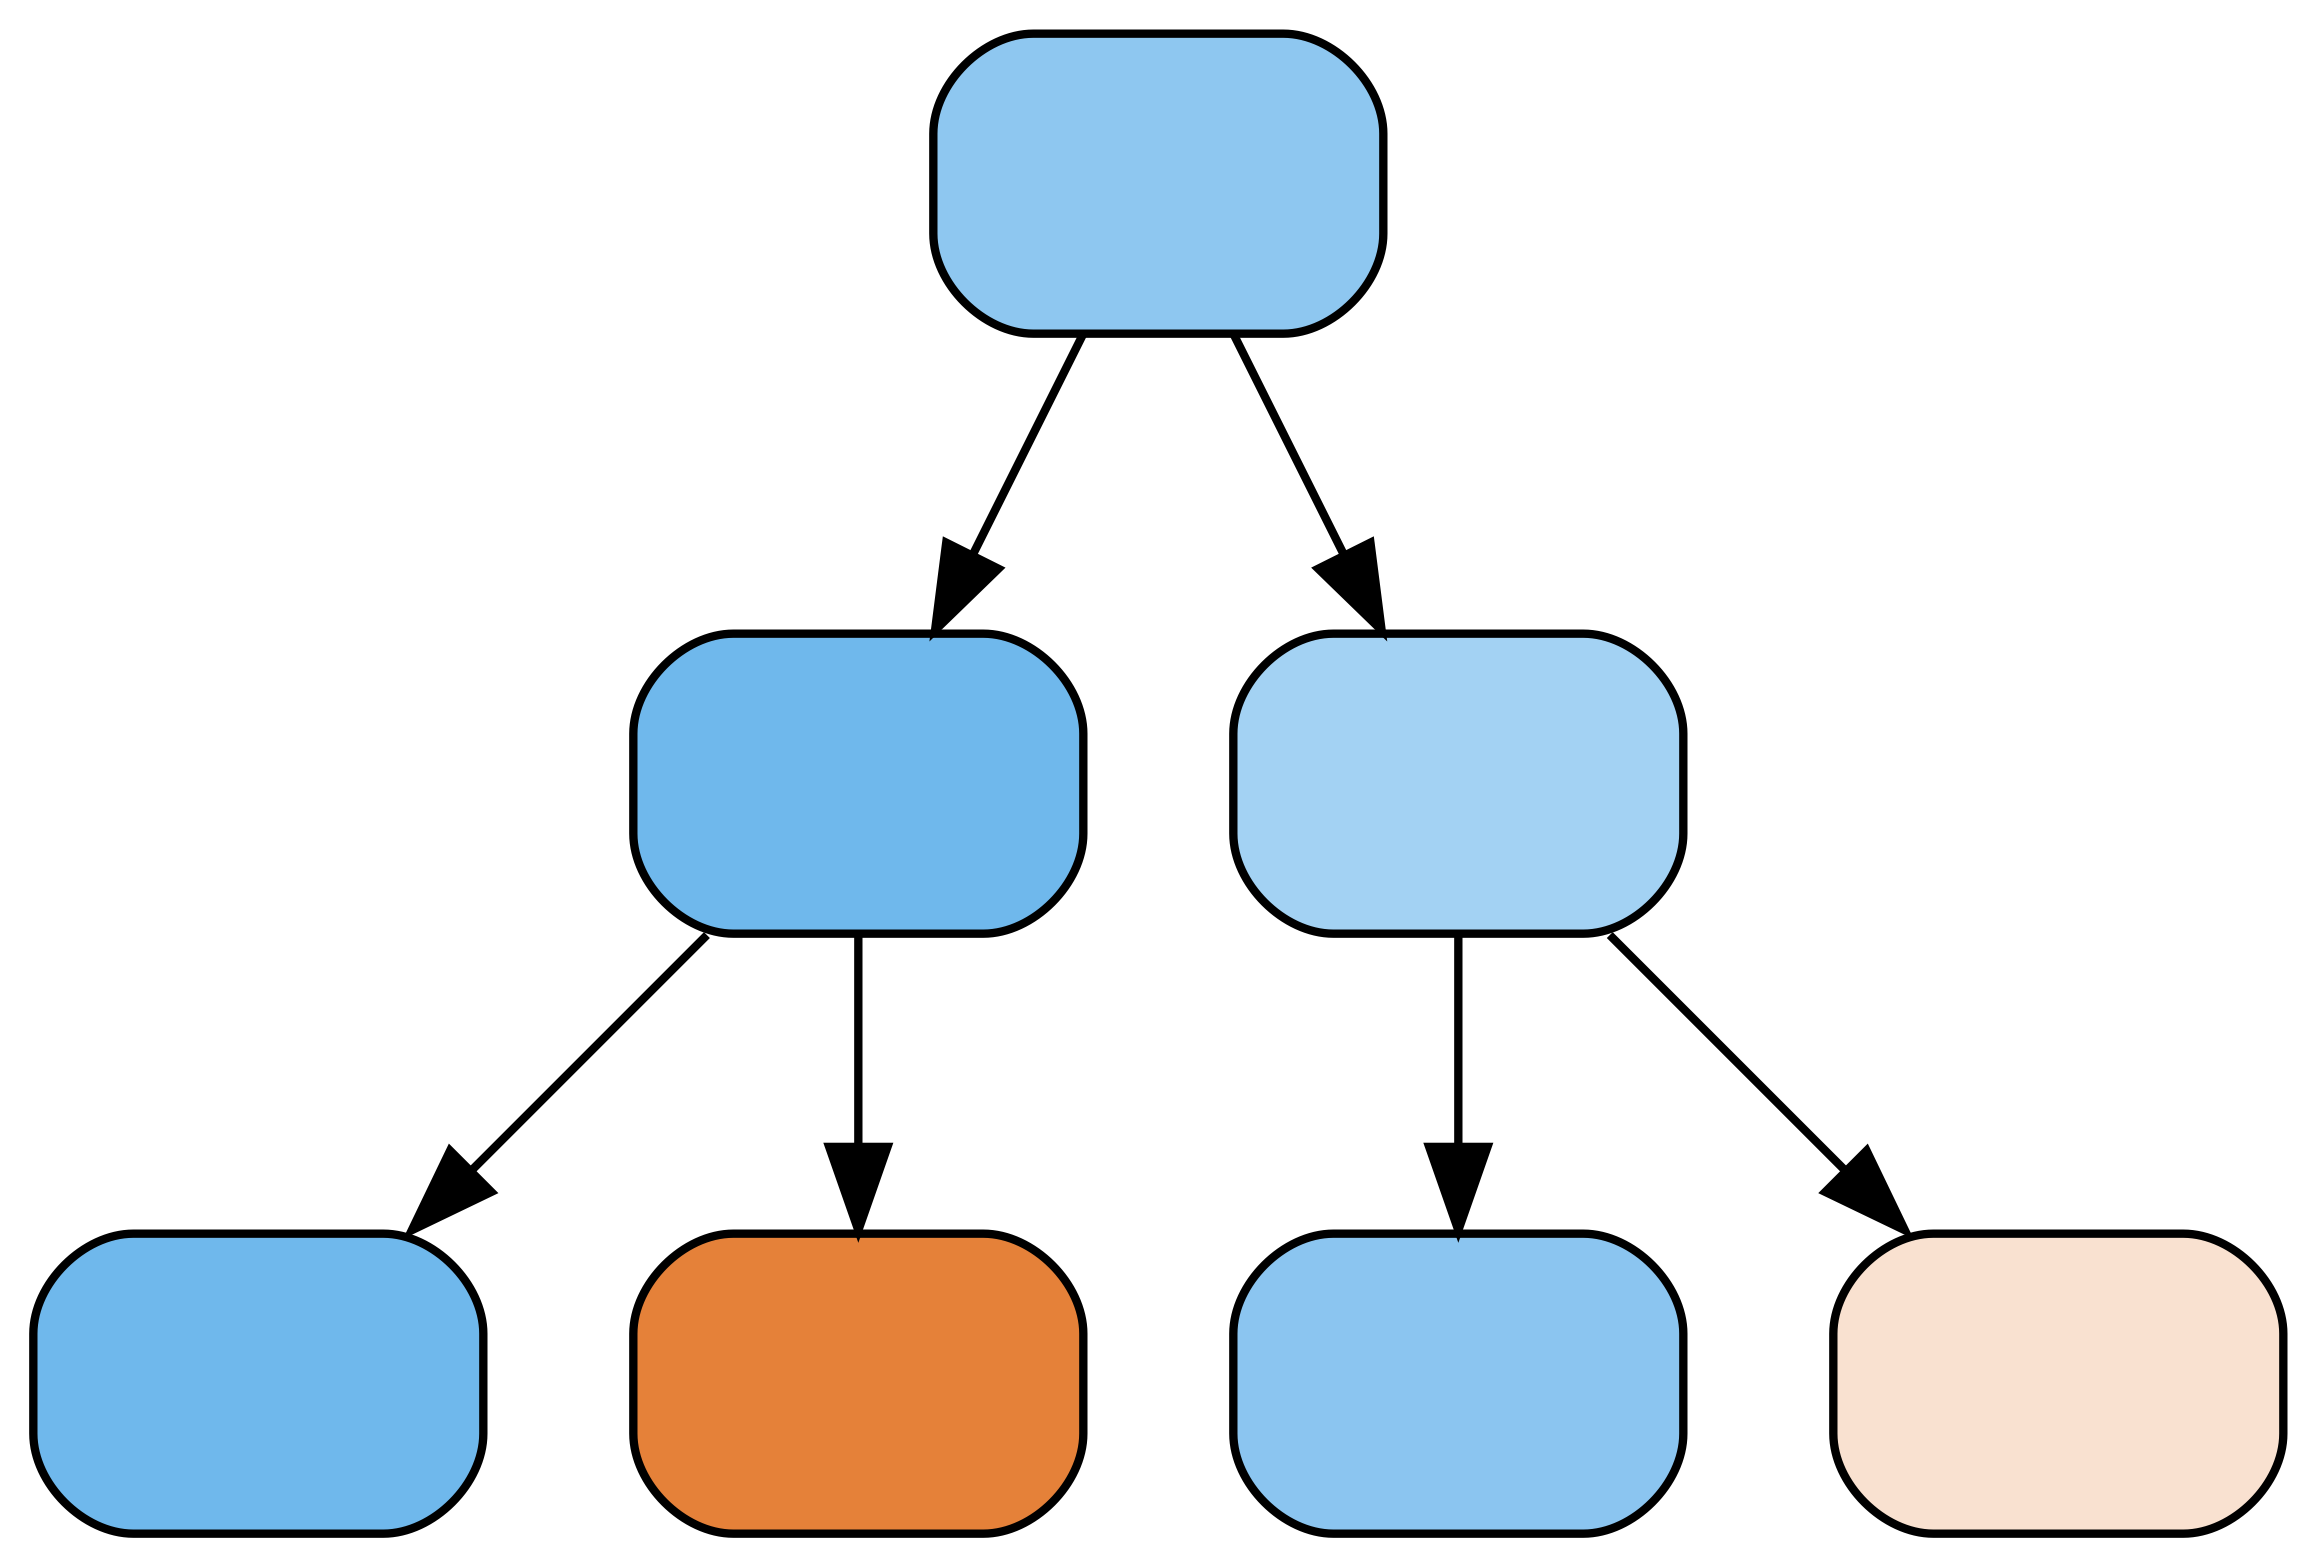
m2.estimators_[0]

Uma árvore de decisão com profundidade 2.

m4 = RandomForestClassifier(
    max_depth=4)
m4.fit(X_train, y_train)

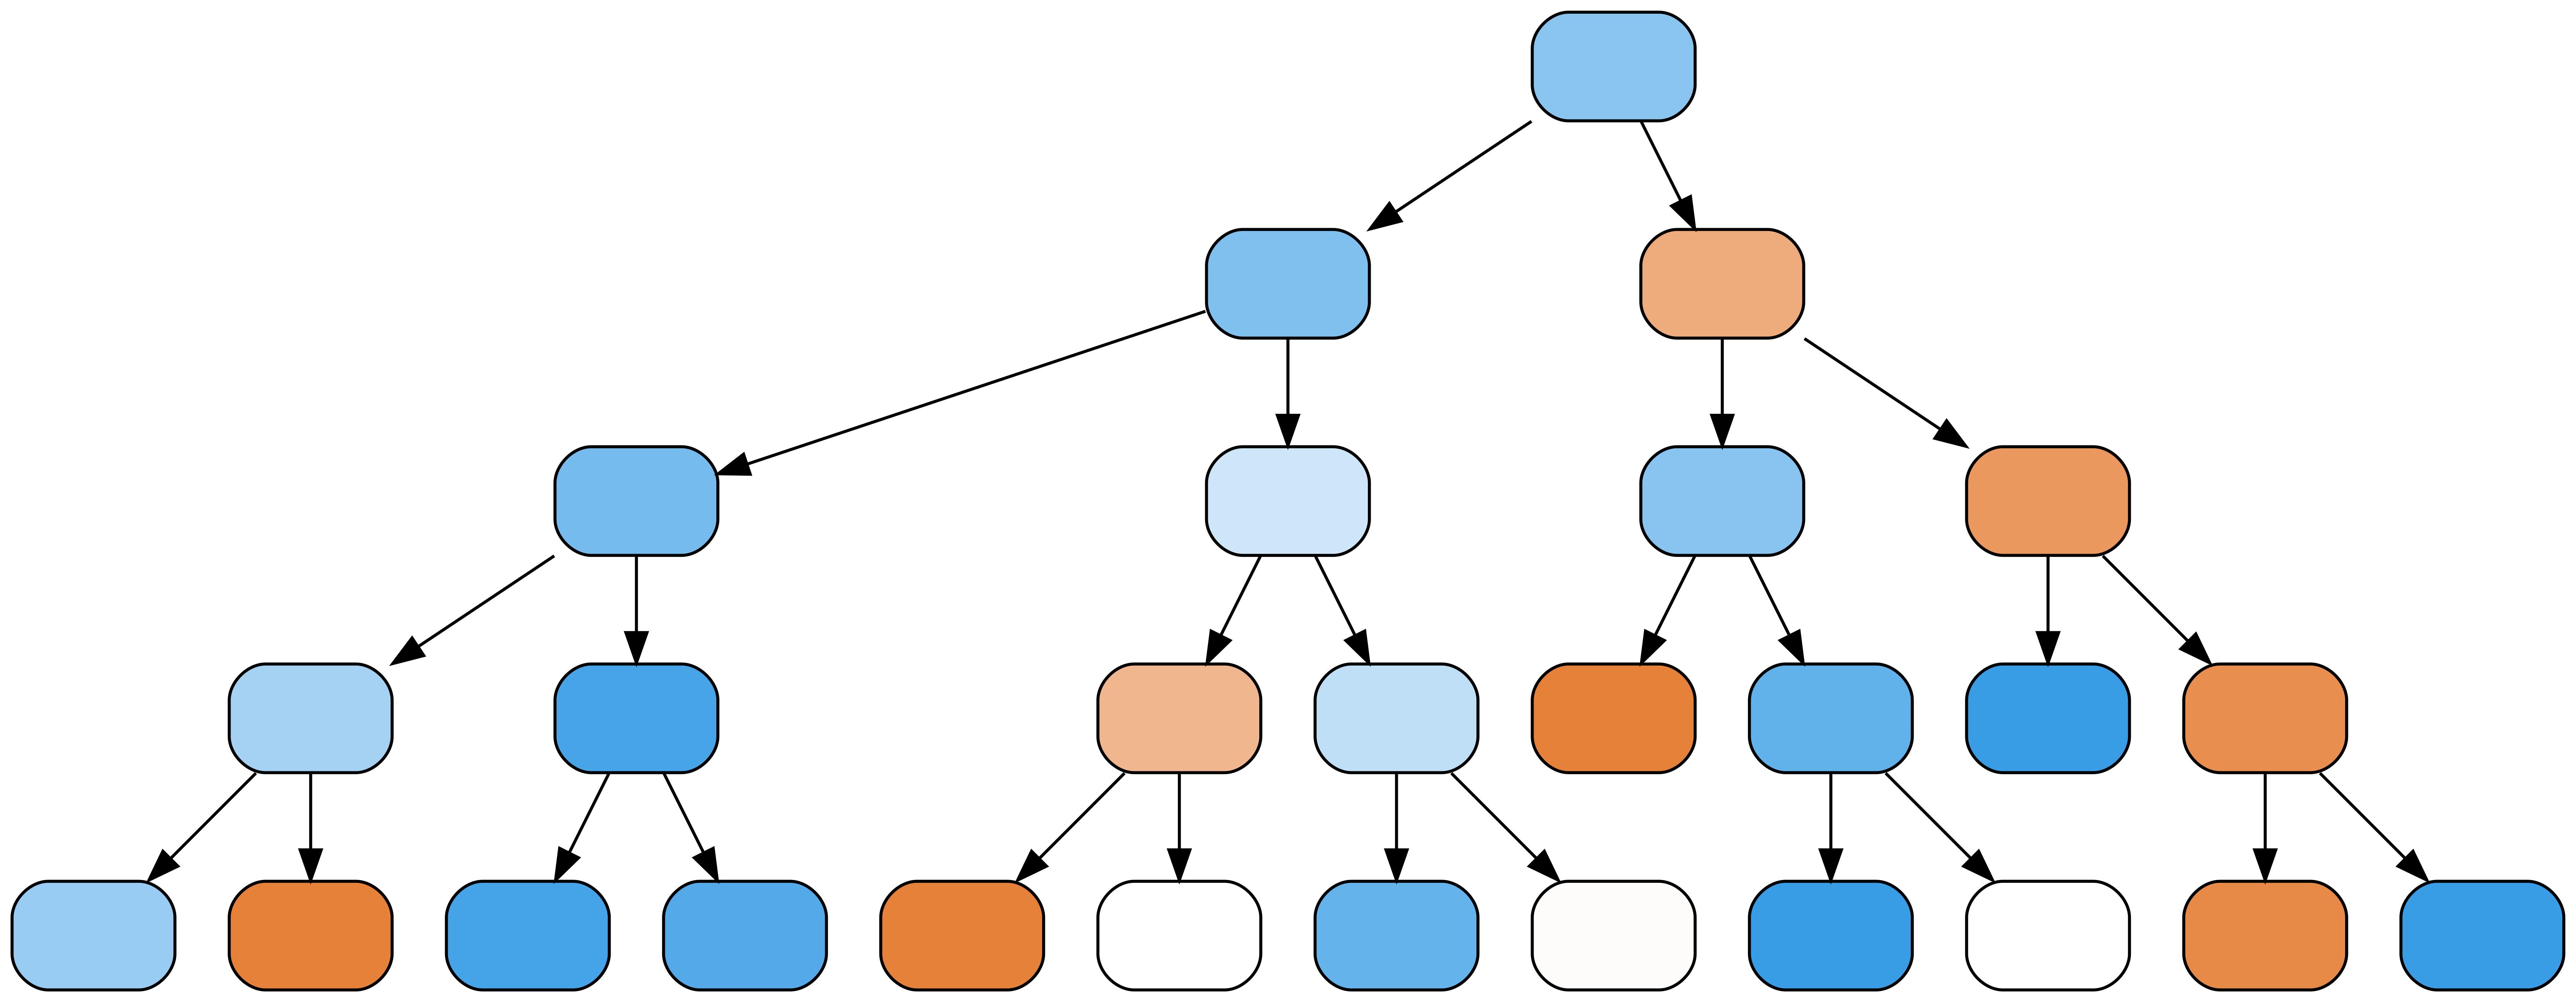
m4.estimators_[0]

Uma árvore de decisão com profundidade 4.

Projetando Workflows de Machine Learning em Python

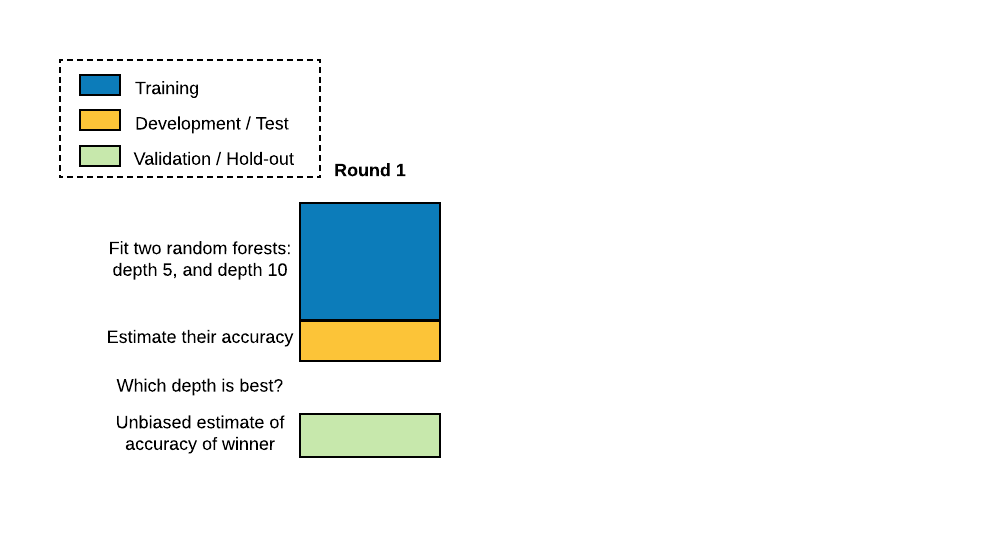
A prática padrão é dividir os dados em treino, teste (ou desenvolvimento) e validação (ou holdout).

Projetando Workflows de Machine Learning em Python

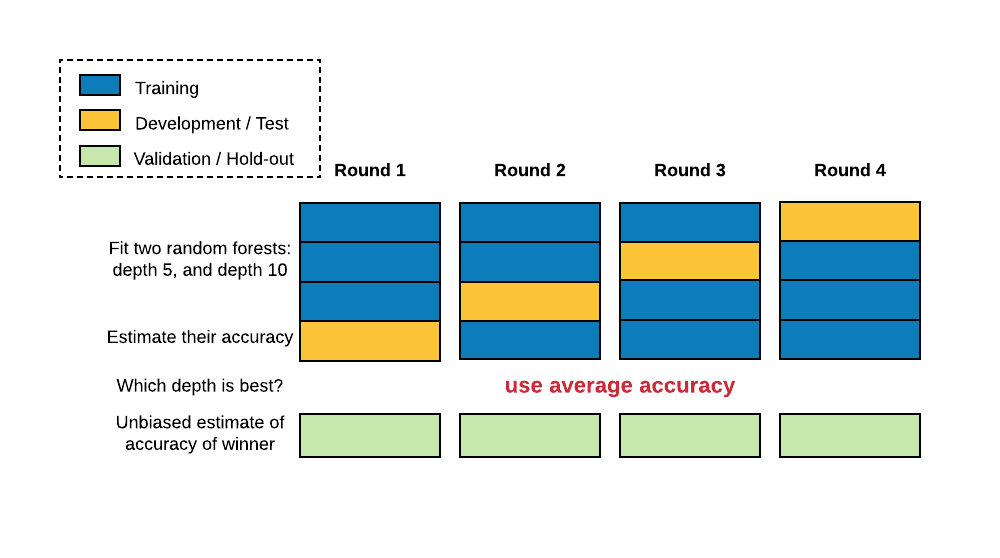
Na validação cruzada, a divisão treino‑teste é feita várias vezes. O conjunto de dados é dividido em N partes; em cada rodada, usa‑se N-1 para treino e a restante para teste.

Projetando Workflows de Machine Learning em Python

Validação cruzada

Avalie a acurácia com cross_val_score():

from sklearn.model_selection import cross_val_score

cross_val_score(RandomForestClassifier(), X, y)
array([0.7218 , 0.7682, 0.7866])
numpy.mean(cross_val_score(RandomForestClassifier(), X, y))
0.7589
Projetando Workflows de Machine Learning em Python

Ajustando a complexidade do modelo

Ajuste a profundidade com GridSearchCV():

from sklearn.model_selection import GridSearchCV
param_grid = {'max_depth':[5,10,20]}
grid = GridSearchCV(RandomForestClassifier(), param_grid)
grid.fit(X,y)
grid._best_params
{'max_depth': 10}
Projetando Workflows de Machine Learning em Python

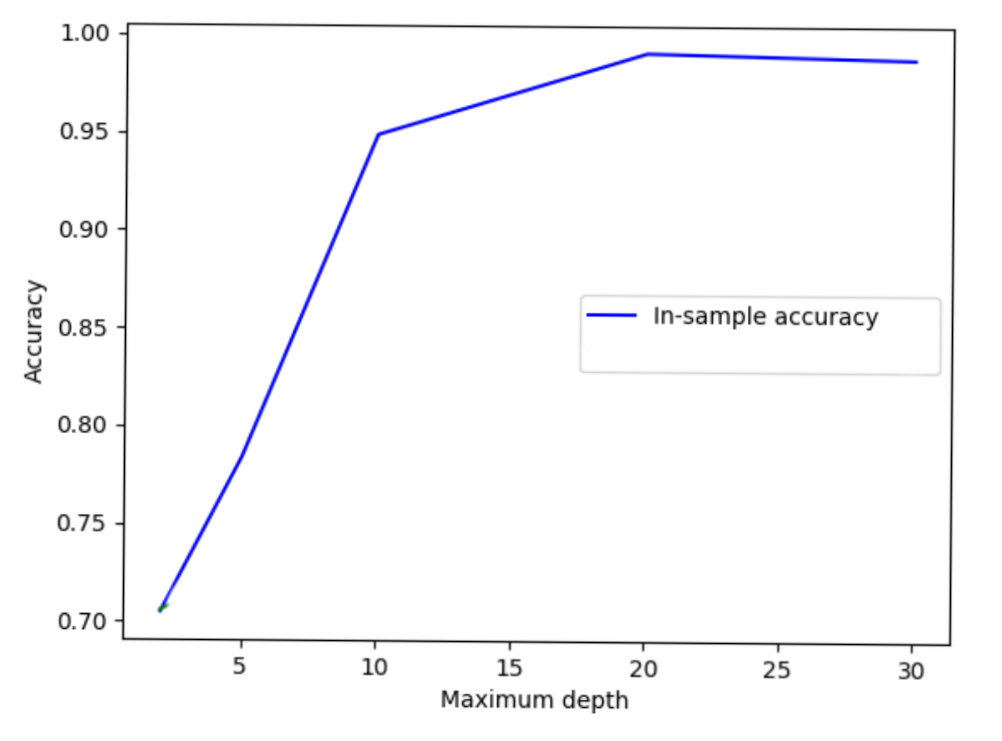
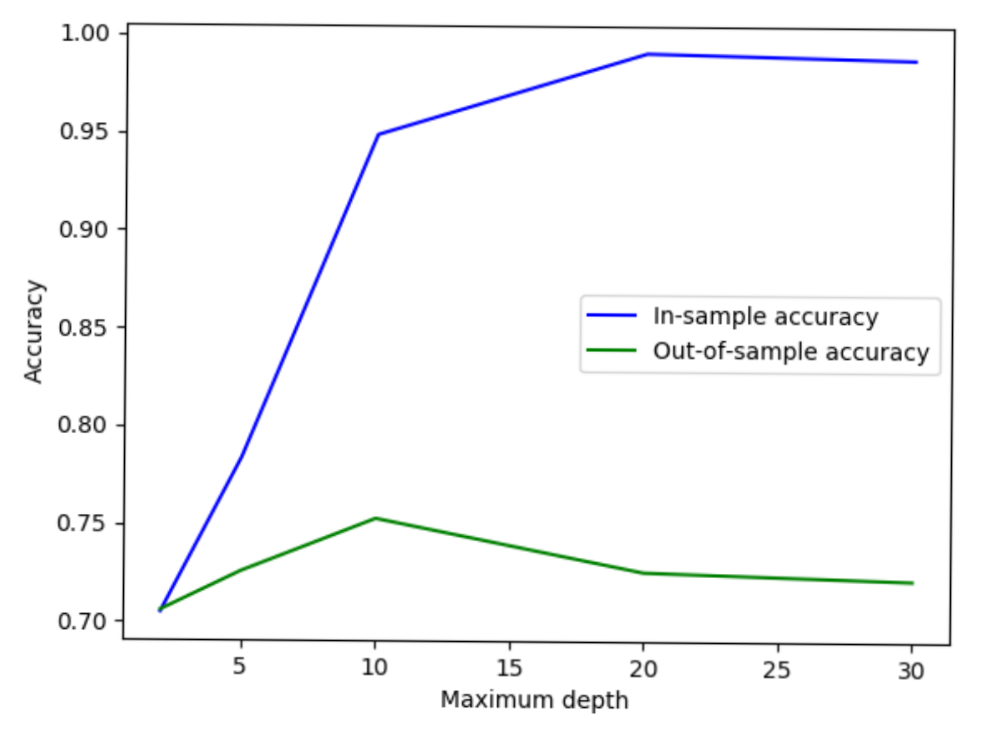
A acurácia in-sample começa em 0,7 para profundidade máxima 3 e sobe quase a 1,0 conforme a profundidade vai de 5 a 30.

Projetando Workflows de Machine Learning em Python

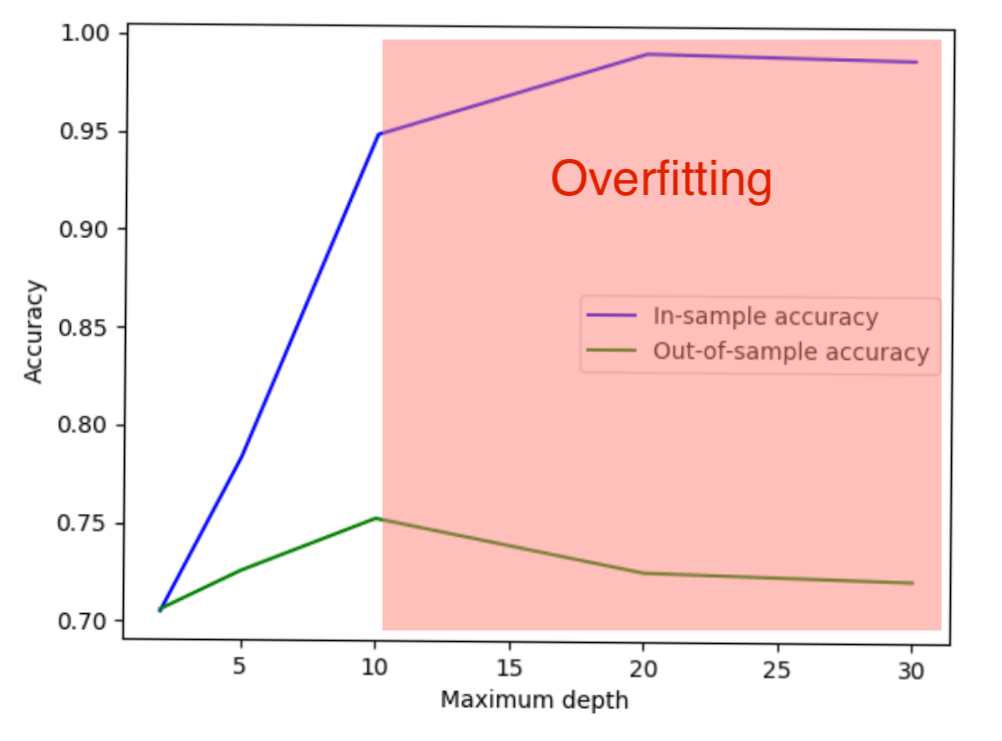
A acurácia out-of-sample também começa em 0,7, atinge 0,75 na profundidade 10 e volta a 0,7 para profundidades maiores.

Projetando Workflows de Machine Learning em Python

A faixa a partir da profundidade 10 está em vermelho, indicando que há overfitting.

Projetando Workflows de Machine Learning em Python

Mais complexo nem sempre é melhor!

Projetando Workflows de Machine Learning em Python

Preparing Video For Download...