LDA na prática
Introdução ao Processamento de Linguagem Natural em R

Kasey Jones
Research Data Scientist
Finalizando os resultados de LDA
- definir o número de tópicos
- perplexidade/outras métricas
- uma solução adequada ao seu caso
Perplexidade
- medida de quão bem um modelo probabilístico se ajusta a novos dados
- quanto menor, melhor
- usada para comparar modelos
- No ajuste de parâmetros do LDA
- Seleção do número de tópicos
sample_size <- floor(0.90 * nrow(doc_term_matrix))
set.seed(1111)
train_ind <- sample(nrow(doc_term_matrix), size = sample_size)
train <- matrix[train_ind, ]
test <- matrix[-train_ind, ]
1 https://en.wikipedia.org/wiki/Perplexity
Perplexidade no R
library(topicmodels)
values = c()
for(i in c(2:35)){
  lda_model <- LDA(train, k = i, method = "Gibbs",
                   control = list(iter = 25, seed = 1111))
  values <- c(values, perplexity(lda_model, newdata = test))
}
plot(c(2:35), values, main="Perplexity for Topics",
     xlab="Number of Topics", ylab="Perplexity")
Perplexidade de novo!
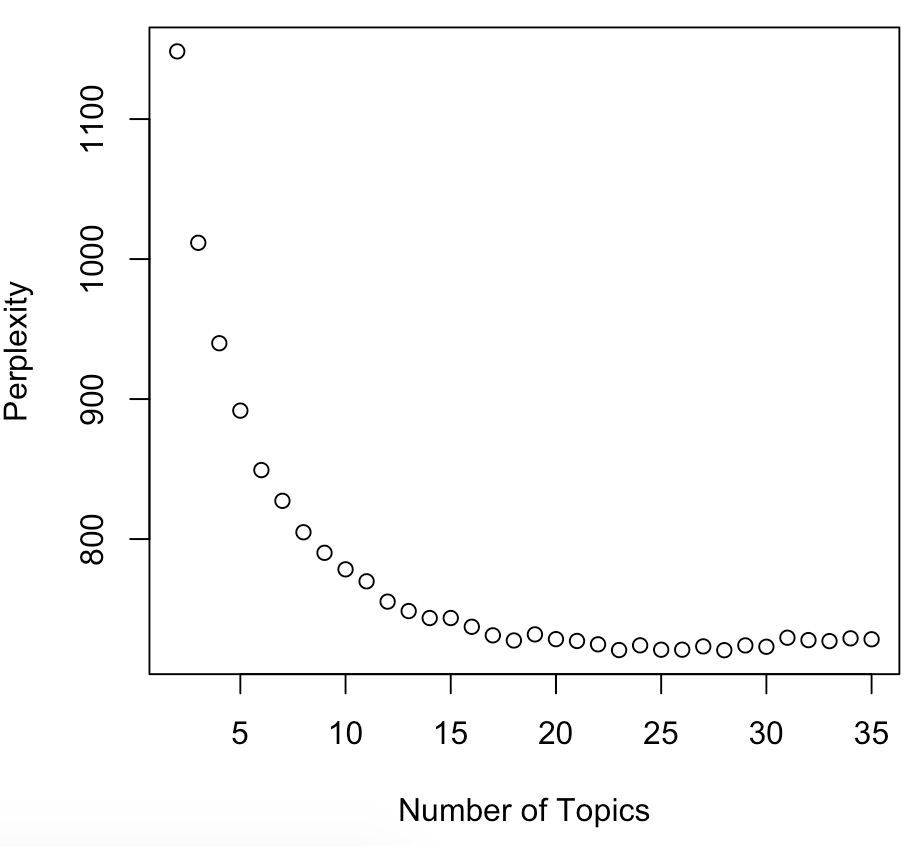
Seleção prática
- Quantos tópicos a situação comporta
- 20 pode ser difícil de cobrir
- Como você vai exibir os resultados
- Gráficos com 5 tópicos são mais fáceis que com 100
- Regras práticas:
- Use poucos tópicos, cada um representado por vários documentos
- Use muitos tópicos só se houver tempo para explorar e dissecar cada um
Usando os resultados
- Revisar ou pedir que revisores encontrem "temas" para cada tópico
- fornecer ao revisor a lista de principais palavras do tópico
- fornecer ao revisor a lista de principais documentos do tópico
Revisar a saída
betas <- tidy(lda_model, matrix = "beta")
betas %>%
  filter(topic == 1) %>%
  arrange(desc(beta)) %>%
  select(term)
# A tibble: 2,000 x 1
   term
   <chr>
 1 athletic
 2 quick
 3 strong
 4 tough
...
gammas <- tidy(lda_model, matrix = "gamma")
gammas %>%
  filter(topic == 1) %>%
  arrange(desc(gamma)) %>%
  select(document)
# A tibble: 1,000 x 1
   document
   <chr>
 1 232
 2 292
 3 921
 4 643
 5 468
Resumir a saída
gammas <- tidy(lda_model, matrix = "gamma")
gammas %>%
  group_by(document) %>%
  arrange(desc(gamma)) %>%
  slice(1) %>%
  group_by(topic) %>%
  tally(topic, sort=TRUE)
  topic     n
1     1  1326
2     5  1215
3     4   804
...
Resumir a saída novamente
gammas %>%
  group_by(document) %>%
  arrange(desc(gamma)) %>%
  slice(1) %>%
  group_by(topic) %>%
  summarize(avg=mean(gamma)) %>%
  arrange(desc(avg))
  topic   avg
1     1 0.696
2     5 0.530
3     4 0.482
...
Prática de LDA.
Introdução ao Processamento de Linguagem Natural em R

