Noções básicas de limpeza de texto

Introdução ao Processamento de Linguagem Natural em R

Kasey Jones

Research Data Scientist

O conjunto de tweets russos

3 milhões de tweets de trolls russos
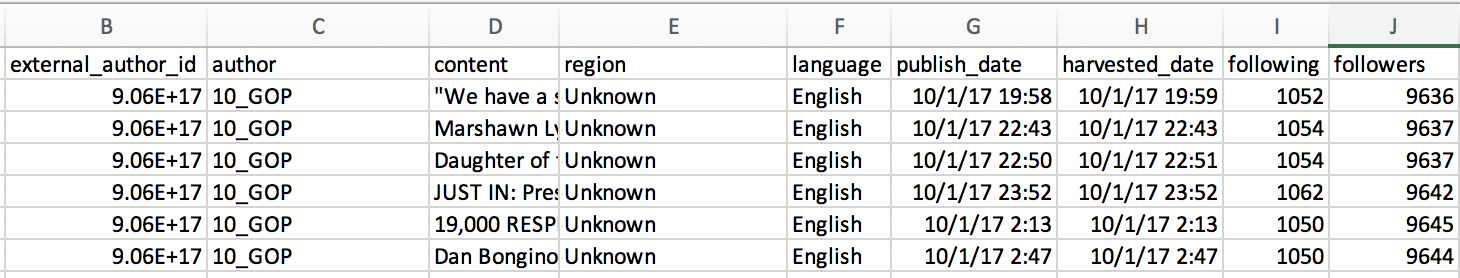
O conjunto de dados Russian Troll Tweets é do fivethirtyeight e reúne 3 milhões de tweets gerados por bots durante a eleição dos EUA de 2016.

  • Vamos explorar os primeiros 20.000 tweets
  • Dados incluem o tweet, seguidores, seguindo, data, tipo de conta etc.
  • Ótimo para modelagem de tópicos, classificação, reconhecimento de entidades nomeadas etc.
1 https://github.com/fivethirtyeight/russian-troll-tweets
Introdução ao Processamento de Linguagem Natural em R

Palavras mais frequentes

library(tidytext); library(dplyr)
russian_tweets %>%
  unnest_tokens(word, content) %>%
  count(word, sort = TRUE)
# A tibble: 44,318 x 2
   word      n
   <chr> <int>
 1 t.co  18121
 2 https 16003
 3 the    7226
 4 to     5279
 ...
Introdução ao Processamento de Linguagem Natural em R

Remover stop words

tidy_tweets <- russian_tweets %>%
  unnest_tokens(word, content) %>%
  anti_join(stop_words)
tidy_tweets %>%
  count(word, sort = TRUE)
 1 t.co             18121
 2 https            16003
 3 http              2135
 4 blacklivesmatter  1292
 5 trump             1004
 ...
# A tibble: 1,149 x 2
   word        lexicon
   <chr>       <chr>  
 1 a           SMART  
 2 a's         SMART  
 3 able        SMART  
 4 about       SMART  
 5 above       SMART
Introdução ao Processamento de Linguagem Natural em R

Stop words personalizadas

custom <- add_row(stop_words, word = "https", lexicon = "custom")
custom <- add_row(custom, word = "http", lexicon = "custom")
custom <- add_row(custom, word = "t.co", lexicon = "custom")
russian_tweets %>%
  unnest_tokens(word, content) %>%
  anti_join(custom) %>%
  count(word, sort = TRUE)
Introdução ao Processamento de Linguagem Natural em R

Resultados finais

# A tibble: 43,663 x 2
   word                 n
   <chr>            <int>
 1 blacklivesmatter  1292
 2 trump             1004
 3 black              781
 4 enlist             764
 5 police             745
 6 people             723
 7 cops               693
Introdução ao Processamento de Linguagem Natural em R

Stemming

  • enlisted ---> enlist
  • enlisting ---> enlist
library(SnowballC)
tidy_tweets <- russian_tweets %>%
  unnest_tokens(word, content) %>%
  anti_join(custom)
# Stemming
stemmed_tweets <- tidy_tweets %>%
  mutate(word = wordStem(word))
Introdução ao Processamento de Linguagem Natural em R

Resultados do stemming

# A tibble: 38,907 x 2
   word               n
   <chr>          <int>
 1 blacklivesmatt  1301
 2 cop             1016
 3 trump           1013
 4 black            848
 5 enlist           809
 6 polic            763
 7 peopl            730
Introdução ao Processamento de Linguagem Natural em R

Hora do exemplo.

Introdução ao Processamento de Linguagem Natural em R

Preparing Video For Download...