Introdução ao topic modeling

Introdução ao Processamento de Linguagem Natural em R

Kasey Jones

Research Data Scientist

Topic modeling

Histórias de esportes:

  • placares
  • fofocas de jogadores
  • notícias dos times
  • etc.

Clima na Zâmbia:

  • ?
  • ?
Introdução ao Processamento de Linguagem Natural em R

Latent dirichlet allocation

  1. Documentos são misturas de tópicos
    • Notícias dos times 70%
    • Fofocas de jogadores 30%
  2. Tópicos são misturas de palavras
    • Notícias dos times: trade, pitcher, move, new
    • Fofocas de jogadores: angry, change, money

Jornais estão cheios de artigos focados em tópicos específicos.

1 https://en.wikipedia.org/wiki/Latent_Dirichlet_allocation
Introdução ao Processamento de Linguagem Natural em R

Preparando para LDA

Preparação do corpus:

animal_farm_tokens <- animal_farm %>%
  unnest_tokens(output = "word", token = "words", input = text_column) %>%
  anti_join(stop_words) %>%
  mutate(word = wordStem(word))

Matriz documento-termo:

animal_farm_matrix <- animal_farm_tokens %>%
  count(chapter, word) %>%
  cast_dtm(document = chapter, term = word,
           value = n, weighting = tm::weightTf)
Introdução ao Processamento de Linguagem Natural em R

LDA

library(topicmodels)
animal_farm_lda <- LDA(train, k = 4, method = 'Gibbs',
                 control = list(seed = 1111))
animal_farm_lda
Um modelo de tópicos LDA_Gibbs com 4 tópicos.
Introdução ao Processamento de Linguagem Natural em R

Resultados do LDA

animal_farm_betas <-
    tidy(animal_farm_lda, matrix = "beta")
animal_farm_betas
# A tibble: 11,004 x 3
   topic term         beta
   <int> <chr>       <dbl>
...
 5     1 abolish 0.0000360
 6     2 abolish 0.00129  
 7     3 abolish 0.000355 
 8     4 abolish 0.0000381
...
sum(animal_farm_betas$beta)
[1] 4
Introdução ao Processamento de Linguagem Natural em R

Principais palavras por tópico

animal_farm_betas %>%
  group_by(topic) %>%
  slice_max(beta, n = 10) %>%
  arrange(topic, -beta) %>%
  filter(topic == 1)
   topic term          beta
   <int> <chr>        <dbl>
 1     1 napoleon   0.0339 
 2     1 anim       0.0317 
 3     1 windmil    0.0144 
 4     1 squealer   0.0119 
 ...
animal_farm_betas %>%
  group_by(topic) %>%
  slice_max(beta, n = 10) %>%
  arrange(topic, -beta) %>%
  filter(topic == 2)
   topic term        beta
   <int> <chr>      <dbl>
...
 3     2 anim     0.0189 
 ...
 6     2 napoleon 0.0148 
 ...
Introdução ao Processamento de Linguagem Natural em R

Principais palavras (continuação)

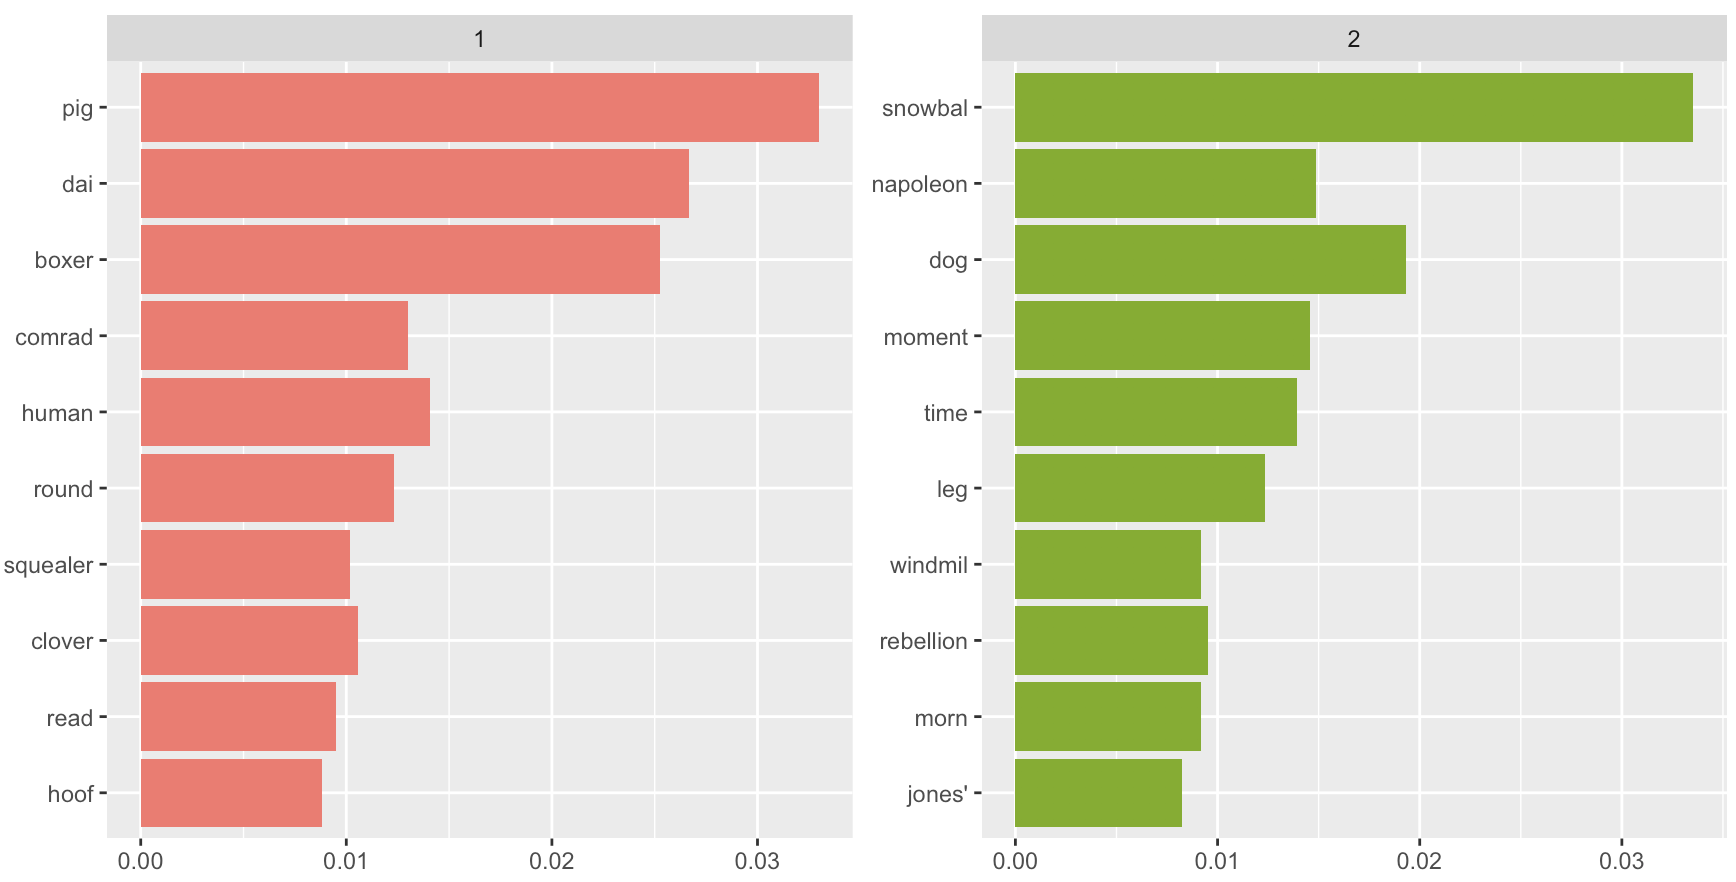
Podemos listar as principais palavras por tópico e visualizá-las com ggplot.

1 https://www.tidytextmining.com/topicmodeling.html
Introdução ao Processamento de Linguagem Natural em R

Rotulando documentos como tópicos

animal_farm_chapters <- tidy(animal_farm_lda, matrix = "gamma")
animal_farm_chapters %>%
  filter(document == 'Chapter 1')
# A tibble: 4 x 3
  document  topic  gamma
  <chr>     <int>  <dbl>
1 Chapter 1     1 0.157 
2 Chapter 1     2 0.136 
3 Chapter 1     3 0.623 
4 Chapter 1     4 0.0838
Introdução ao Processamento de Linguagem Natural em R

Prática de LDA!

Introdução ao Processamento de Linguagem Natural em R

Preparing Video For Download...