Similaridade do cosseno

Introdução ao Processamento de Linguagem Natural em R

Kasey Jones

Research Data Scientist

Saída de TFIDF

# A tibble: 1,498 x 6
       X word         n     tf   idf tf_idf
   <int> <chr>    <int>  <dbl> <dbl>  <dbl>
 1    20 january      4 0.0930  2.30  0.214
 2    15 power        4 0.0690  3.00  0.207
 3    19 futures      9 0.0643  3.00  0.193
 4     8 8            6 0.0619  3.00  0.185
 5     3 canada       2 0.0526  3.00  0.158
 6     3 canadian     2 0.0526  3.00  0.158
Introdução ao Processamento de Linguagem Natural em R

Similaridade do cosseno

  • uma medida de similaridade entre dois vetores
  • medida pelo ângulo formado entre os vetores
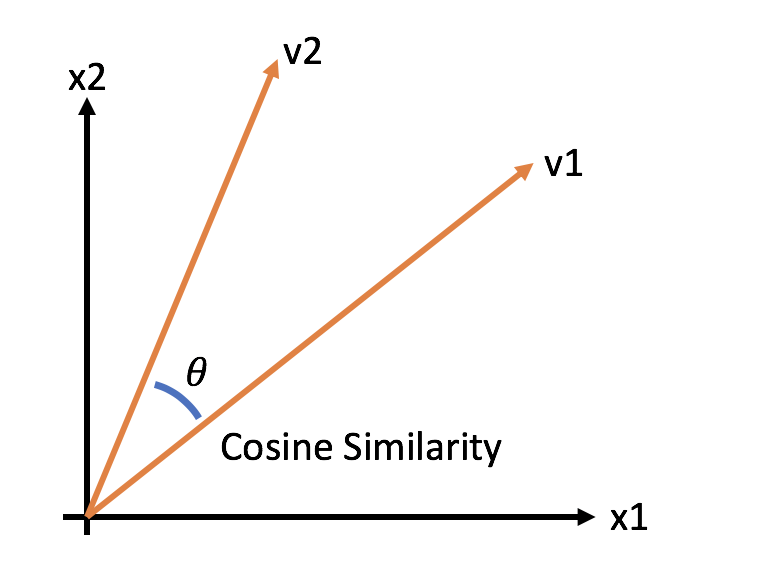
A similaridade do cosseno mede o ângulo entre dois vetores. Você pode imaginar como o ângulo formado por duas linhas.

1 https://en.wikipedia.org/wiki/Cosine_similarity
Introdução ao Processamento de Linguagem Natural em R

Fórmula da similaridade do cosseno

  • a similaridade é calculada como o produto escalar dos dois vetores
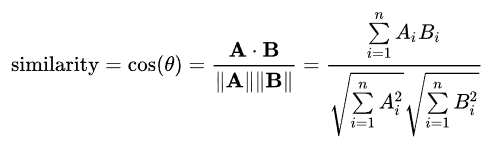
Calcular o produto escalar entre dois vetores mostra o quão similares eles são.

Introdução ao Processamento de Linguagem Natural em R

Encontrando similaridades parte I

crude_weights <- crude_tibble %>%
  unnest_tokens(output = "word", token = "words", input = text) %>%
  anti_join(stop_words) %>%
  count(word, X) %>%
  bind_tf_idf(word, X, n)
# A tibble: 1,498 x 6
       X word          n    tf   idf tf_idf
   <int> <chr>     <int> <dbl> <dbl>  <dbl>
 1     1 1.50          1 0.25   3.25  0.812
 2     1 16.00         1 1      3.25  3.25 
 3     1 barrel        2 0.133  3.25  0.433
 ...
Introdução ao Processamento de Linguagem Natural em R

Similaridade par-a-par

pairwise_similarity(tbl, item, feature, value, ...)
  • tbl: uma table ou tibble
  • item: os itens a comparar (artigos, tweets etc.)
  • feature: coluna que descreve o vínculo entre os itens (ex.: palavras)
  • value: a coluna de valores (ex.: n ou tf_idf)
Introdução ao Processamento de Linguagem Natural em R

Encontrando similaridades parte II

crude_weights %>%
  pairwise_similarity(X, word, tf_idf) %>%
  arrange(desc(similarity))
# A tibble: 380 x 3
   item1 item2 similarity
   <int> <int>      <dbl>
 1    17    16      0.663
 2    16    17      0.663
 3    13    10      0.311
 4    10    13      0.311
 ...
Introdução ao Processamento de Linguagem Natural em R

Casos de uso da similaridade do cosseno

  • encontrar trechos de texto duplicados/similares
  • usar em análise de clusterização e classificação
  • ...
Introdução ao Processamento de Linguagem Natural em R

Vamos praticar!

Introdução ao Processamento de Linguagem Natural em R

Preparing Video For Download...