Monitorando e gerenciando memória

Programação Paralela em R

Nabeel Imam

Data Scientist

A fila e o espaço
Três caixas atendem clientes em um banco, enquanto alguns aguardam sua vez.

Programação Paralela em R

O fluxo paralelo

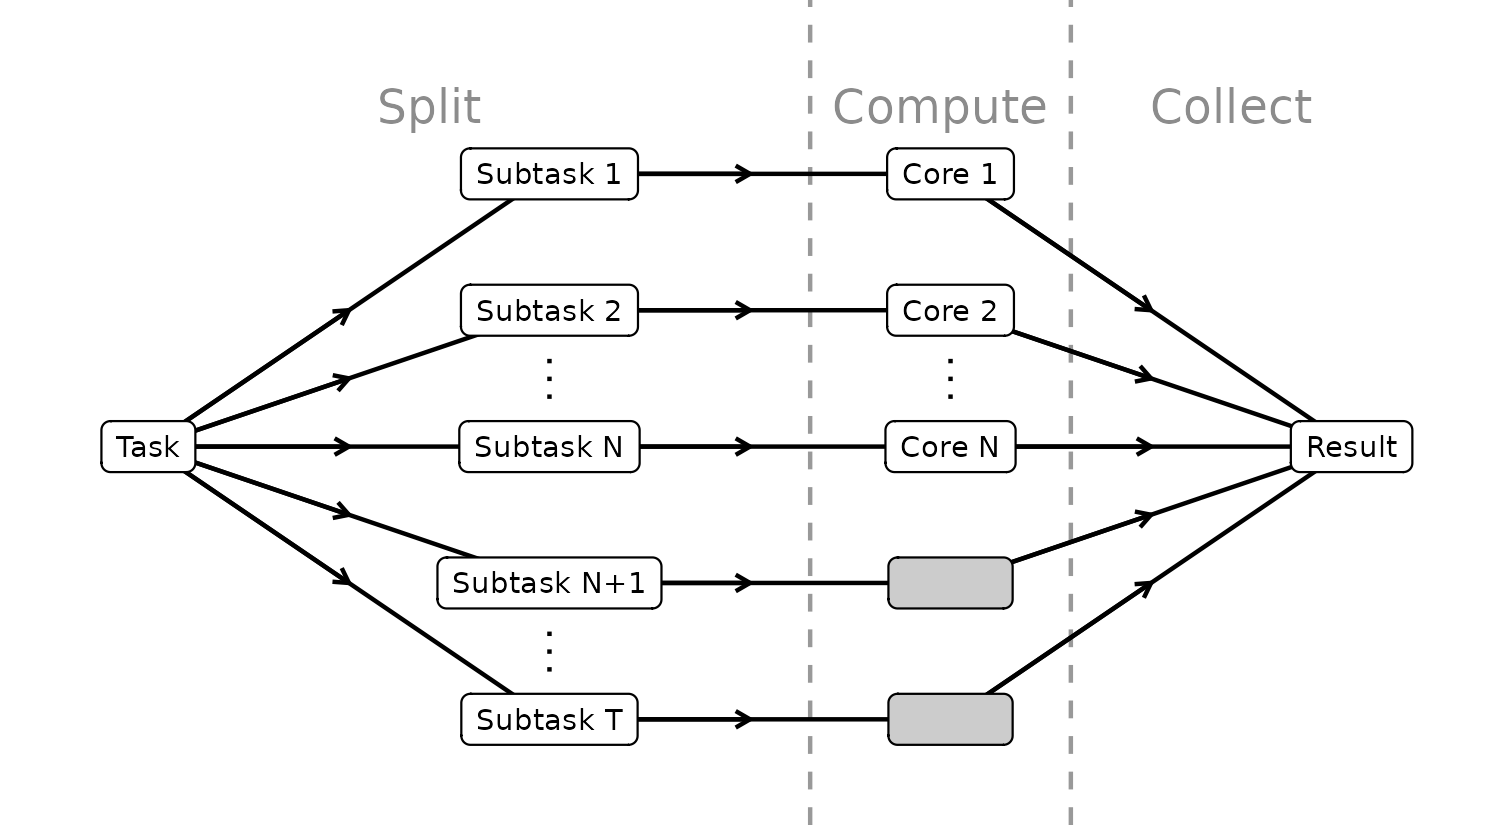
Um fluxo paralelo é mostrado: uma tarefa é dividida em subtarefas menores, executadas por diferentes núcleos, e os resultados são combinados.

Programação Paralela em R

O fluxo paralelo

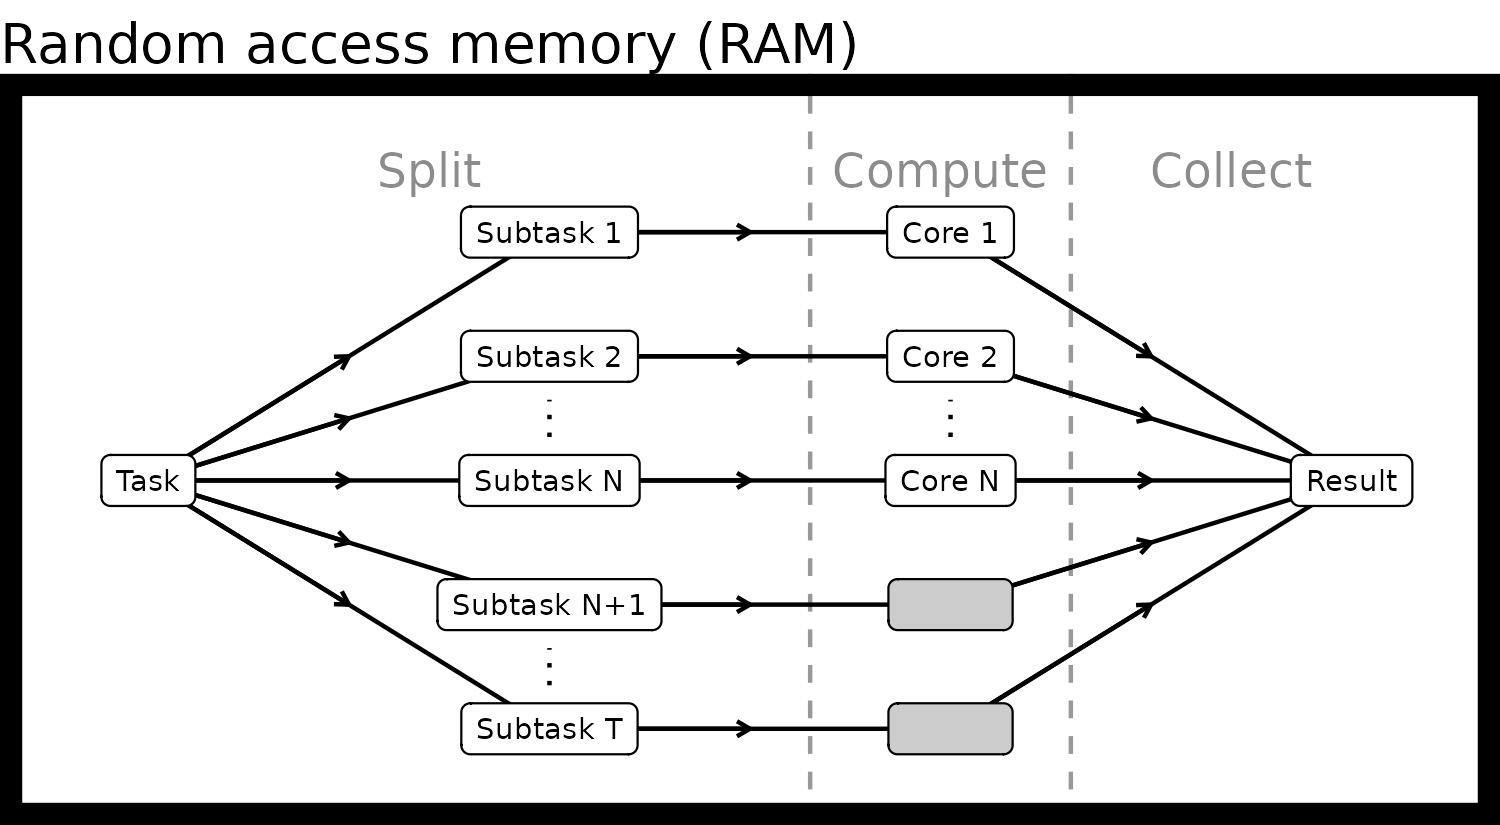
O fluxo paralelo fica dentro da memória de acesso aleatório.

Programação Paralela em R

Os dados de nascimentos

print(ls_files)
 [1] "./births/AK.csv"
 [2] "./births/AL.csv"
 [3] "./births/AR.csv"
 [4] "./births/AZ.csv"
 [5] "./births/CA.csv"
 [6] "./births/CO.csv"
 [7] "./births/CT.csv"
 [8] "./births/DC.csv"
 [9] "./births/DE.csv"
 [10] "./births/FL.csv"
...
Programação Paralela em R

Mapeando com futures

plan(multisession, workers = 2)

ls_df <- future_map(ls_files, read.csv)
plan(sequential)
print(ls_df)
[[1]]
   state month plurality weight_gain_pounds mother_age
      AK     1         1                 30         43
   ...
[[2]]
   state month plurality weight_gain_pounds mother_age
      AL    10         1                 60         33
   ...
...
Programação Paralela em R

Perfil com dois workers

profvis({
  plan(multisession, workers = 2)
  ls_df <- future_map(ls_files, read.csv)
  plan(sequential)
})

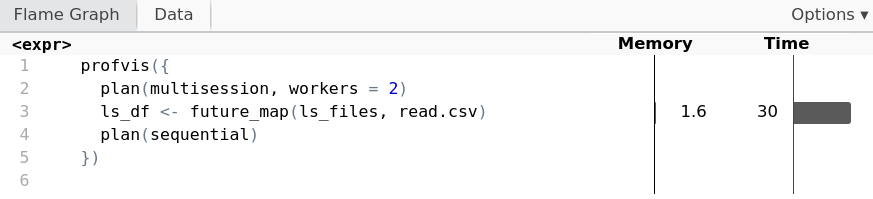
Uma saída de perfil de código gerada pela função profvis. Ler arquivos CSV em paralelo com dois workers usando future_map usa 1,6 megabytes de memória; as outras linhas não registram uso.

Programação Paralela em R

Perfil com quatro workers

profvis({
  plan(multisession, workers = 4)
  ls_df <- future_map(ls_files, read.csv)
  plan(sequential)
})

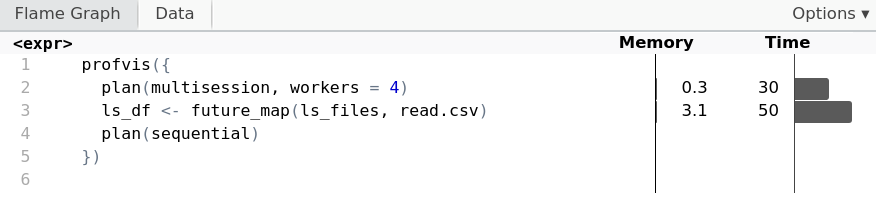
Uma saída de perfil de código gerada pela função profvis. Ler arquivos CSV em paralelo com quatro workers usando future_map usa 3,1 megabytes de memória; o planejamento do multisession usa 0,3 megabytes.

Programação Paralela em R

Por trás dos bastidores

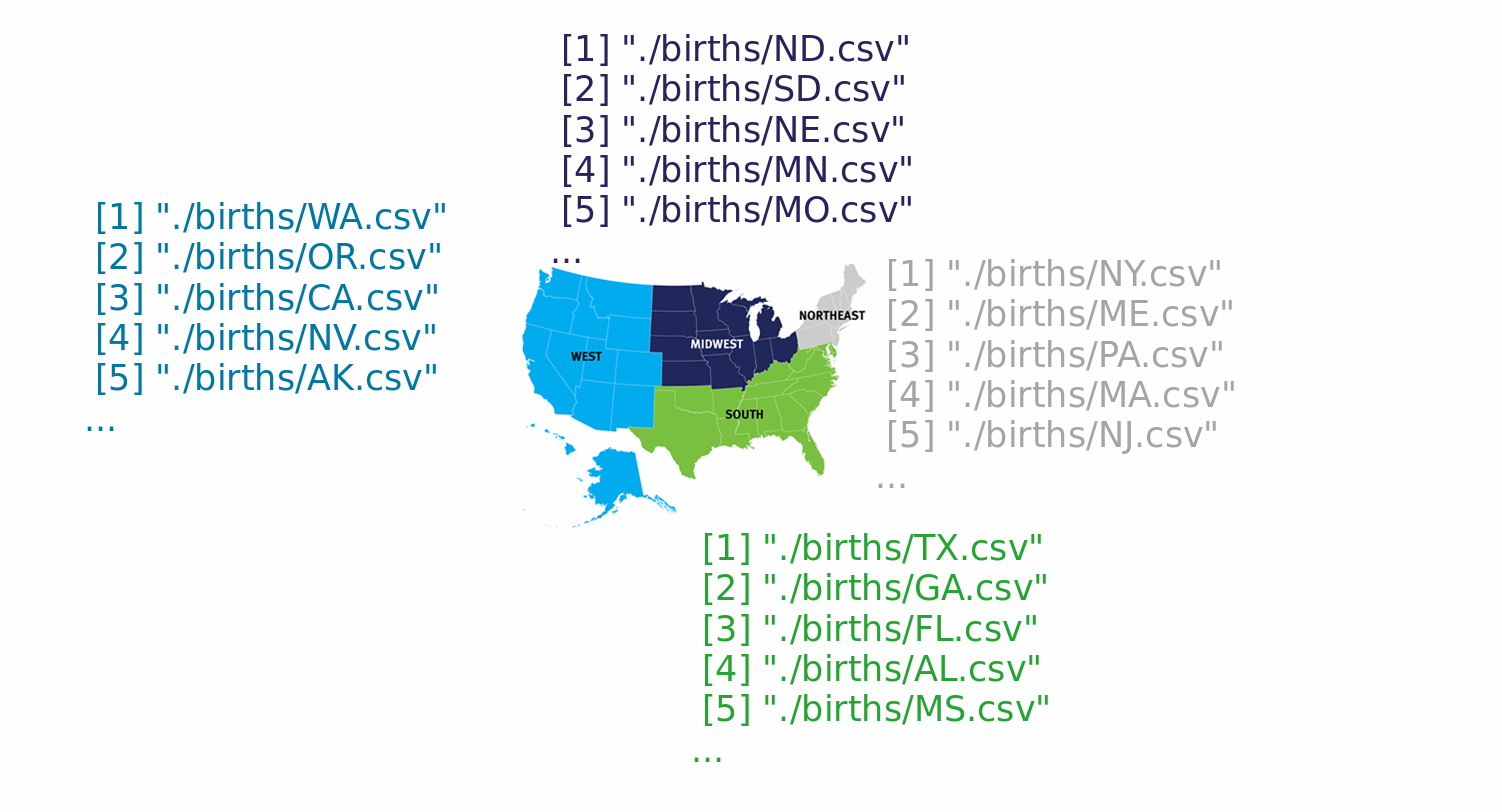
Um mapa dos EUA, dividido em quatro regiões: Oeste, Meio-Oeste, Sul e Nordeste. Cada região corresponde a uma lista de arquivos CSV com dados de cada estado.

Programação Paralela em R

Gerenciando memória com chunking

config <- furrr_options(chunk_size = 26)

plan(multisession, workers = 4) ls_df <- future_map(ls_files, read.csv,
.options = config) plan(sequential)
Programação Paralela em R

Gerenciando memória com chunking

profvis({
  config <- furrr_options(chunk_size = 26)
  plan(multisession, workers = 4)
  ls_df <- future_map(ls_files, read.csv,
             .options = config)
  plan(sequential)
})

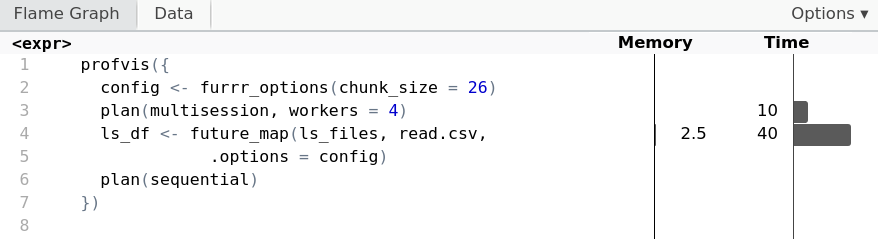
Uma saída de perfil de código gerada pela função profvis. Ler CSVs em paralelo com quatro workers usando future_map consome 2,5 megabytes de memória com chunk size 26.

Programação Paralela em R

Chunking com parallel

cl <- makeCluster(4)


ls_df <- parLapply(cl, ls_files, read.csv)
stopCluster(cl)

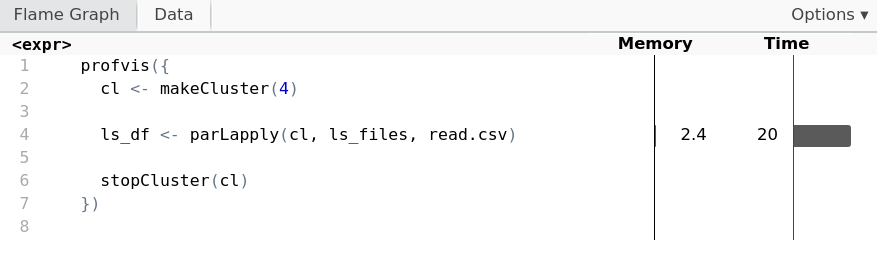
Ler arquivos CSV em paralelo com parLapply usa 2,4 megabytes de memória, todo o uso ocorre na chamada parLapply.

Programação Paralela em R

Chunking com parallel

cl <- makeCluster(4)
ls_df <- parLapply(cl, ls_files, read.csv,

chunk.size = 26)
stopCluster(cl)

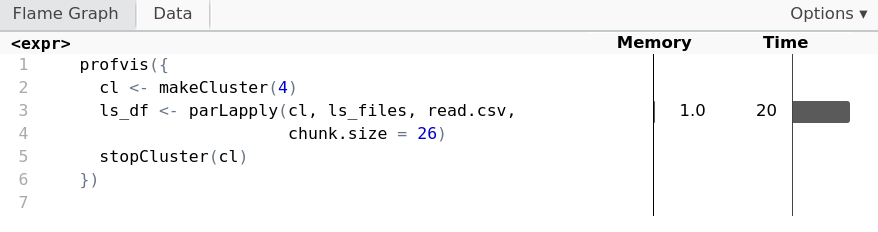
Ler arquivos CSV em paralelo com parLapply usa apenas 1 megabyte de memória quando chunk size é 26.

Programação Paralela em R

Quando usar chunking?

  • O chunking já é ideal por padrão
  • Com objetos grandes e pouca memória
    • Tente usar menos núcleos, se possível
    • Teste alguns tamanhos de chunk até chegar ao ideal
Programação Paralela em R

Vamos praticar!

Programação Paralela em R

Preparing Video For Download...