Paralelização em R

Programação Paralela em R

Nabeel Imam

Data Scientist

Um exemplo prático

Os dados

print(file_list)
 [1] "./uni_data_country/Argentina.csv"
 [2] "./uni_data_country/Armenia.csv"
 [3] "./uni_data_country/Australia.csv"
 [4] "./uni_data_country/Austria.csv"
 [5] "./uni_data_country/Azerbaijan.csv"
 [6] "./uni_data_country/Bahrain.csv"
 [7] "./uni_data_country/Bangladesh.csv"
 [8] "./uni_data_country/Belarus.csv"
 [9] "./uni_data_country/Belgium.csv"
[10] "./uni_data_country/Bolivia.csv"
...

Três prédios universitários com formandos, cada um com ranking de um a três.

Programação Paralela em R

Adicionar uma coluna

for (file in file_list) {

  df <- read.csv(file)


df$top100 <- NA for (r in 1:nrow(df)) { df$top100[r] <- df$world_rank[r] <= 100 }
write.csv(df, file) }
Programação Paralela em R

Profiling

Código

library(profvis)


profvis({
for (file in file_list) { df <- read.csv(file) df$top100 <- NA for (r in 1:nrow(df)) { df$top100[r] <- df$Rank[r] <= 100 } write.csv(df, file) }
})

Saída

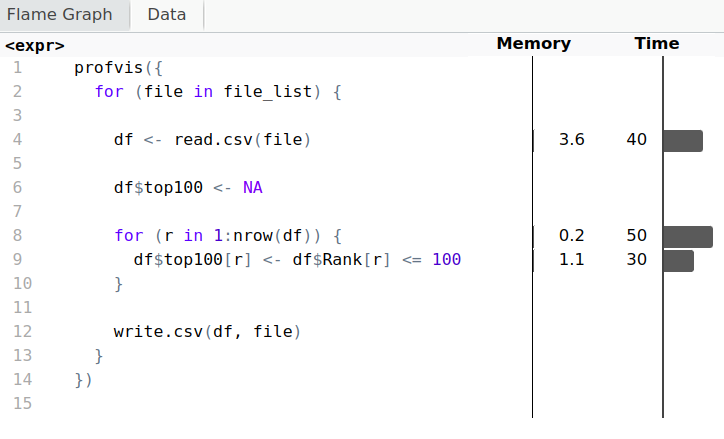
Saída de perfil do profvis(). No código de exemplo, ler dados leva 40 milissegundos e preencher a coluna `top100` leva 80 milissegundos. As demais etapas são quase instantâneas.

Programação Paralela em R

Vamos paralelizar

O loop

  for (file in file_list) {

    df <- read.csv(file)
    df$top100 <- NA

    for (r in 1:nrow(df)) {
      df$top100[r] <- df$Rank[r] <= 100
    }
    write.csv(df, file)
  }

Função

add_col <- function(file_path) {

  df <- read.csv(file_path)
  df$top100 <- NA

  for (r in 1:nrow(df)) {
    df$top100[r] <- df$Rank[r] <= 100
  }
  write.csv(df, file_path)
}


cl <- makeCluster(6)
dummy <- parLapply(cl, file_list, add_col) stopCluster(cl)
Programação Paralela em R

Considerações práticas: número de núcleos

Detectando núcleos

detectCores()
[1] 8

Código paralelizado

cl <- makeCluster(detectCores() - 2)


dummy <- parLapply(cl, file_list, add_col) stopCluster(cl)
Programação Paralela em R

Considerações práticas: tipo de cluster

Cluster PSOCK (padrão)

cl <- makeCluster(detectCores() - 2)
  • Cria cópias da sessão R atual
  • Núcleos não compartilham memória
  • Funciona em qualquer SO (Windows, Mac, Linux)

Cluster FORK

cl <- makeCluster(detectCores() - 2,
                  type = "FORK")
  • Cria subprocessos a partir da sessão R
  • Núcleos compartilham memória (mais rápido que PSOCK)
  • Não funciona no Windows
Programação Paralela em R

Vamos praticar!

Programação Paralela em R

Preparing Video For Download...