Dask DataFrames
Programação Paralela com Dask em Python

James Fulton
Climate Informatics Researcher
pandas DataFrames vs. Dask DataFrames
import pandas as pd# Read a single csv file pandas_df = pd.read_csv( "dataset/chunk1.csv" )
Isso lê um único arquivo CSV imediatamente.
import dask.dataframe as dd# Lazily read all csv files dask_df = dd.read_csv( "dataset/*.csv" )
Isso lê todos os arquivos CSV na pasta dataset de forma preguiçosa.
Dask DataFrames
print(dask_df)
Dask DataFrame Structure:
              ID     col1     col2    col3     col4     ...
npartitions=3
           int64   object   object   int64  float64     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
Dask Name: getitem, 3 tasks
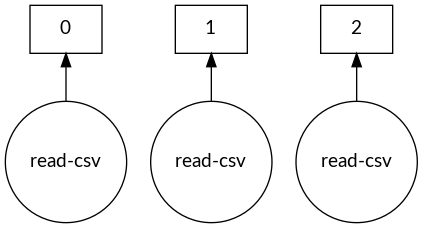
Grafo de tarefas do Dask DataFrame
dask.visualize(dask_df)
Controlando o tamanho dos blocos
# Set the maximum memory of a chunk dask_df = dd.read_csv("dataset/*.csv", blocksize="10MB")print(dask_df)
Dask DataFrame Structure:
              ID     col1     col2    col3     col4     ...
npartitions=7
           int64   object   object   int64  float64     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
             ...      ...      ...     ...      ...     ...
Dask Name: getitem, 7 tasks
Explicando as partições
# Set the maximum memory of a chunk
dask_df = dd.read_csv("dataset/*.csv", blocksize="10MB")
Por que 7 partições?
size      file
  9M      dataset/chunk1.csv
 18M      dataset/chunk2.csv
 32M      dataset/chunk3.csv
Explicando as partições
# Set the maximum memory of a chunk
dask_df = dd.read_csv("dataset/*.csv", blocksize="10MB")
Por que 7 partições?
size      file
  9M      dataset/chunk1.csv    # vira 1 partição
 18M      dataset/chunk2.csv    # vira 2 partições
 32M      dataset/chunk3.csv    # vira 4 partições
Análise com Dask DataFrames
- Selecionar coluna
col1 = dask_df['col1'] - Atribuir colunas
dask_df['double_col1'] = 2 * col1 - Operações matemáticas, por exemplo
dask_df.std()
dask_df.min()
- Groupby
dask_df.groupby(col1).mean() - Até funções que você já usou
dask_df.nlargest(n=3, columns='col1')
Datetimes e outras funcionalidades do pandas
import pandas as pd # Converting string to datetime format pd.to_datetime(pandas_df['start_date'])# Accessing datetime attributes pandas_df['start_date'].dt.year pandas_df['start_date'].dt.day pandas_df['start_date'].dt.hour pandas_df['start_date'].dt.minute
import dask.dataframe as dd # Converting string to datetime format dd.to_datetime(dask_df['start_date'])# Accessing datetime attributes dask_df['start_date'].dt.year dask_df['start_date'].dt.day dask_df['start_date'].dt.hour dask_df['start_date'].dt.minute
Tornando os resultados não preguiçosos
# Show 5 rows
print(dask_df.head())
        ID     double_col1     col1    col2     col3     ...
0   543795              20       10     436        0     ...
1   874535              24       12     268        0     ...
2   781326              62       31     211        0     ...
3   112457              18        9     898        1     ...
4   103256             142       71     663        0     ...
# Convert lazy Dask DataFrame to in-memory pandas DataFrame
results_df = df.compute()
Enviando a resposta direto para arquivo
# 7 partitions (chunks) so 7 output files
dask_df.to_csv('answer/part-*.csv')
part-0.csv
part-1.csv
part-2.csv
part-3.csv
part-4.csv
part-5.csv
part-6.csv
Formatos de arquivo mais rápidos - Parquet
# Read from parquet
dask_df = dd.read_parquet('dataset_parquet')

# Save to parquet
dask_df.to_parquet('answer_parquet')
- O formato Parquet é várias vezes mais rápido para ler dados que CSV
- Pode ser mais rápido para escrever também
Vamos praticar!
Programação Paralela com Dask em Python

