Ajustando SVMs lineares

Support Vector Machines em R

Kailash Awati

Instructor

SVM linear, custo padrão

library(e1071)
svm_model <- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                scale = FALSE)
# Print model summary
svm_model
Call:
svm(formula = y ~ .,
    data = trainset,
    type = "C-classification", 
    kernel = "linear",
    scale = FALSE)

Parameters:
SVM-Type:  C-classification 
 SVM-Kernel:  linear 
       cost:  1 
      gamma:  0.5 
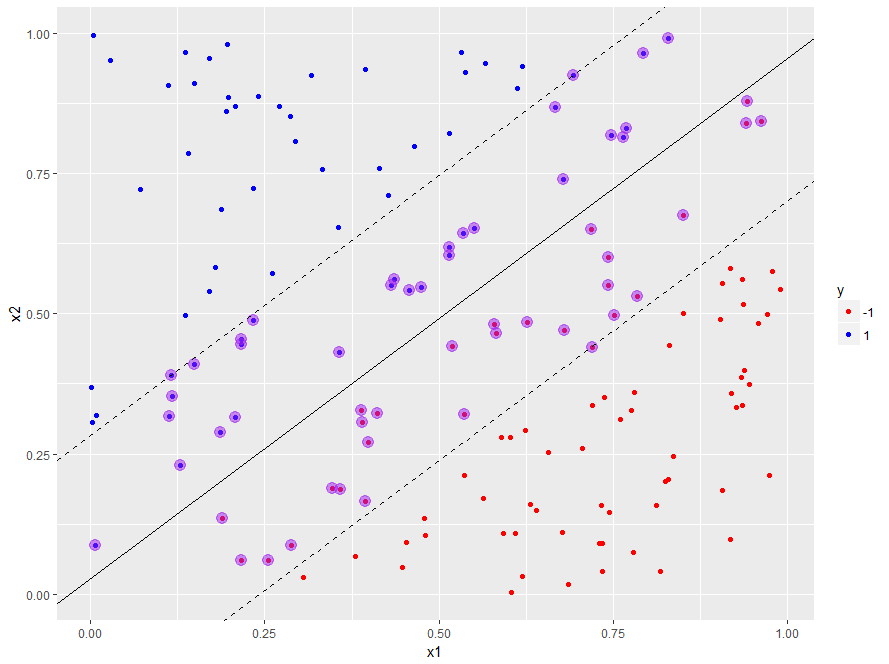
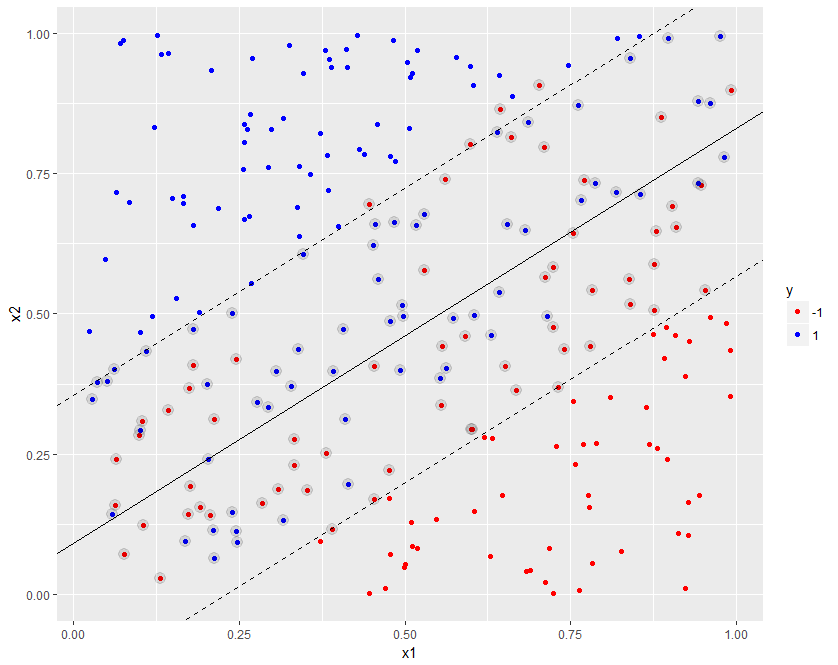
Number of Support Vectors:  55
Support Vector Machines em R

Capítulo 2.3 - conjunto linearmente separável, custo padrão, kernel linear com vetores de suporte e fronteiras de decisão e margem

Support Vector Machines em R

SVM linear com cost = 100

library(e1071)
svm_model <- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                cost = 100,
                scale = FALSE)
# Print model summary
svm_model
Call:
svm(formula = y ~ .,
    data = trainset,
    type = "C-classification", 
    kernel = "linear",
    cost = 100,
    scale = FALSE)

Parameters:
SVM-Type:  C-classification 
 SVM-Kernel:  linear 
       cost:  100 
      gamma:  0.5 
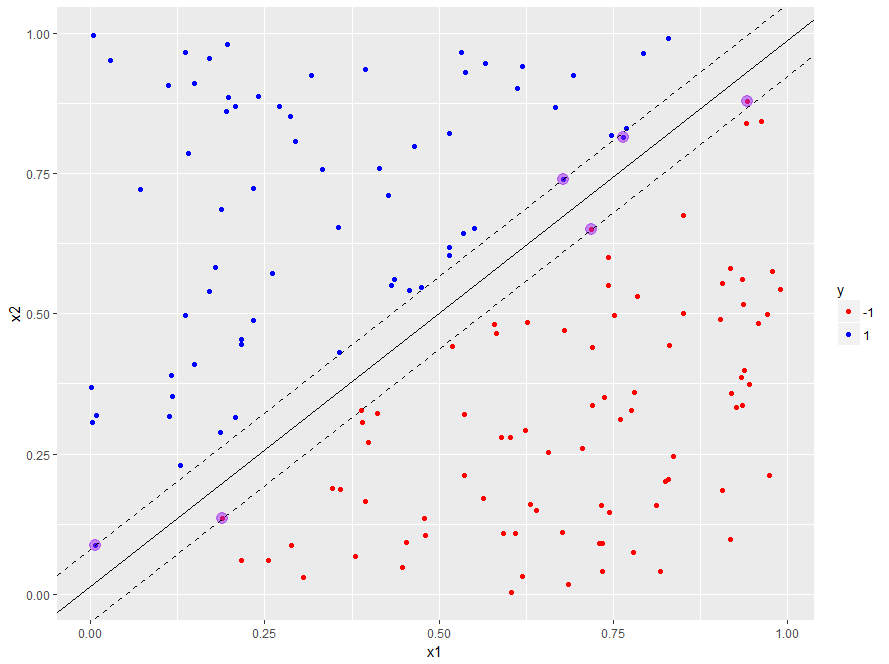
Number of Support Vectors:  6
Support Vector Machines em R

Capítulo 2.3 - dados linearmente separáveis, cost = 100, kernel linear com vetores de suporte e fronteiras de decisão e margem

Support Vector Machines em R

Implicação

  • Pode ser útil reduzir a margem se a fronteira de decisão for linear
  • ...mas isso raramente ocorre na prática
Support Vector Machines em R

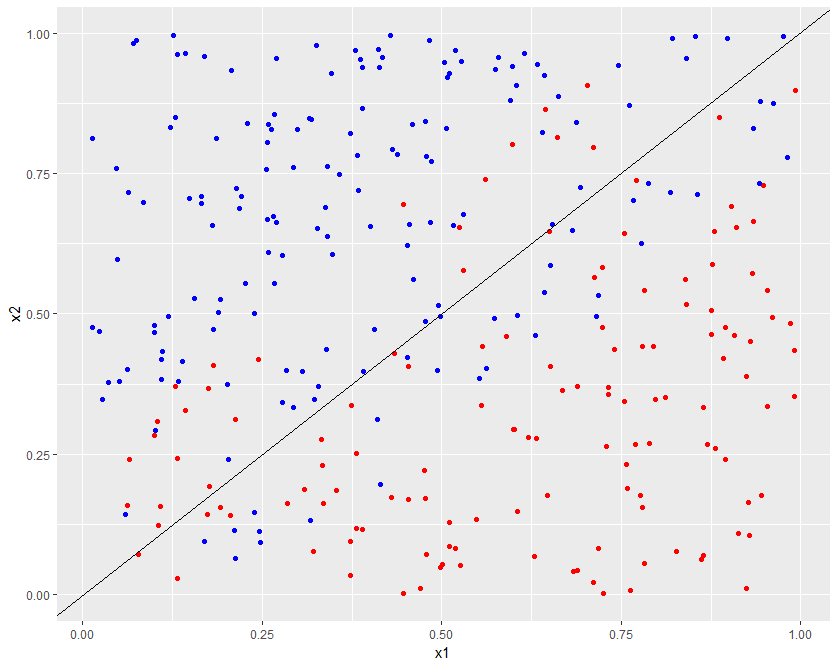
Capítulo 2.3 - conjunto não linearmente separável

Support Vector Machines em R

Conjunto não linear, SVM linear (cost = 100)

  • Construa o modelo com cost=100 usando 80% dos dados para treino
# Build model
library(e1071)
svm_model<- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                cost = 100,
                scale = FALSE)
  • Calcule a acurácia
# Train and test accuracy
pred_train <- predict(svm_model, trainset)
mean(pred_train == trainset$y)
0.8208333
pred_test <- predict(svm_model, testset)
mean(pred_test == testset$y)
0.85
  • Acurácia média no teste em 50 divisões aleatórias treino/teste: 82,9%
Support Vector Machines em R

Capítulo 2.3 - conjunto não linearmente separável, cost=100, kernel linear com vetores de suporte e fronteiras de decisão e margem

Support Vector Machines em R

Conjunto não linear, SVM linear (cost = 1)

  • Reconstrua o modelo com cost = 1
# Trainset contains 80% of data
# Same train/test split as before.
# Build model
svm_model <- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                cost = 1,
                scale = FALSE)
  • Calcule a acurácia no teste
# Test accuracy
pred_test <- predict(svm_model, testset)
mean(pred_test == testset$y)
0.8666667
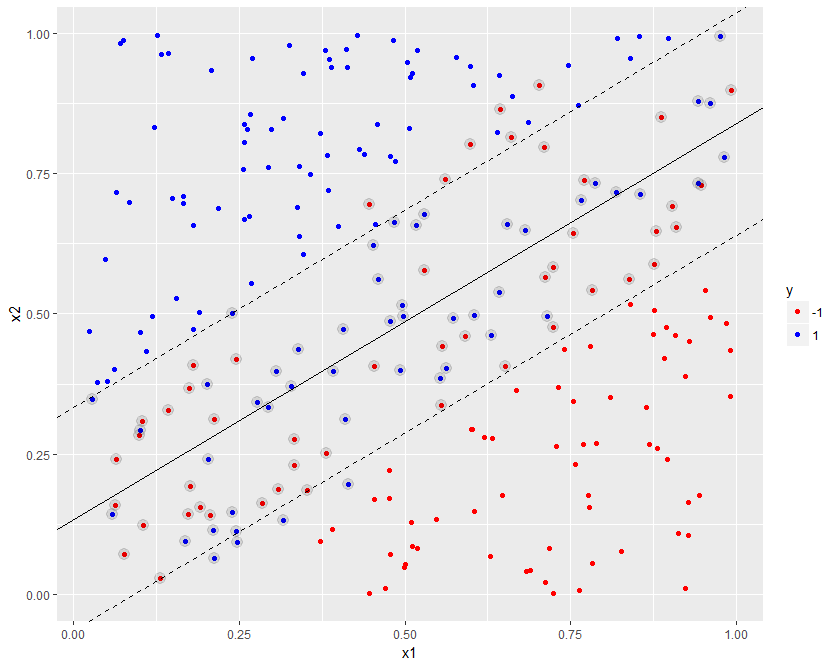
  • Acurácia média no teste em 50 divisões aleatórias treino/teste: 83,7%
Support Vector Machines em R

Capítulo 2.3 - conjunto não linearmente separável, cost=1, kernel linear com vetores de suporte e fronteiras de decisão e margem

Support Vector Machines em R

Vamos praticar!

Support Vector Machines em R

Preparing Video For Download...