Imputação múltipla por bootstrapping

Tratamento de Dados Ausentes com Imputações em R

Michal Oleszak

Machine Learning Engineer

Incerteza da imputação

  • Imputação é geralmente o primeiro passo antes da análise ou modelagem.
  • Valores ausentes são estimados com alguma incerteza.
  • Essa incerteza deve ser considerada em qualquer análise feita com dados imputados.
O cabeçalho da página de título do artigo de Ranjit Lall intitulado "How Multiple Imputation Makes a Difference."

Em quase metade dos estudos, resultados-chave desaparecem

Tratamento de Dados Ausentes com Imputações em R

Bootstrap

Bootstrapping = amostrar linhas com reposição para obter dados do tamanho original
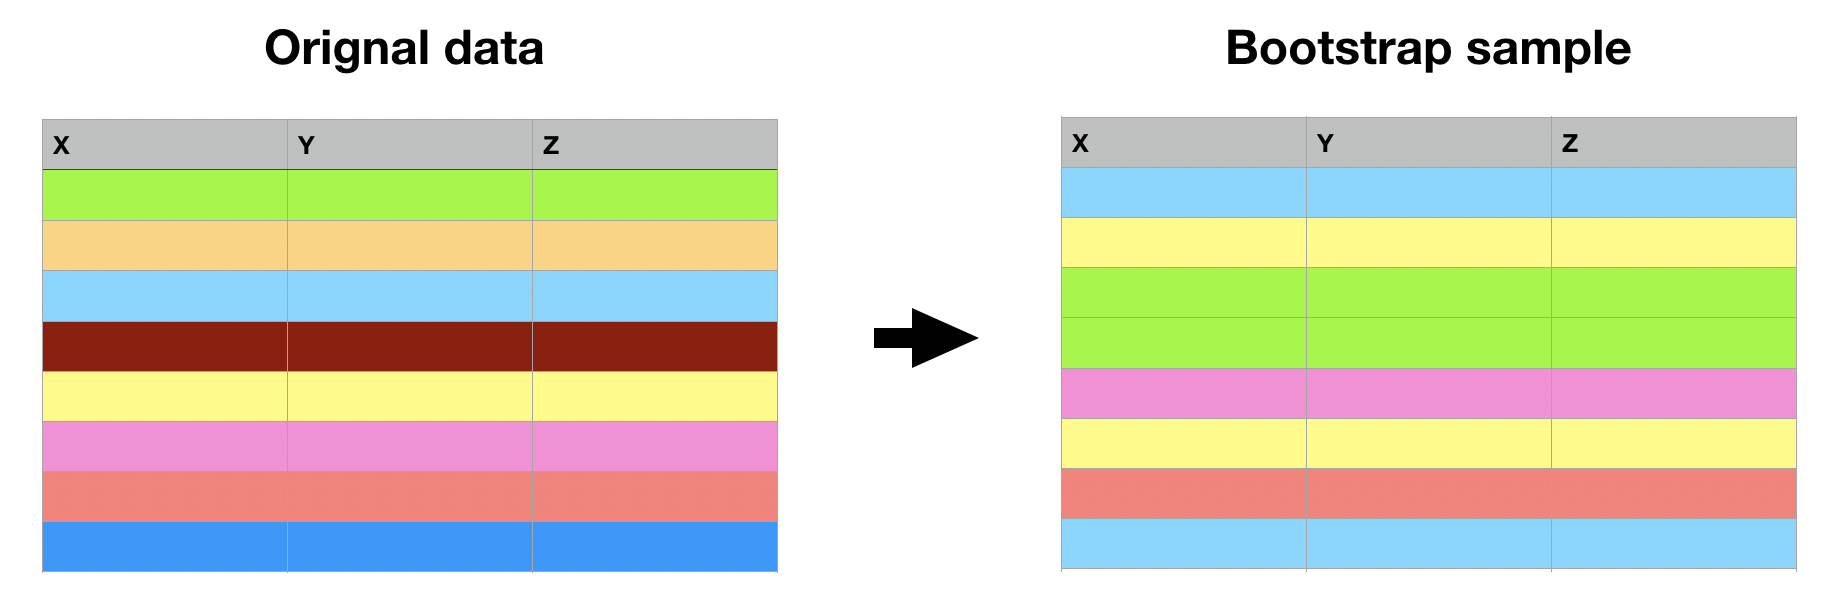
Dois data frames de exemplo. O da esquerda, "original data", tem cada linha em uma cor diferente, indicando valores distintos. No da direita, "bootstrapped sample", algumas linhas coloridas do "original data" aparecem mais de uma vez e outras não aparecem.

Tratamento de Dados Ausentes com Imputações em R

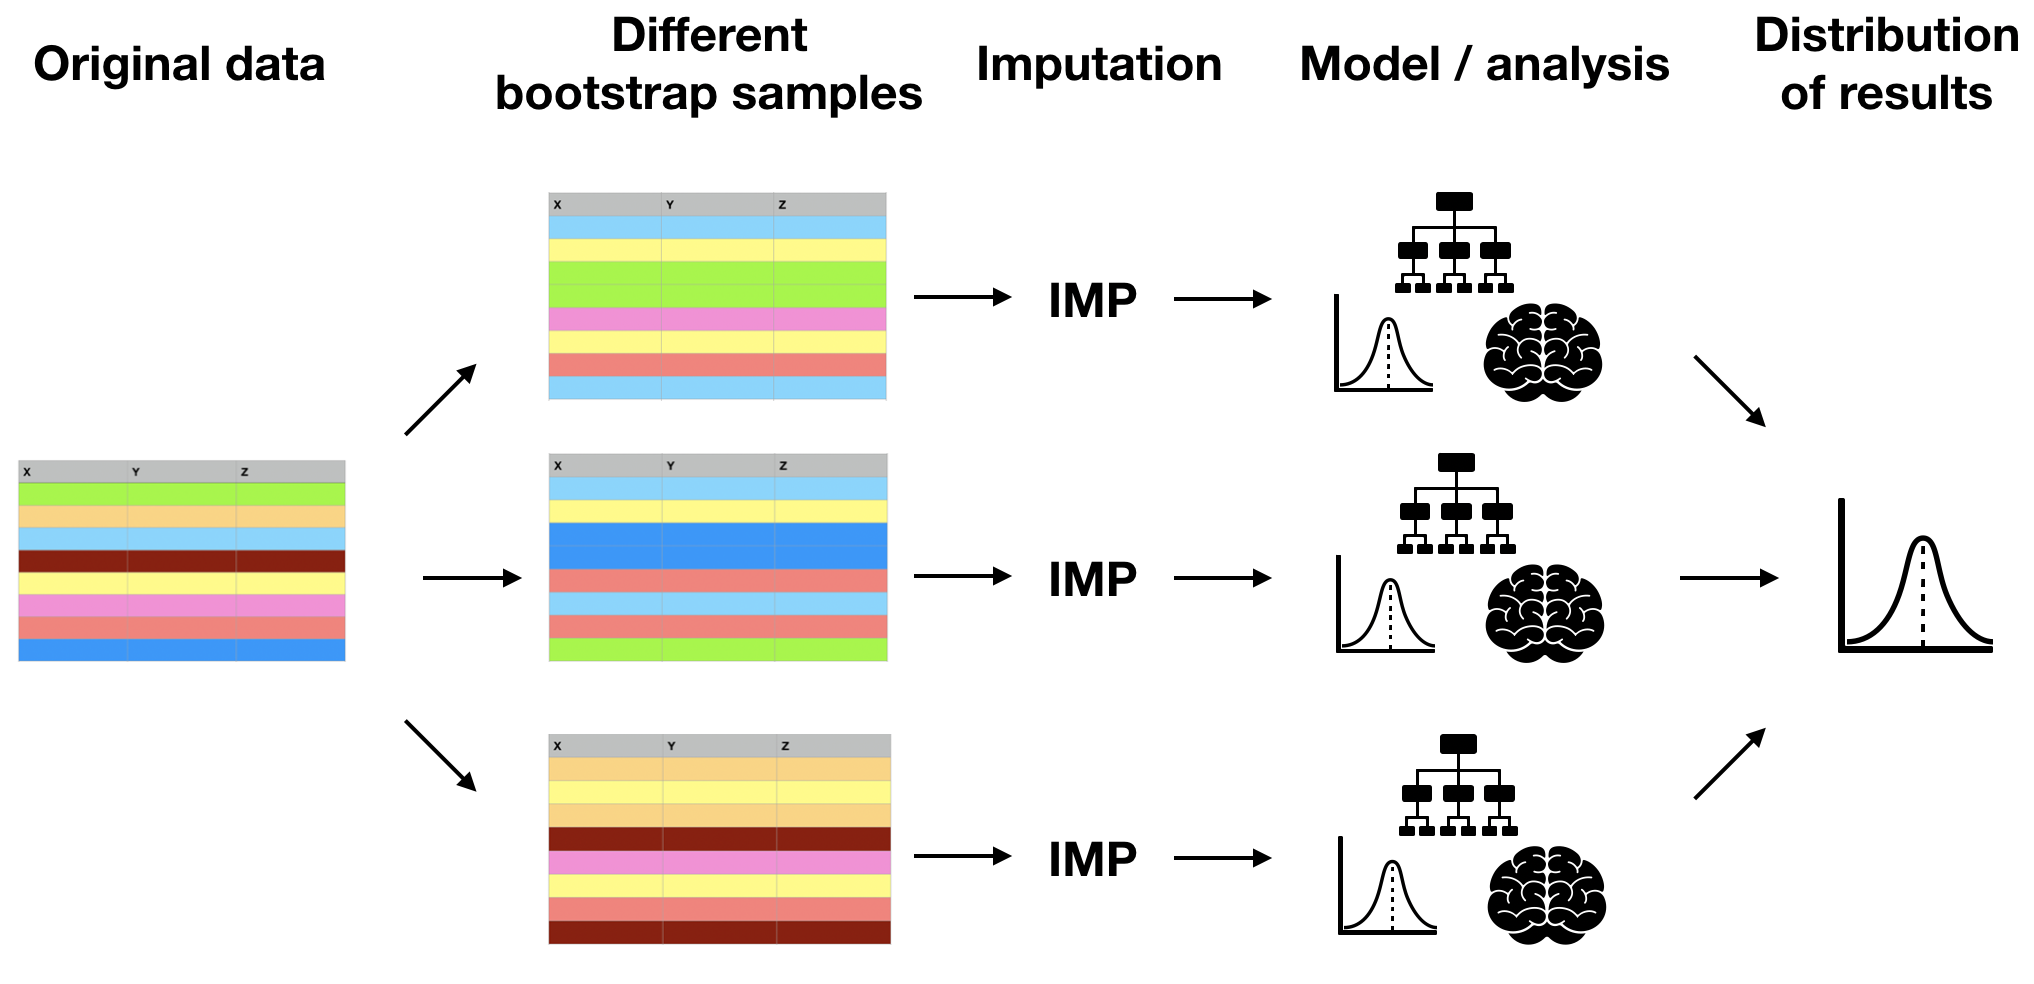
Imputação múltipla por bootstrapping

Um diagrama com cinco etapas da imputação por bootstrapping. De um data frame de exemplo, chamado "original data", três setas apontam para três outros data frames chamados "different bootstrap samples". De cada um, uma seta aponta para a etapa "Imputation". Dali, setas apontam para "Modeling / analysis". Dali, setas apontam para um único nó final chamado "Distribution of results".

Tratamento de Dados Ausentes com Imputações em R

Imputação com bootstrap: prós e contras

Prós:

  • Funciona com qualquer método de imputação.
  • Aproxima quantidades difíceis de calcular analiticamente.
  • Funciona com dados MCAR e MAR.

Contras:

  • Lento com muitas réplicas ou computações demoradas.
Tratamento de Dados Ausentes com Imputações em R

Bootstrapping na prática

calc_correlation <- function(data, indices) {


  # Return the correlation coefficient
  return(corr_coeff)
}
Tratamento de Dados Ausentes com Imputações em R

Bootstrapping na prática

calc_correlation <- function(data, indices) {
  # Get bootstrap sample
  data_boot <- data[indices, ]


  # Return the correlation coefficient
  return(corr_coeff)
}
Tratamento de Dados Ausentes com Imputações em R

Bootstrapping na prática

calc_correlation <- function(data, indices) {
  # Get bootstrap sample
  data_boot <- data[indices, ]
  # Impute with kNN imputation
  data_imp <- kNN(data_boot)


  # Return the correlation coefficient
  return(corr_coeff)
}
Tratamento de Dados Ausentes com Imputações em R

Bootstrapping na prática

calc_correlation <- function(data, indices) {
  # Get bootstrap sample
  data_boot <- data[indices, ]
  # Impute with kNN imputation
  data_imp <- kNN(data_boot)
  # Calculate correlation between Weight and TotChol
  corr_coeff <- cor(data_imp$Weight, data_imp$TotChol)
  # Return the correlation coefficient
  return(corr_coeff)
}
Tratamento de Dados Ausentes com Imputações em R

Bootstrapping na prática

library(boot)
boot_results <- boot(nhanes, statistic = calc_correlation, R = 50)
print(boot_results)
ORDINARY NONPARAMETRIC BOOTSTRAP

Call:
boot(data = nhanes, statistic = calc_correlation, R = 50)

Bootstrap Statistics :
      original      bias    std. error
t1* 0.03028306 0.007385452  0.04207152
Tratamento de Dados Ausentes com Imputações em R

Plotando resultados do bootstrap

plot(boot_results)
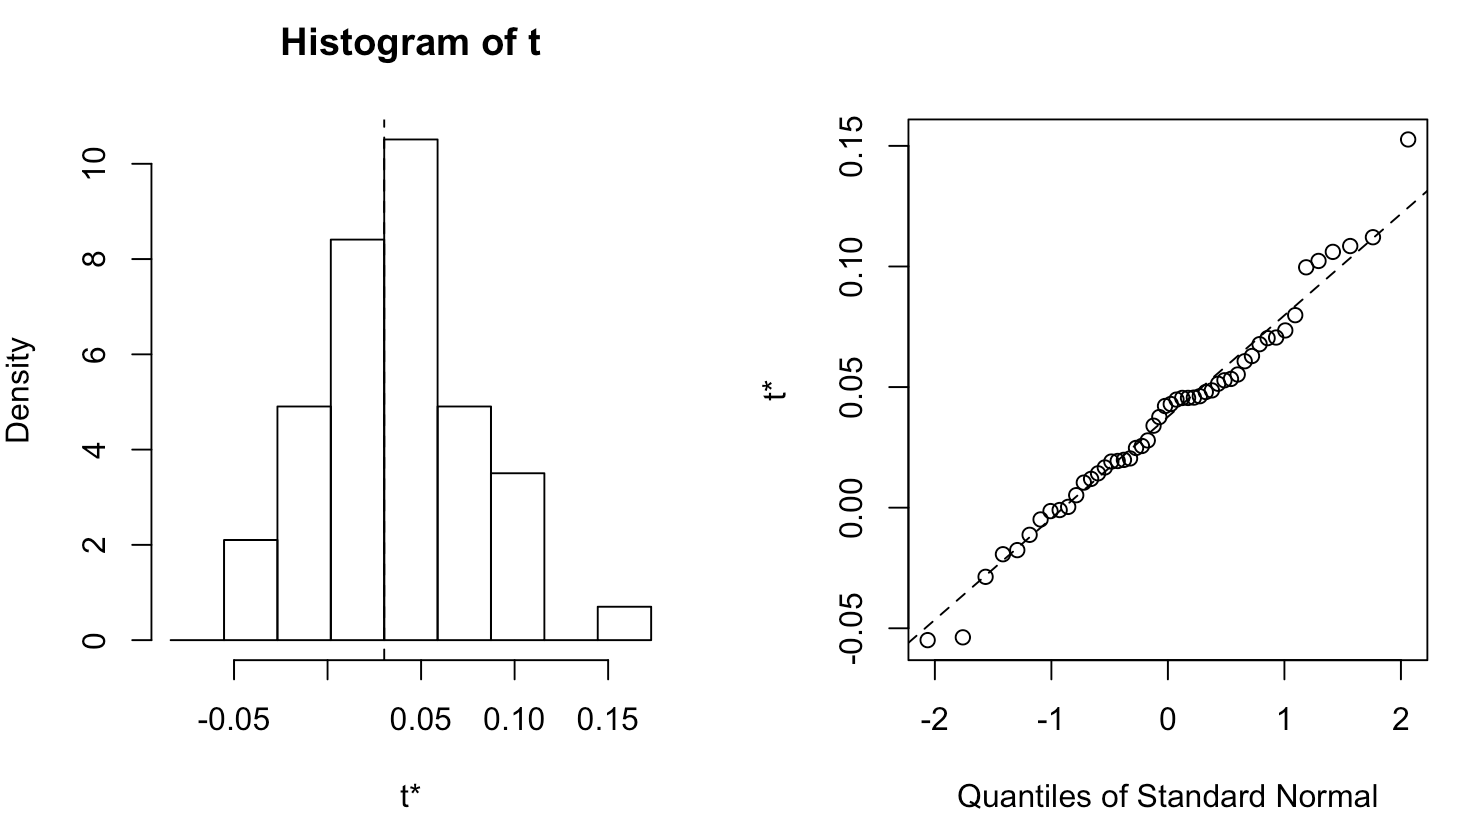
Um histograma e um gráfico Q-Q mostrando a distribuição dos resultados do bootstrap. Ambos sugerem distribuição próxima da normal.

Tratamento de Dados Ausentes com Imputações em R

Intervalos de confiança via bootstrap

boot_ci <- boot.ci(boot_results, conf = 0.95, type = "norm")
print(boot_ci)
BOOTSTRAP CONFIDENCE INTERVAL CALCULATIONS
Based on 50 bootstrap replicates

CALL : 
boot.ci(boot.out = boot_results, conf = 0.95, type = "norm")

Intervals : 
Level      Normal        
95%   (-0.0596,  0.1054 )  
Calculations and Intervals on Original Scale
Tratamento de Dados Ausentes com Imputações em R

Vamos praticar bootstrapping!

Tratamento de Dados Ausentes com Imputações em R

Preparing Video For Download...