Imputação baseada em árvores
Tratamento de Dados Ausentes com Imputações em R

Michal Oleszak
Machine Learning Engineer
Abordagem de imputação baseada em árvores
Use modelos de Machine Learning para prever valores ausentes!
- Abordagem não paramétrica: sem suposições sobre relações entre variáveis.
- Captura padrões não lineares complexos.
- Geralmente tem melhor desempenho preditivo que modelos estatísticos simples.
Neste curso: pacote missForest, baseado em randomForest
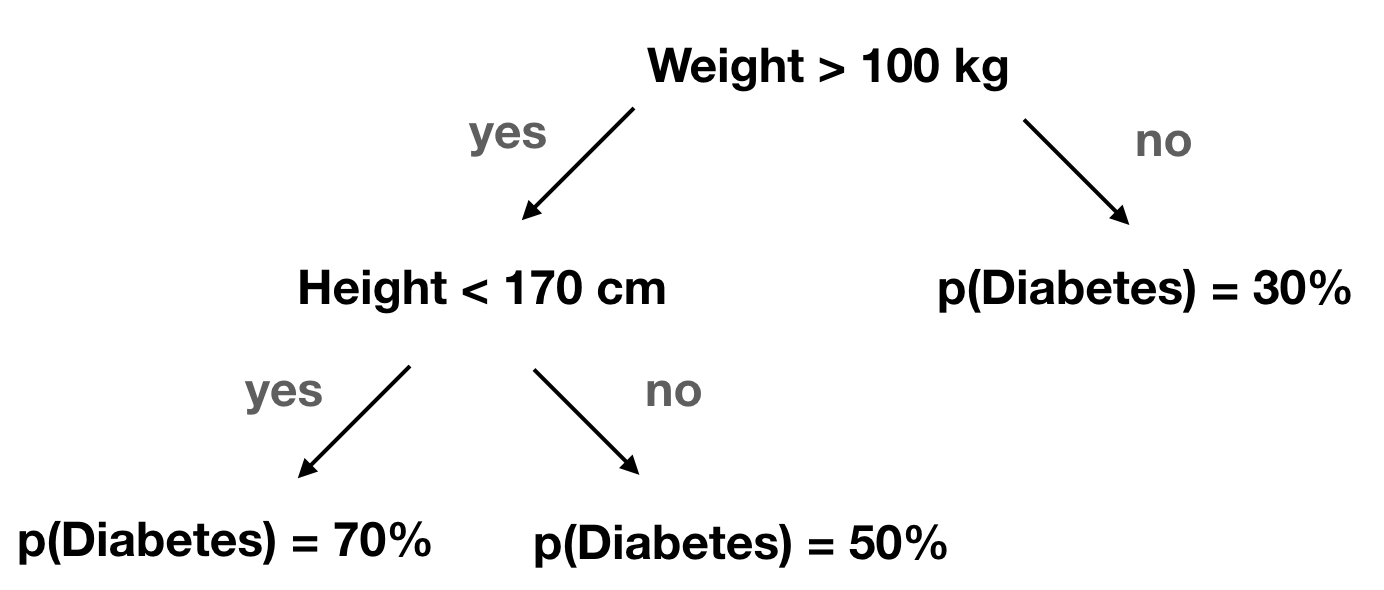
Árvores de decisão
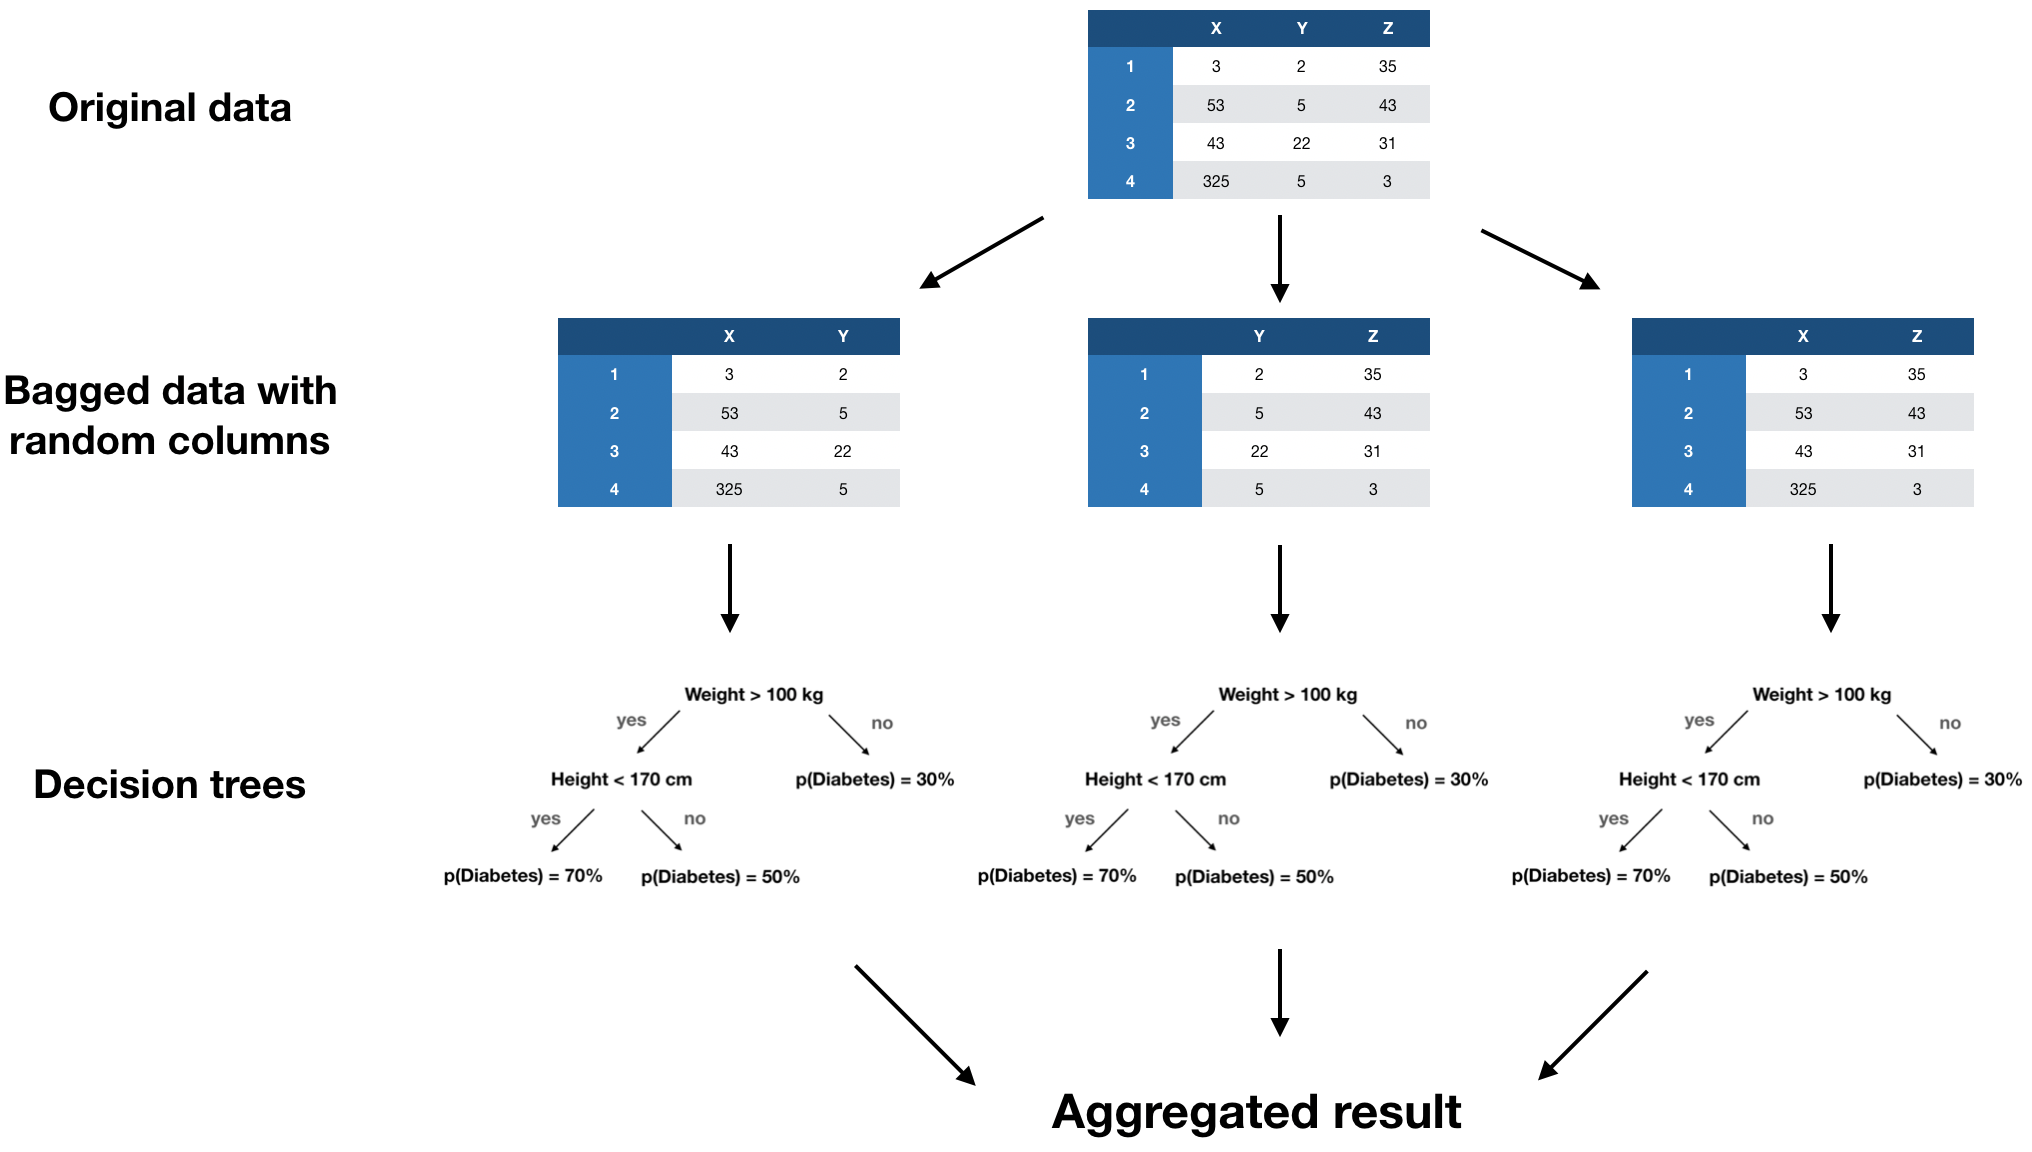
Random forests
Algoritmo missForest
- Faça um palpite inicial para valores ausentes com imputação pela média.
- Ordene as variáveis em ordem crescente pela quantidade de ausências.
- Para cada variável x:
- Ajuste um random forest à parte observada de x (usando outras variáveis como preditoras).
- Use-o para prever a parte ausente de x.
- Repita o passo 3 até que os valores imputados quase não mudem mais.
missForest na prática
nhanes %>% is.na() %>% colSums()
Age     Gender     Weight     Height   Diabetes    TotChol      Pulse PhysActive
  0          0          9          8          1         85         32         26
library(missForest)
imp_res <- missForest(nhanes)
nhanes_imp  <- imp_res$ximp
nhanes_imp %>% is.na() %>% colSums()
Age     Gender     Weight     Height   Diabetes    TotChol      Pulse PhysActive
  0          0          0          0          0          0          0          0
Erro de imputação
missForest() fornece uma estimativa de erro OOB (out-of-bag) da imputação:
- NRMSE (normalized root mean squared error) para variáveis contínuas.
- Proporção de classificações incorretas (PFC) para variáveis categóricas.
Em ambos os casos, bom desempenho leva a valor próximo de 0; valores perto de 1 indicam resultado ruim.
imp_res <- missForest(nhanes)
imp_res$OOBerror
      NRMSE         PFC
0.147687025 0.003676471
Erro de imputação
missForest() fornece uma estimativa de erro OOB (out-of-bag) da imputação:
- NRMSE (normalized root mean squared error) para variáveis contínuas.
- Proporção de classificações incorretas (PFC) para variáveis categóricas.
Em ambos os casos, bom desempenho leva a valor próximo de 0; valores perto de 1 indicam resultado ruim.
imp_res <- missForest(nhanes, variablewise = TRUE)
imp_res$OOBerror
    MSE       PFC       MSE       MSE       PFC       MSE       MSE       MSE
0.00000   0.00000 285.79563  40.42142   0.00735   0.53444 129.03609   0.17576
Compromisso entre velocidade e acurácia
Treinar múltiplos random forests pode levar tempo.
Ideia: abrir mão de um pouco de acurácia e reduzir o tamanho da floresta para diminuir o tempo de computação.
- Reduza o número de árvores em cada floresta (argumento
ntree). - Reduza o número de variáveis usadas nas divisões (argumento
mtry).
O impacto no tempo de execução varia:
- Reduzir
ntreetem efeito linear. - Reduzir
mtryacelera mais quando há muitas variáveis.
Compromisso velocidade × acurácia na prática
Configurações padrão:
start_time <- Sys.time()
imp_res <- missForest(nhanes)
end_time <- Sys.time()
print(imp_res$OOBerror)
print(end_time - start_time)
      NRMSE         PFC
0.147687025 0.003676471
Time difference of 5.496582 secs
Florestas reduzidas:
start_time <- Sys.time()
imp_res <- missForest(nhanes,
                      ntree = 10,
                      mtry = 2)
end_time <- Sys.time()
print(imp_res$OOBerror)
print(end_time - start_time)
      NRMSE         PFC
0.162420139 0.007425743
Time difference of 0.516367 secs
Vamos praticar!
Tratamento de Dados Ausentes com Imputações em R

