Imputação pela média

Tratamento de Dados Ausentes com Imputações em R

Michal Oleszak

Machine Learning Engineer

Vocabulário de imputação

Imputação = estimar, com base em evidências, quais seriam os valores ausentes

  • Imputação baseada em doador - valores ausentes são preenchidos usando outras observações completas.
  • Imputação baseada em modelo - valores ausentes são previstos com um modelo estatístico ou de machine learning.

Este capítulo foca métodos baseados em doador:

  • Imputação pela média
  • Hot-deck imputation
  • Imputação kNN
Tratamento de Dados Ausentes com Imputações em R

Imputação pela média

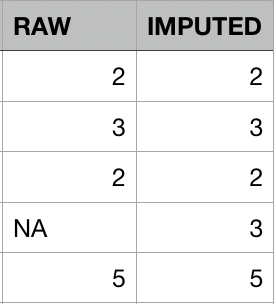
Uma tabela com duas colunas: uma com dados brutos, contendo um valor ausente, e outra com dados imputados, igual à anterior, mas com o valor ausente imputado pela média.

A imputação pela média funciona bem para séries temporais que oscilam aleatoriamente em torno de uma média de longo prazo.

Para dados seccionais, imputar pela média costuma ser uma péssima escolha:

  • Destrói relações entre variáveis.
  • Não há variância nos valores imputados.
Tratamento de Dados Ausentes com Imputações em R

Imputação pela média na prática

Tarefa: imputar pela média Height e Weight nos dados NHANES.

  • Crie indicadores binários para marcar se cada valor era originalmente ausente.
nhanes <- nhanes %>% 
  mutate(Height_imp = ifelse(is.na(Height), TRUE, FALSE)) %>% 
  mutate(Weight_imp = ifelse(is.na(Weight), TRUE, FALSE))
  • Substitua os ausentes em Height e Weight por suas respectivas médias.
nhanes_imp <- nhanes %>% 
  mutate(Height = ifelse(is.na(Height), mean(Height, na.rm = TRUE), Height)) %>% 
  mutate(Weight = ifelse(is.na(Weight), mean(Weight, na.rm = TRUE), Weight))
Tratamento de Dados Ausentes com Imputações em R

Dados NHANES imputados pela média

nhanes_imp %>%
    select(Weight, Height, Height_imp, Weight_imp) %>%
    head()
     Weight   Height Height_imp Weight_imp
1  73.20000 166.2499       TRUE      FALSE
2  72.30000 166.2499       TRUE      FALSE
3  57.70000 158.9000      FALSE      FALSE
4  88.90000 183.3000      FALSE      FALSE
5  45.10000 157.6000      FALSE      FALSE
6  66.77065 158.4000      FALSE       TRUE
Tratamento de Dados Ausentes com Imputações em R

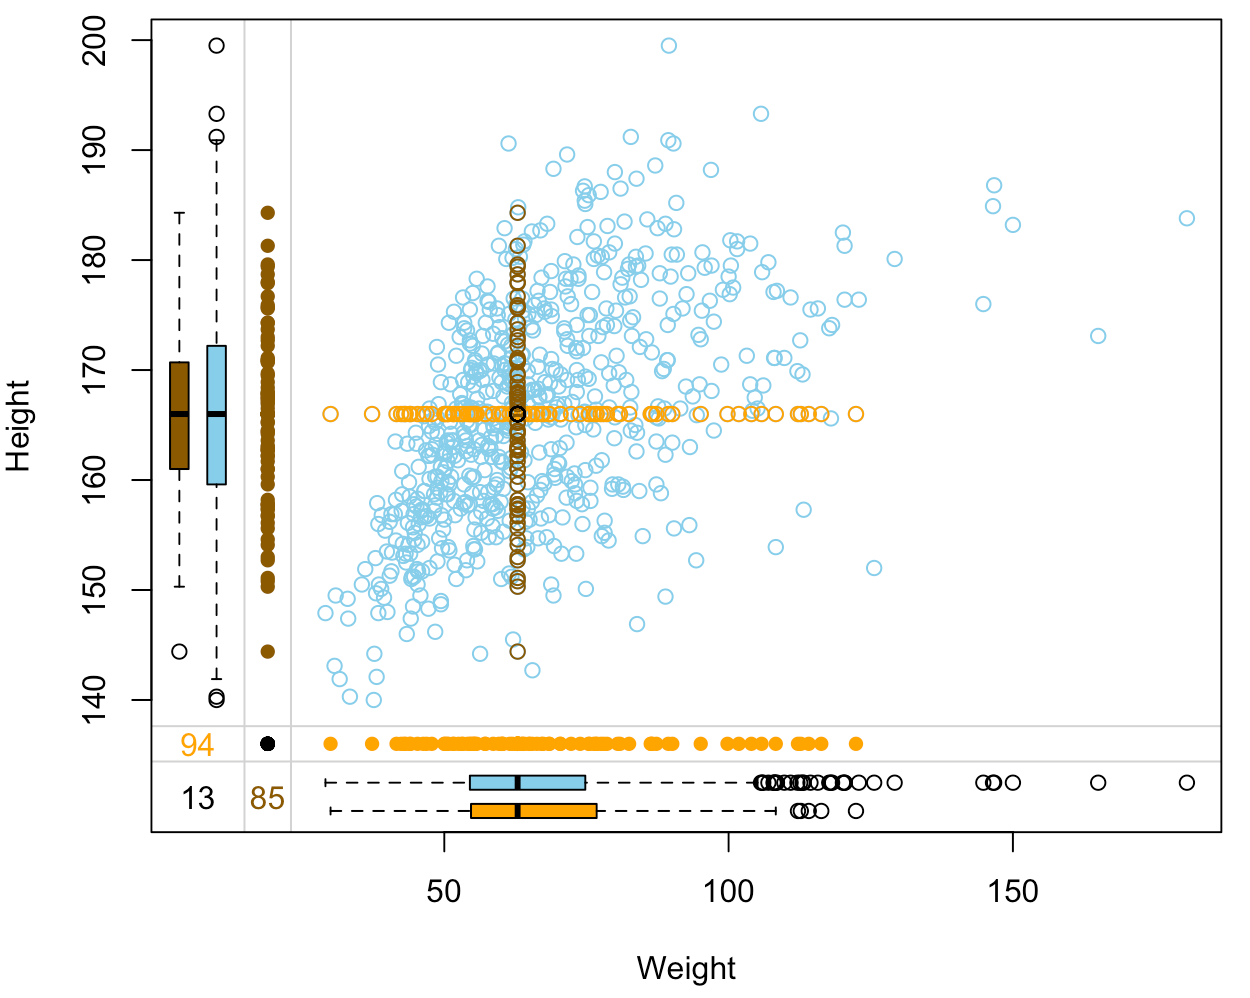
Avaliando a qualidade: margin plot

nhanes_imp %>% select(Weight, Height, Height_imp, Weight_imp) %>% marginplot(delimiter="imp")
Um margin plot, um diagrama de dispersão de "Height" vs "Weight", em que valores imputados em qualquer uma das duas variáveis são destacados em cor diferente.

Tratamento de Dados Ausentes com Imputações em R

Problemas da imputação pela média

Destruindo a relação entre variáveis:

  • Após imputar Height e Weight pela média, sua correlação positiva fica mais fraca.
  • Modelos que predizem uma usando a outra serão enganados pelos valores imputados extremos e produzirão vieses.

Sem variabilidade nos dados imputados:

  • Com menos variância, todos os erros-padrão serão subestimados. Isso impede testes de hipótese e intervalos de confiança confiáveis.
Tratamento de Dados Ausentes com Imputações em R

Imputação por mediana e moda

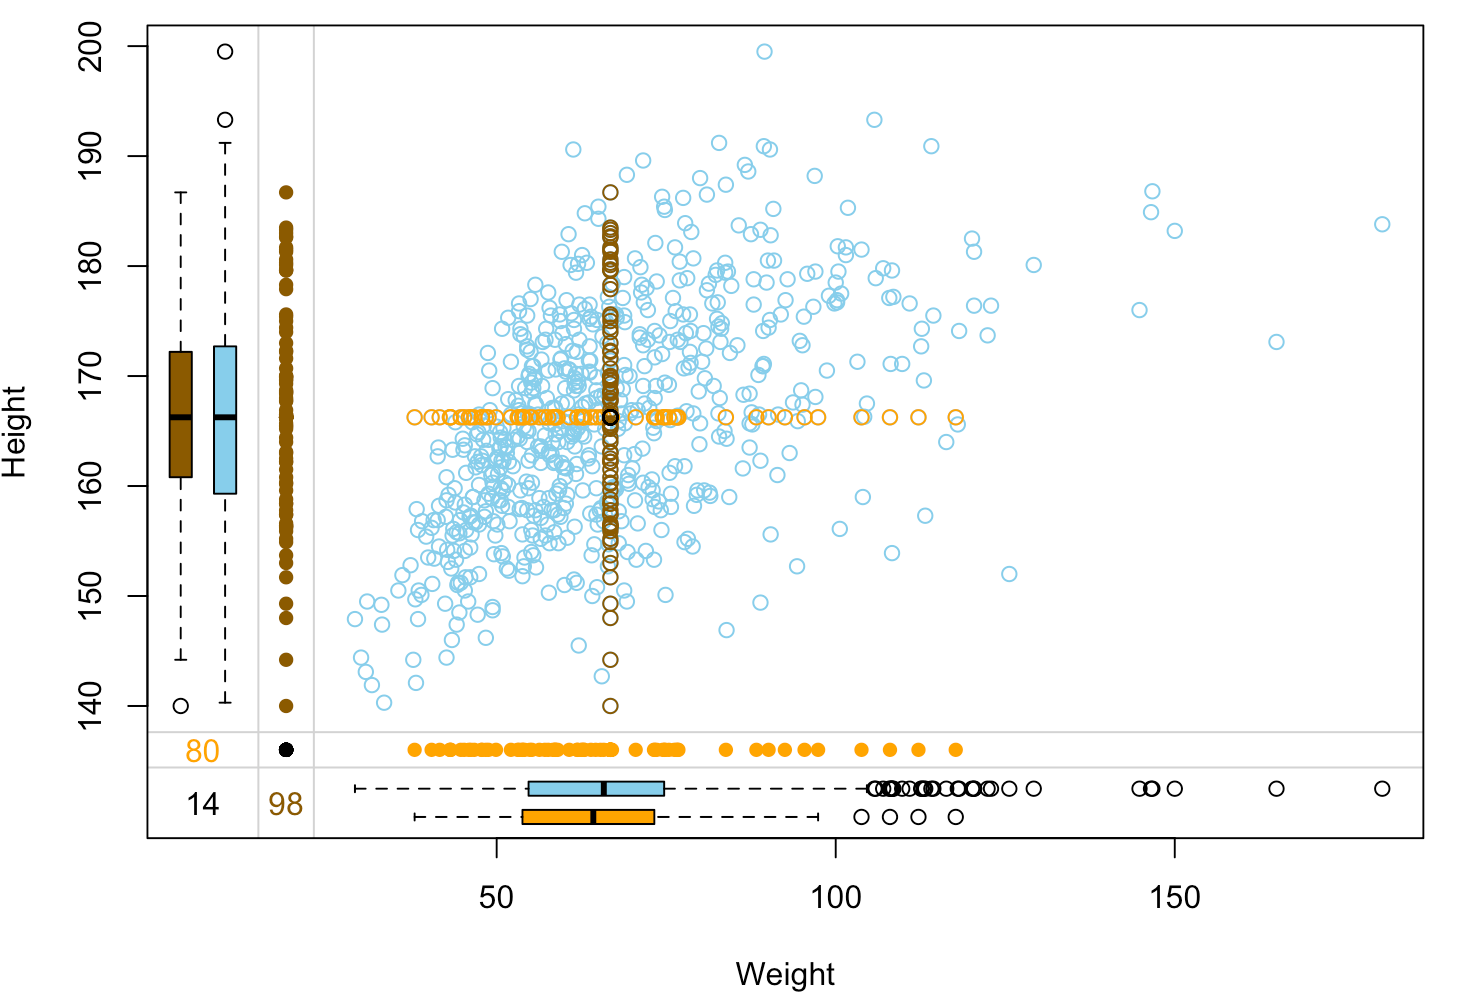
  • Em vez da média, dá para imputar com a mediana ou a moda.
  • A mediana é melhor quando há outliers nos dados.
  • Para variáveis categóricas, não dá para calcular média nem mediana; usa-se a moda.
  • Mediana e moda têm os mesmos problemas da imputação pela média.

Um margin plot, um diagrama de dispersão de "Height" vs "Weight", em que valores imputados em qualquer uma das duas variáveis são destacados em cor diferente.

Tratamento de Dados Ausentes com Imputações em R

Vamos praticar!

Tratamento de Dados Ausentes com Imputações em R

Preparing Video For Download...