Imputação por k-Nearest Neighbors

Tratamento de Dados Ausentes com Imputações em R

Michal Oleszak

Machine Learning Engineer

Imputação por k-Nearest Neighbors
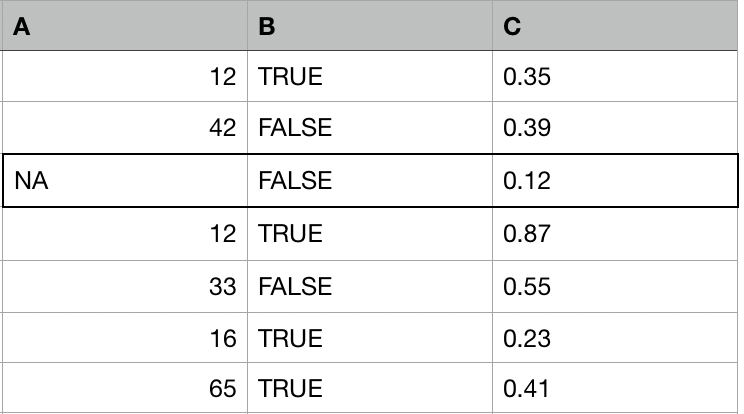
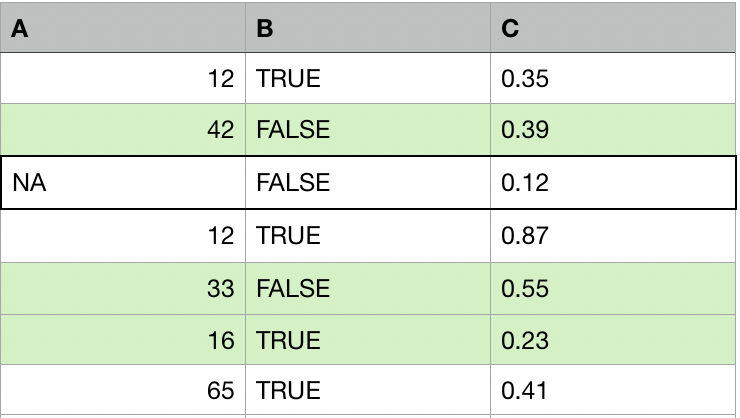
Uma tabela com três colunas: A, B e C. Há um valor ausente na coluna A.

Tratamento de Dados Ausentes com Imputações em R

Imputação por k-Nearest Neighbors

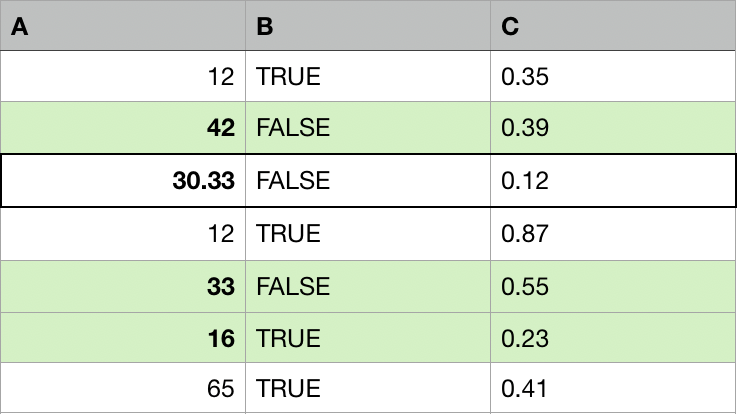
Uma tabela com três colunas: A, B e C. Há um valor ausente na coluna A. Três linhas sem o valor ausente estão destacadas em cores.

Para cada observação com valores ausentes:

  1. Encontre outras k observações (doadores, vizinhos) mais semelhantes a ela.
Tratamento de Dados Ausentes com Imputações em R

Imputação por k-Nearest Neighbors

Uma tabela com três colunas: A, B e C. Três linhas sem o valor ausente estão destacadas em cores. O valor antes ausente em A foi substituído pela média dos números na mesma coluna das linhas destacadas.

Para cada observação com valores ausentes:

  1. Encontre outras k observações (doadores, vizinhos) mais semelhantes a ela.
  2. Substitua os valores ausentes por valores agregados dos k doadores (média, mediana, moda).
Tratamento de Dados Ausentes com Imputações em R

Medidas de distância

A distância entre duas observações a e b:

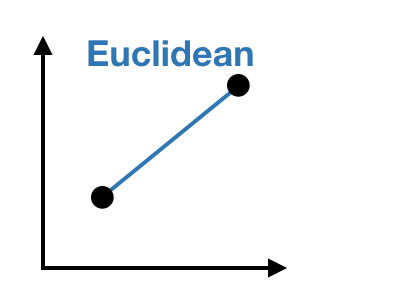
Distância Euclidiana para n variáveis numéricas:

$\sqrt{\Sigma_{i=1}^{n} (a_i - b_i)^{2}}$

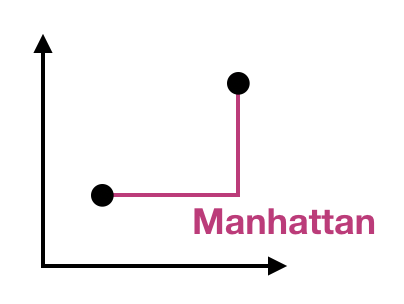
Distância Manhattan para f variáveis fator:

$\Sigma_{i=1}^{f} |a_i - b_i|$

Distância Hamming para c variáveis categóricas:

$\Sigma_{i=1}^{c} I(a_i \neq b_i)$

Um sistema de coordenadas com dois pontos conectados por uma linha reta.

Um sistema de coordenadas com dois pontos conectados por duas linhas perpendiculares, como se fossem cantos opostos de um retângulo.

Tratamento de Dados Ausentes com Imputações em R

Distância de Gower

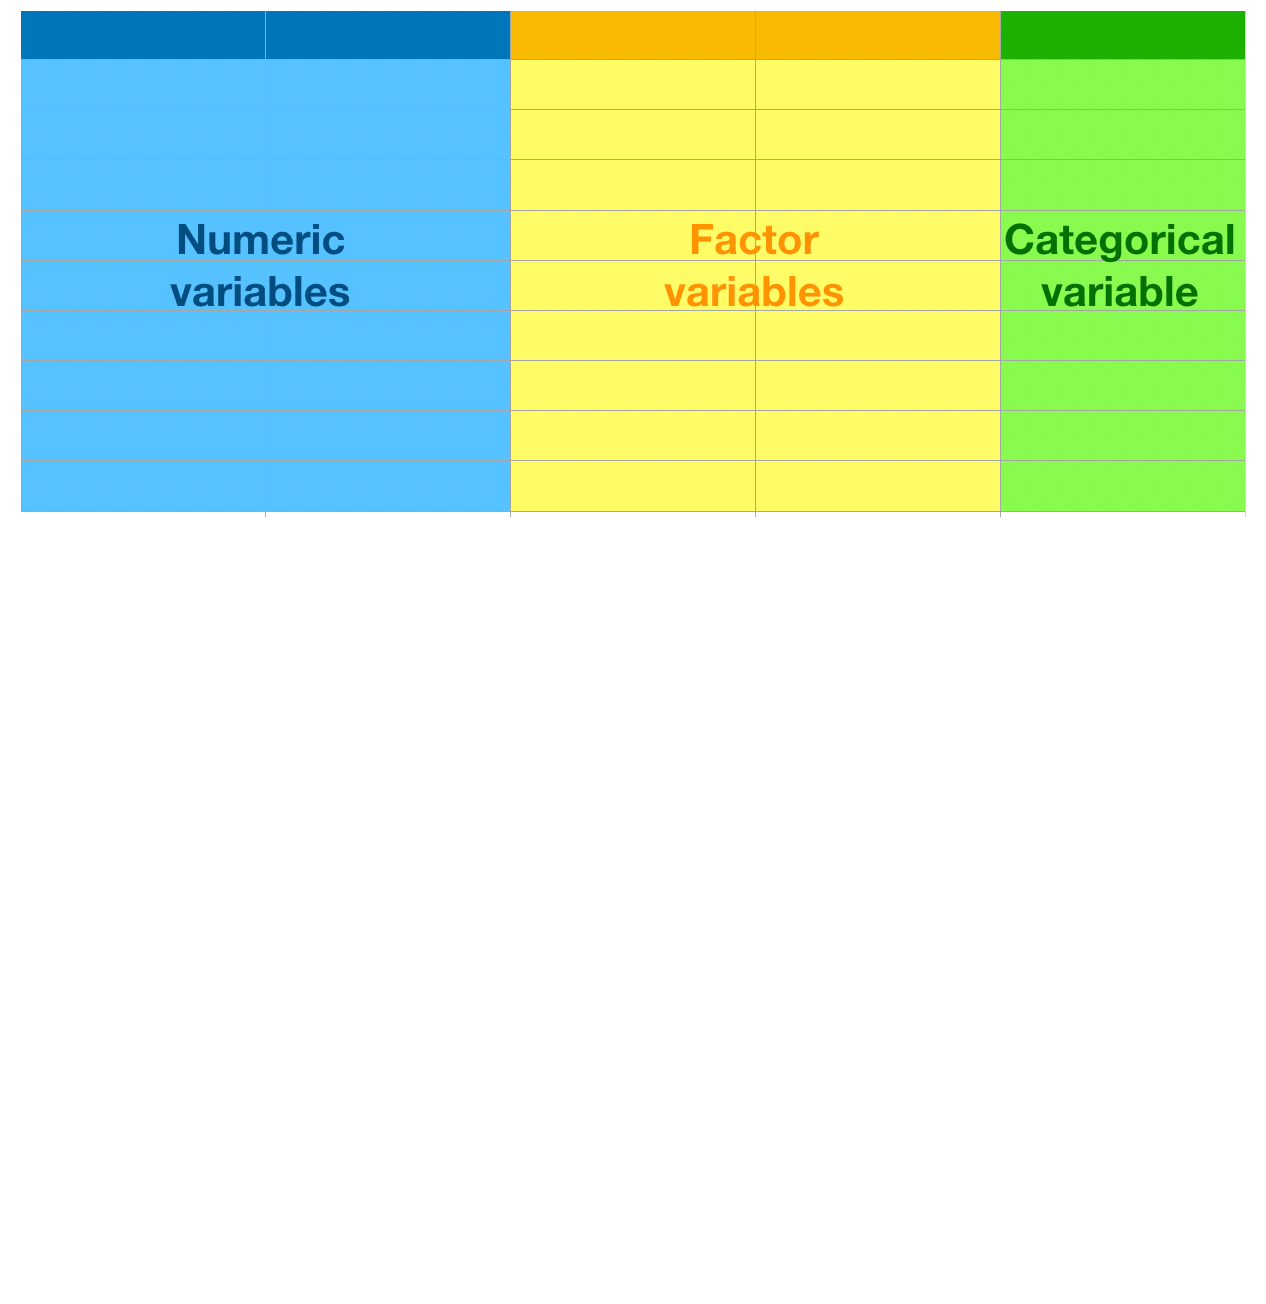
Um data frame simulado contendo três tipos de variáveis, cada um destacado com uma cor: numéricas, fator e categóricas.

Tratamento de Dados Ausentes com Imputações em R

Distância de Gower

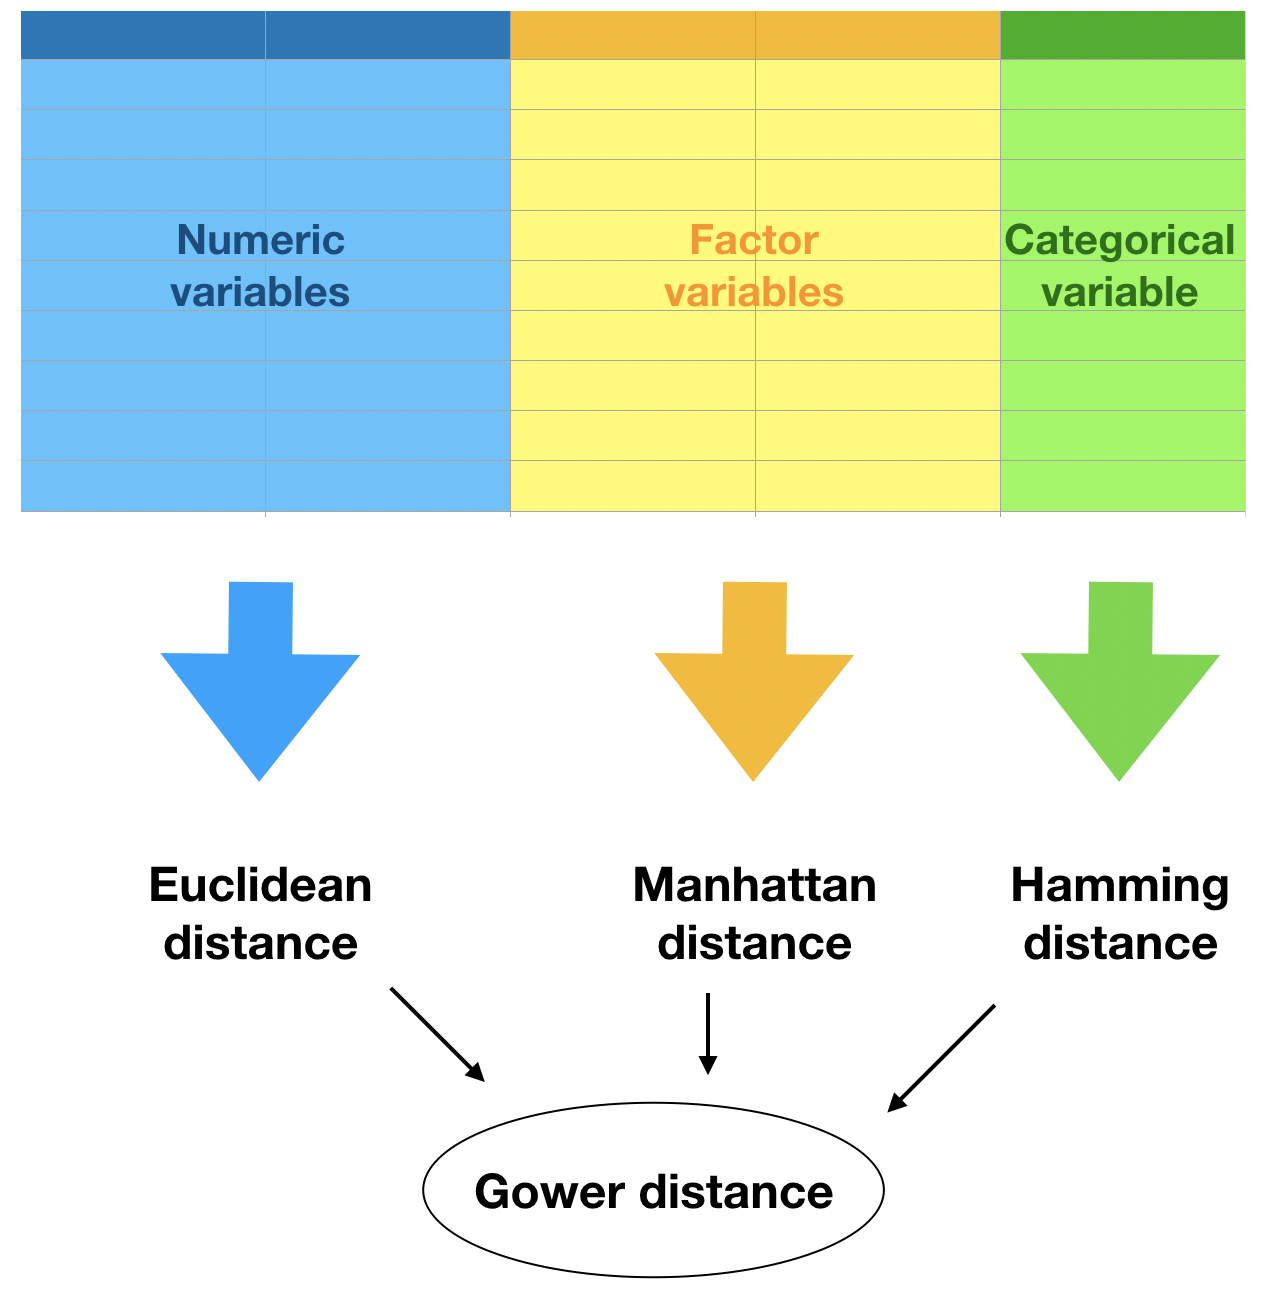
Um data frame simulado contendo três tipos de variáveis, cada um destacado com uma cor: numéricas, fator e categóricas. Cada tipo de variável tem uma seta apontando para a medida de distância correspondente: Euclidiana, Manhattan e Hamming. As três medidas apontam para uma elipse com a distância de Gower, que combina as três.

Tratamento de Dados Ausentes com Imputações em R

Imputação kNN na prática

library(VIM)
nhanes_imp <- kNN(nhanes, k = 5, variable = c("TotChol", "Pulse"))
head(nhanes_imp)
  Age Gender Weight Height Diabetes TotChol Pulse PhysActive TotChol_imp Pulse_imp
1  16   male   73.2  172.0    FALSE    3.00    76       TRUE       FALSE     FALSE
2  17   male   72.3  176.0    FALSE    2.61    74       TRUE       FALSE     FALSE
3  12   male   57.7  158.9    FALSE    4.27    80       TRUE       FALSE     FALSE
4  16   male   88.9  183.3    FALSE    3.62    58       TRUE       FALSE     FALSE
5  13 female   45.1  157.6    FALSE    2.66    92       TRUE       FALSE     FALSE
6  16 female   48.7  158.4    FALSE    4.32    58      FALSE       FALSE     FALSE
Tratamento de Dados Ausentes com Imputações em R

Ponderando doadores

  • Entre os k vizinhos escolhidos para uma observação, alguns são mais semelhantes que outros.
  • Vale dar mais peso aos vizinhos mais próximos ao agregar seus valores.
  • Agregue vizinhos com média ponderada, com pesos dados pelas distâncias invertidas a cada vizinho.
  • Isso só é possível para imputar variáveis numéricas.
nhanes_imp <- nhanes %>% 
  kNN(variable = c("TotChol", "Pulse"),
      k = 5,
      numFun = weighted.mean,
      weightDist = TRUE)
Tratamento de Dados Ausentes com Imputações em R

Ordenando variáveis

  • O algoritmo kNN percorre as variáveis, imputando uma a uma.
  • A cada vez, calcula-se a distância entre observações.
  • Se a primeira variável tiver muitos valores ausentes, o cálculo da distância para a segunda usará muitos valores imputados.
  • É bom ordenar as variáveis em ordem crescente pelo número de ausentes antes de rodar o kNN.
Tratamento de Dados Ausentes com Imputações em R

Ordenando variáveis na prática

vars_by_NAs <- nhanes %>% 
  is.na() %>%
  colSums() %>%
  sort(decreasing = FALSE) %>% 
  names()
nhanes_imp <- nhanes %>% 
  select(vars_by_NAs) %>% 
  kNN(k = 5)
Tratamento de Dados Ausentes com Imputações em R

Vamos praticar imputação com kNN!

Tratamento de Dados Ausentes com Imputações em R

Preparing Video For Download...