Modelos de clusterização com privacidade diferencial

Privacidade de Dados e Anonimização em Python

Rebeca Gonzalez

Data engineer

Comparando modelos
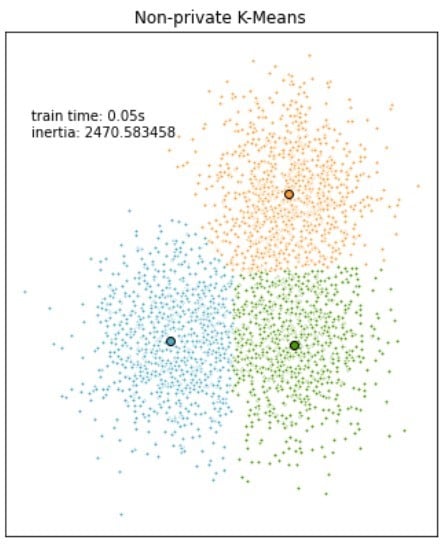
Imagem mostrando 3 clusters nos dados após k-means sem privacidade

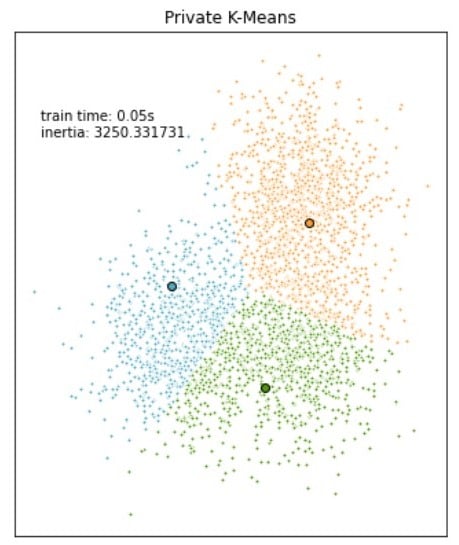
Imagem mostrando 3 clusters nos dados após k-means com privacidade

Privacidade de Dados e Anonimização em Python

Comparando os modelos

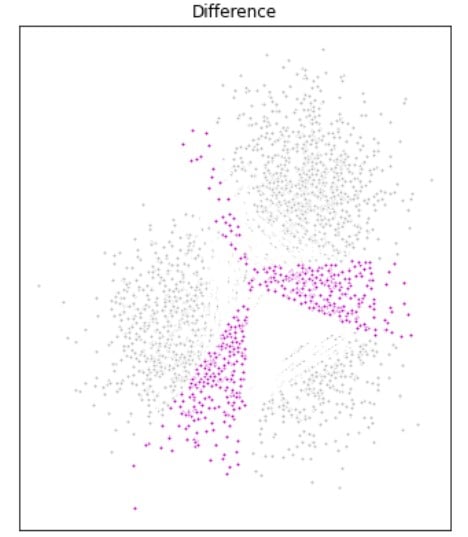
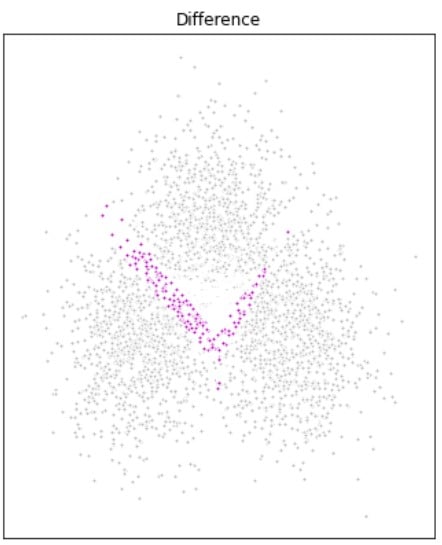
Imagem mostrando a diferença entre os dois resultados de clusterização como pontos rosas

  • Diferença entre os clusters resultantes dos modelos
  • A maioria dos resultados é comum
Privacidade de Dados e Anonimização em Python

Construindo modelos de clusterização com privacidade diferencial

from diffprivlib.models import KMeans

# Calculando os clusters com o modelo DP model = KMeans(epsilon=1, n_clusters=3)
# Executar o modelo e obter os clusters clusters = model.fit_predict(X)
Privacidade de Dados e Anonimização em Python

Aprimorando modelos DP de clusterização
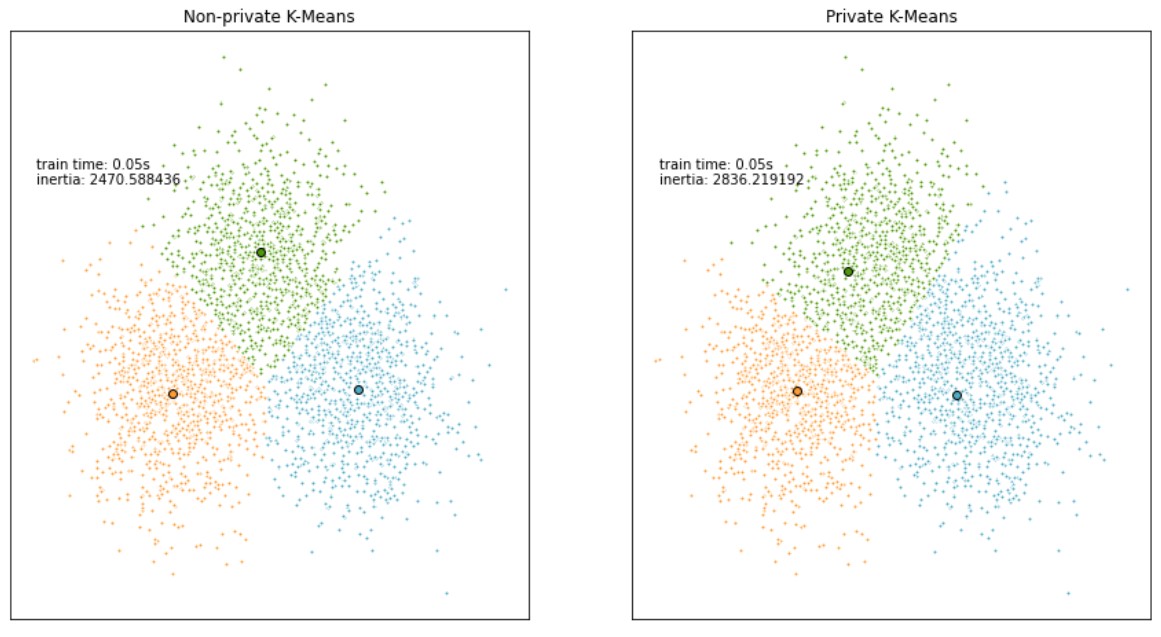
  • Podemos pré-processar os dados antes da clusterização.
  • Escalonamento de features como StandardScaler e redução de dimensionalidade como PCA.
    • Para reduzir a inércia do modelo
    • Obter grupos de segmentação mais precisos
  • Com diffprivlib, fazemos isso como em modelos do sklearn.
Privacidade de Dados e Anonimização em Python

Aprimorando modelos DP de clusterização
from sklearn.decomposition import PCA

# Inicializar PCA pca = PCA()
# Ajustar e transformar os dados com PCA X = pca.fit_transform(X)
# Calculando os clusters com o modelo DP model = dp_Kmeans(epsilon=1, n_clusters=3)
# Executar o modelo e obter os clusters clusters = model.fit_predict(X)
Privacidade de Dados e Anonimização em Python

Aprimorando modelos DP de clusterização

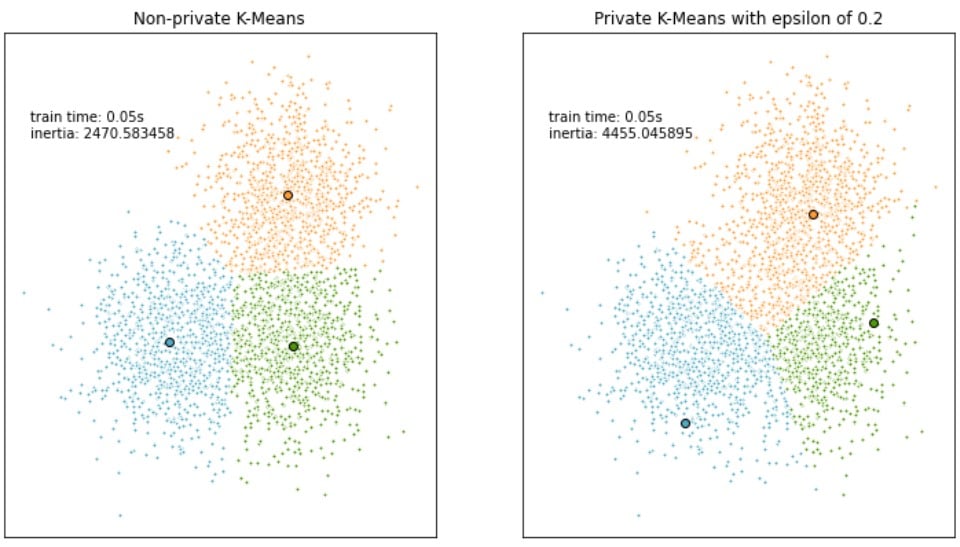
Imagem mostrando dois dispersogramas resultantes com os clusters

Privacidade de Dados e Anonimização em Python

Aprimorando modelos DP de clusterização

Imagem mostrando a diferença entre os dois resultados de clusterização como pontos rosas

  • Resultados melhores usando transformações nos dados
Privacidade de Dados e Anonimização em Python

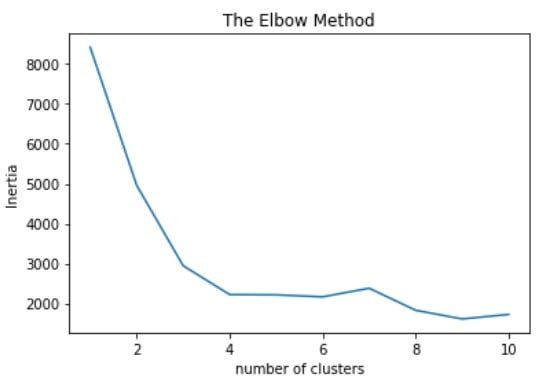
Método do cotovelo

Imagem do gráfico resultante após aplicar o método do cotovelo nos dados

Privacidade de Dados e Anonimização em Python

Épsilon

from diffprivlib.models import KMeans as model

# Calculando os clusters com o modelo DP model = dp_Kmeans(epsilon=0.2, n_clusters=3)
# Executar o modelo e obter os clusters clusters = model.fit_predict(X)
Privacidade de Dados e Anonimização em Python

Épsilon

Imagem mostrando dois dispersogramas resultantes com os clusters

Privacidade de Dados e Anonimização em Python

Vamos praticar!

Privacidade de Dados e Anonimização em Python

Preparing Video For Download...