Introdução à k-anonymity

Privacidade de Dados e Anonimização em Python

Rebeca Gonzalez

Data engineer

Por que k-anonymity é importante?
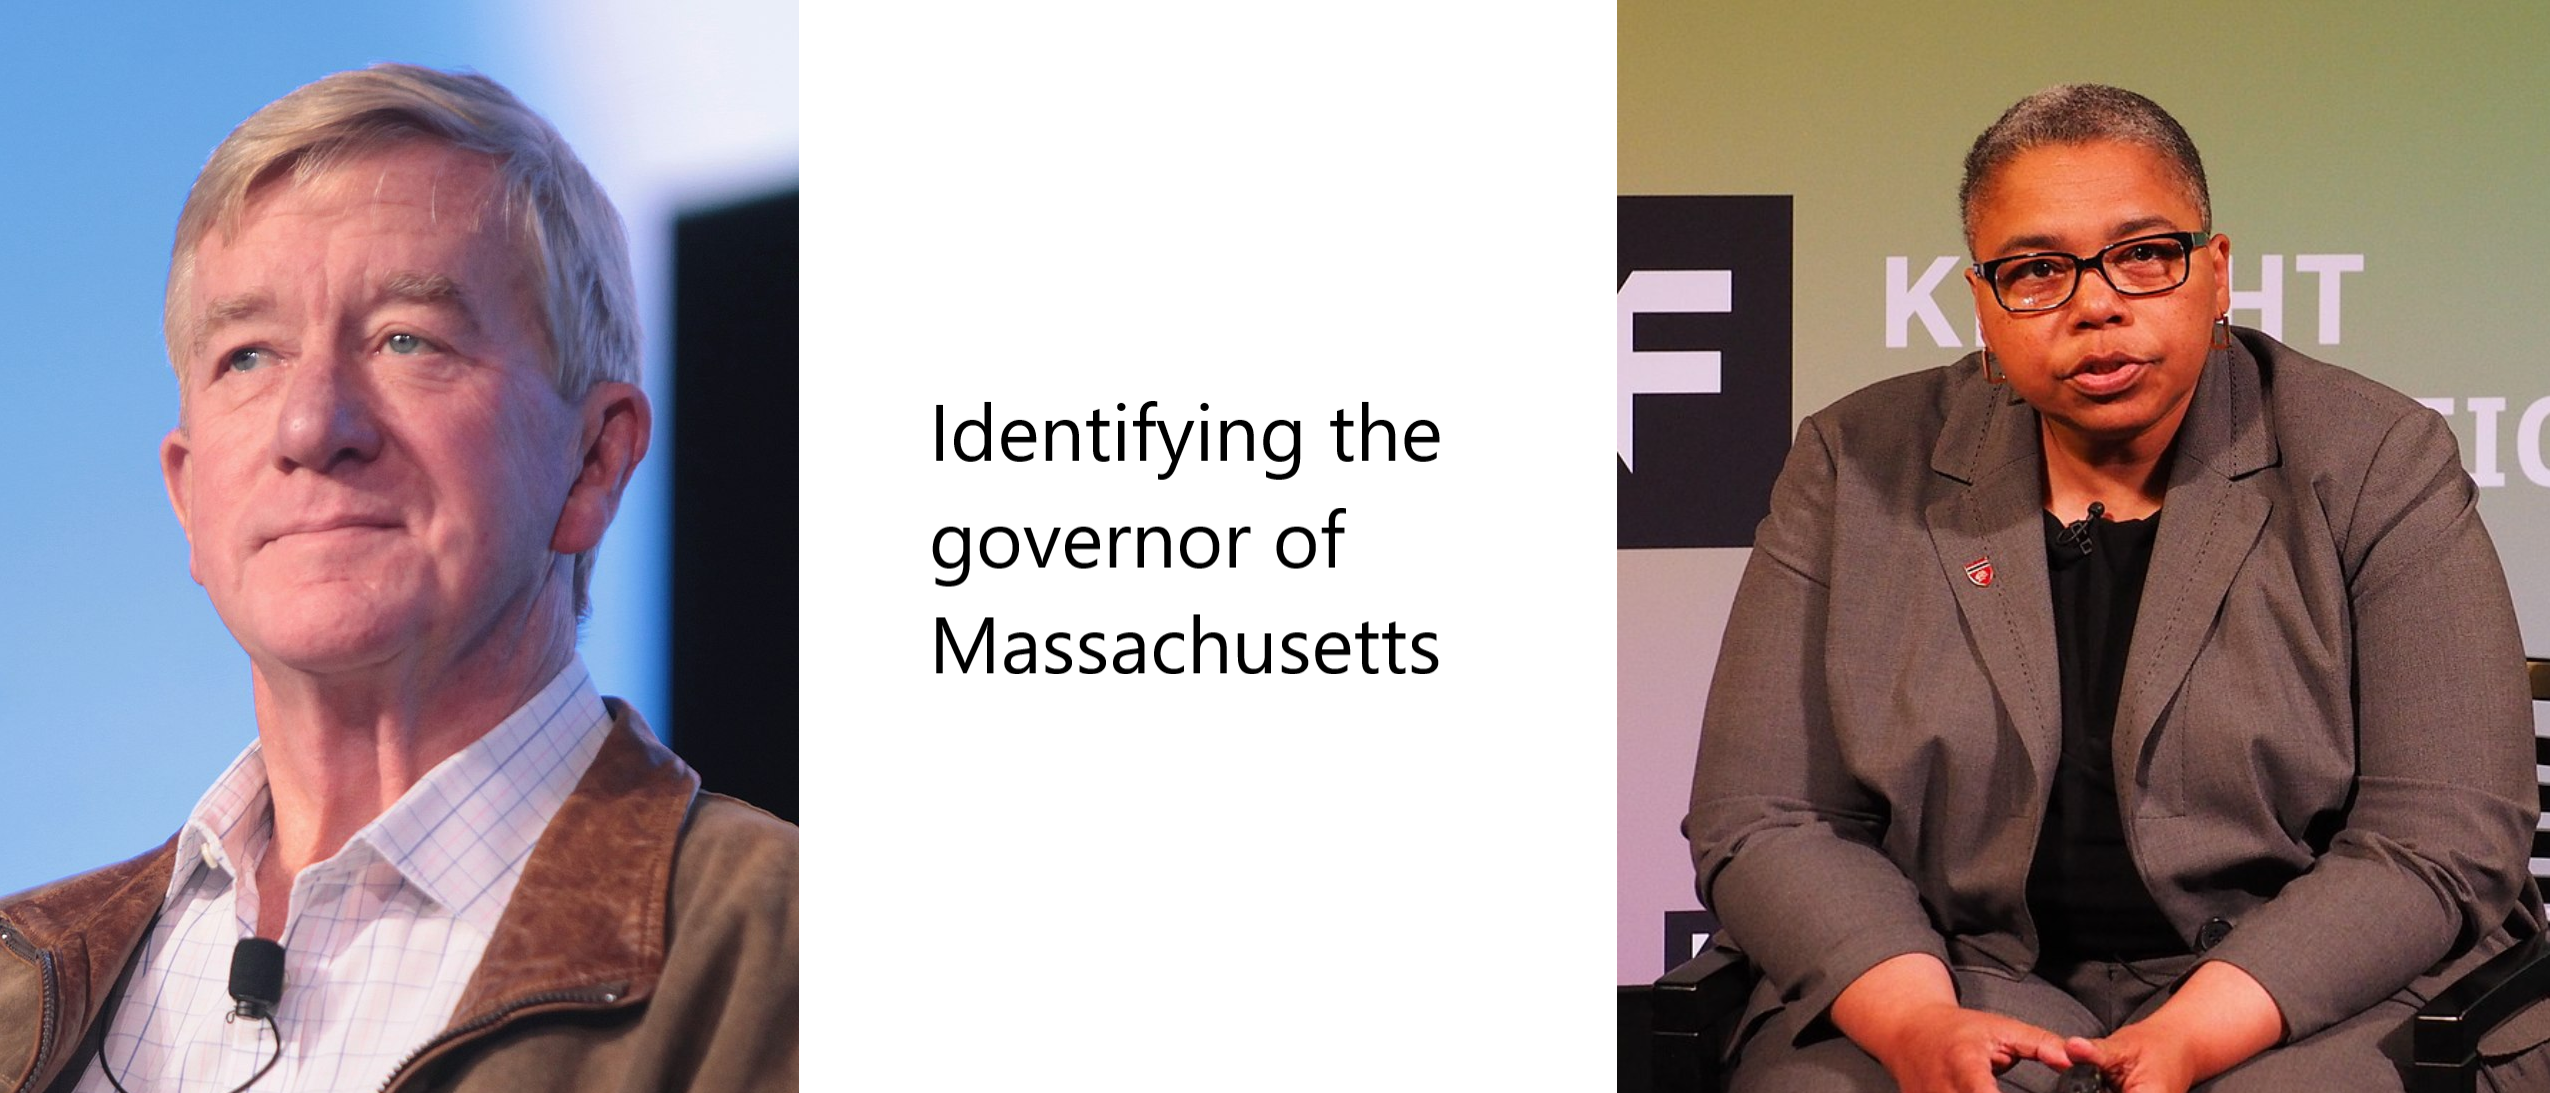
Imagem mostrando o governador de Massachusetts à esquerda, o texto "Identifying the governor of Massachusetts" e a professora de Harvard Latanya Sweeney à direita

Privacidade de Dados e Anonimização em Python

Por que isso é importante?

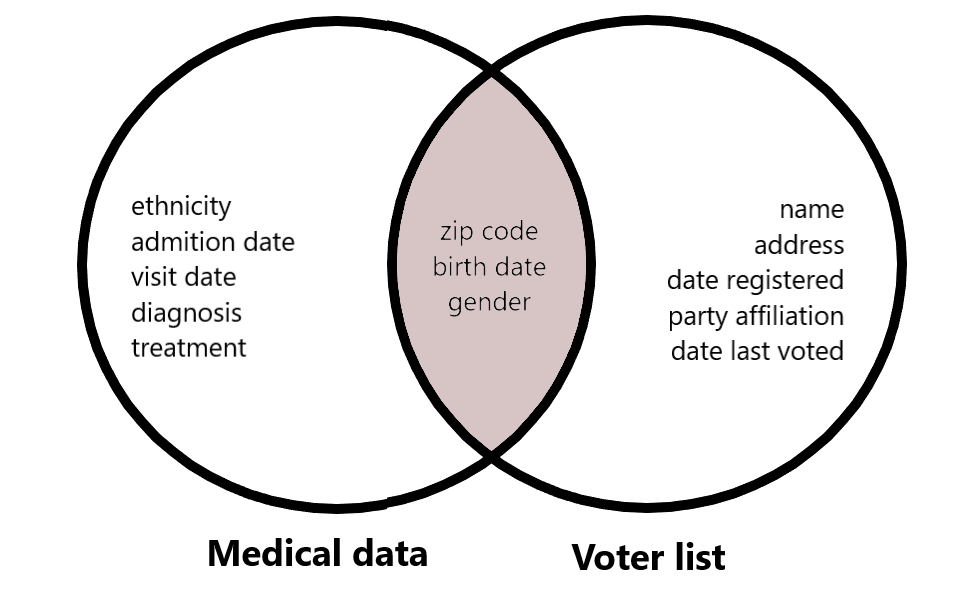
  • Seis pessoas tinham sua data de nascimento
  • Só três eram homens
  • Ele era o único no seu CEP

Diagrama mostrando a interseção de dois conjuntos de dados: dados médicos e lista de eleitores, cuja interseção é CEP, data de nascimento e gênero

Privacidade de Dados e Anonimização em Python

Como evitar esse ataque?

Apenas um registro tinha os valores demográficos do governador.

Excluir todas as informações demográficas deixaria os dados inúteis para análise.

E se houver um meio-termo para garantir que os valores demográficos não sejam mais únicos no conjunto de dados?

Privacidade de Dados e Anonimização em Python

Definição de k-anonymity

$$ $$ $$ $$ $$ $$ Pelo menos k pessoas no conjunto de dados compartilham o conjunto de atributos que pode identificar cada indivíduo.

Privacidade de Dados e Anonimização em Python

Definição de k-anonymity

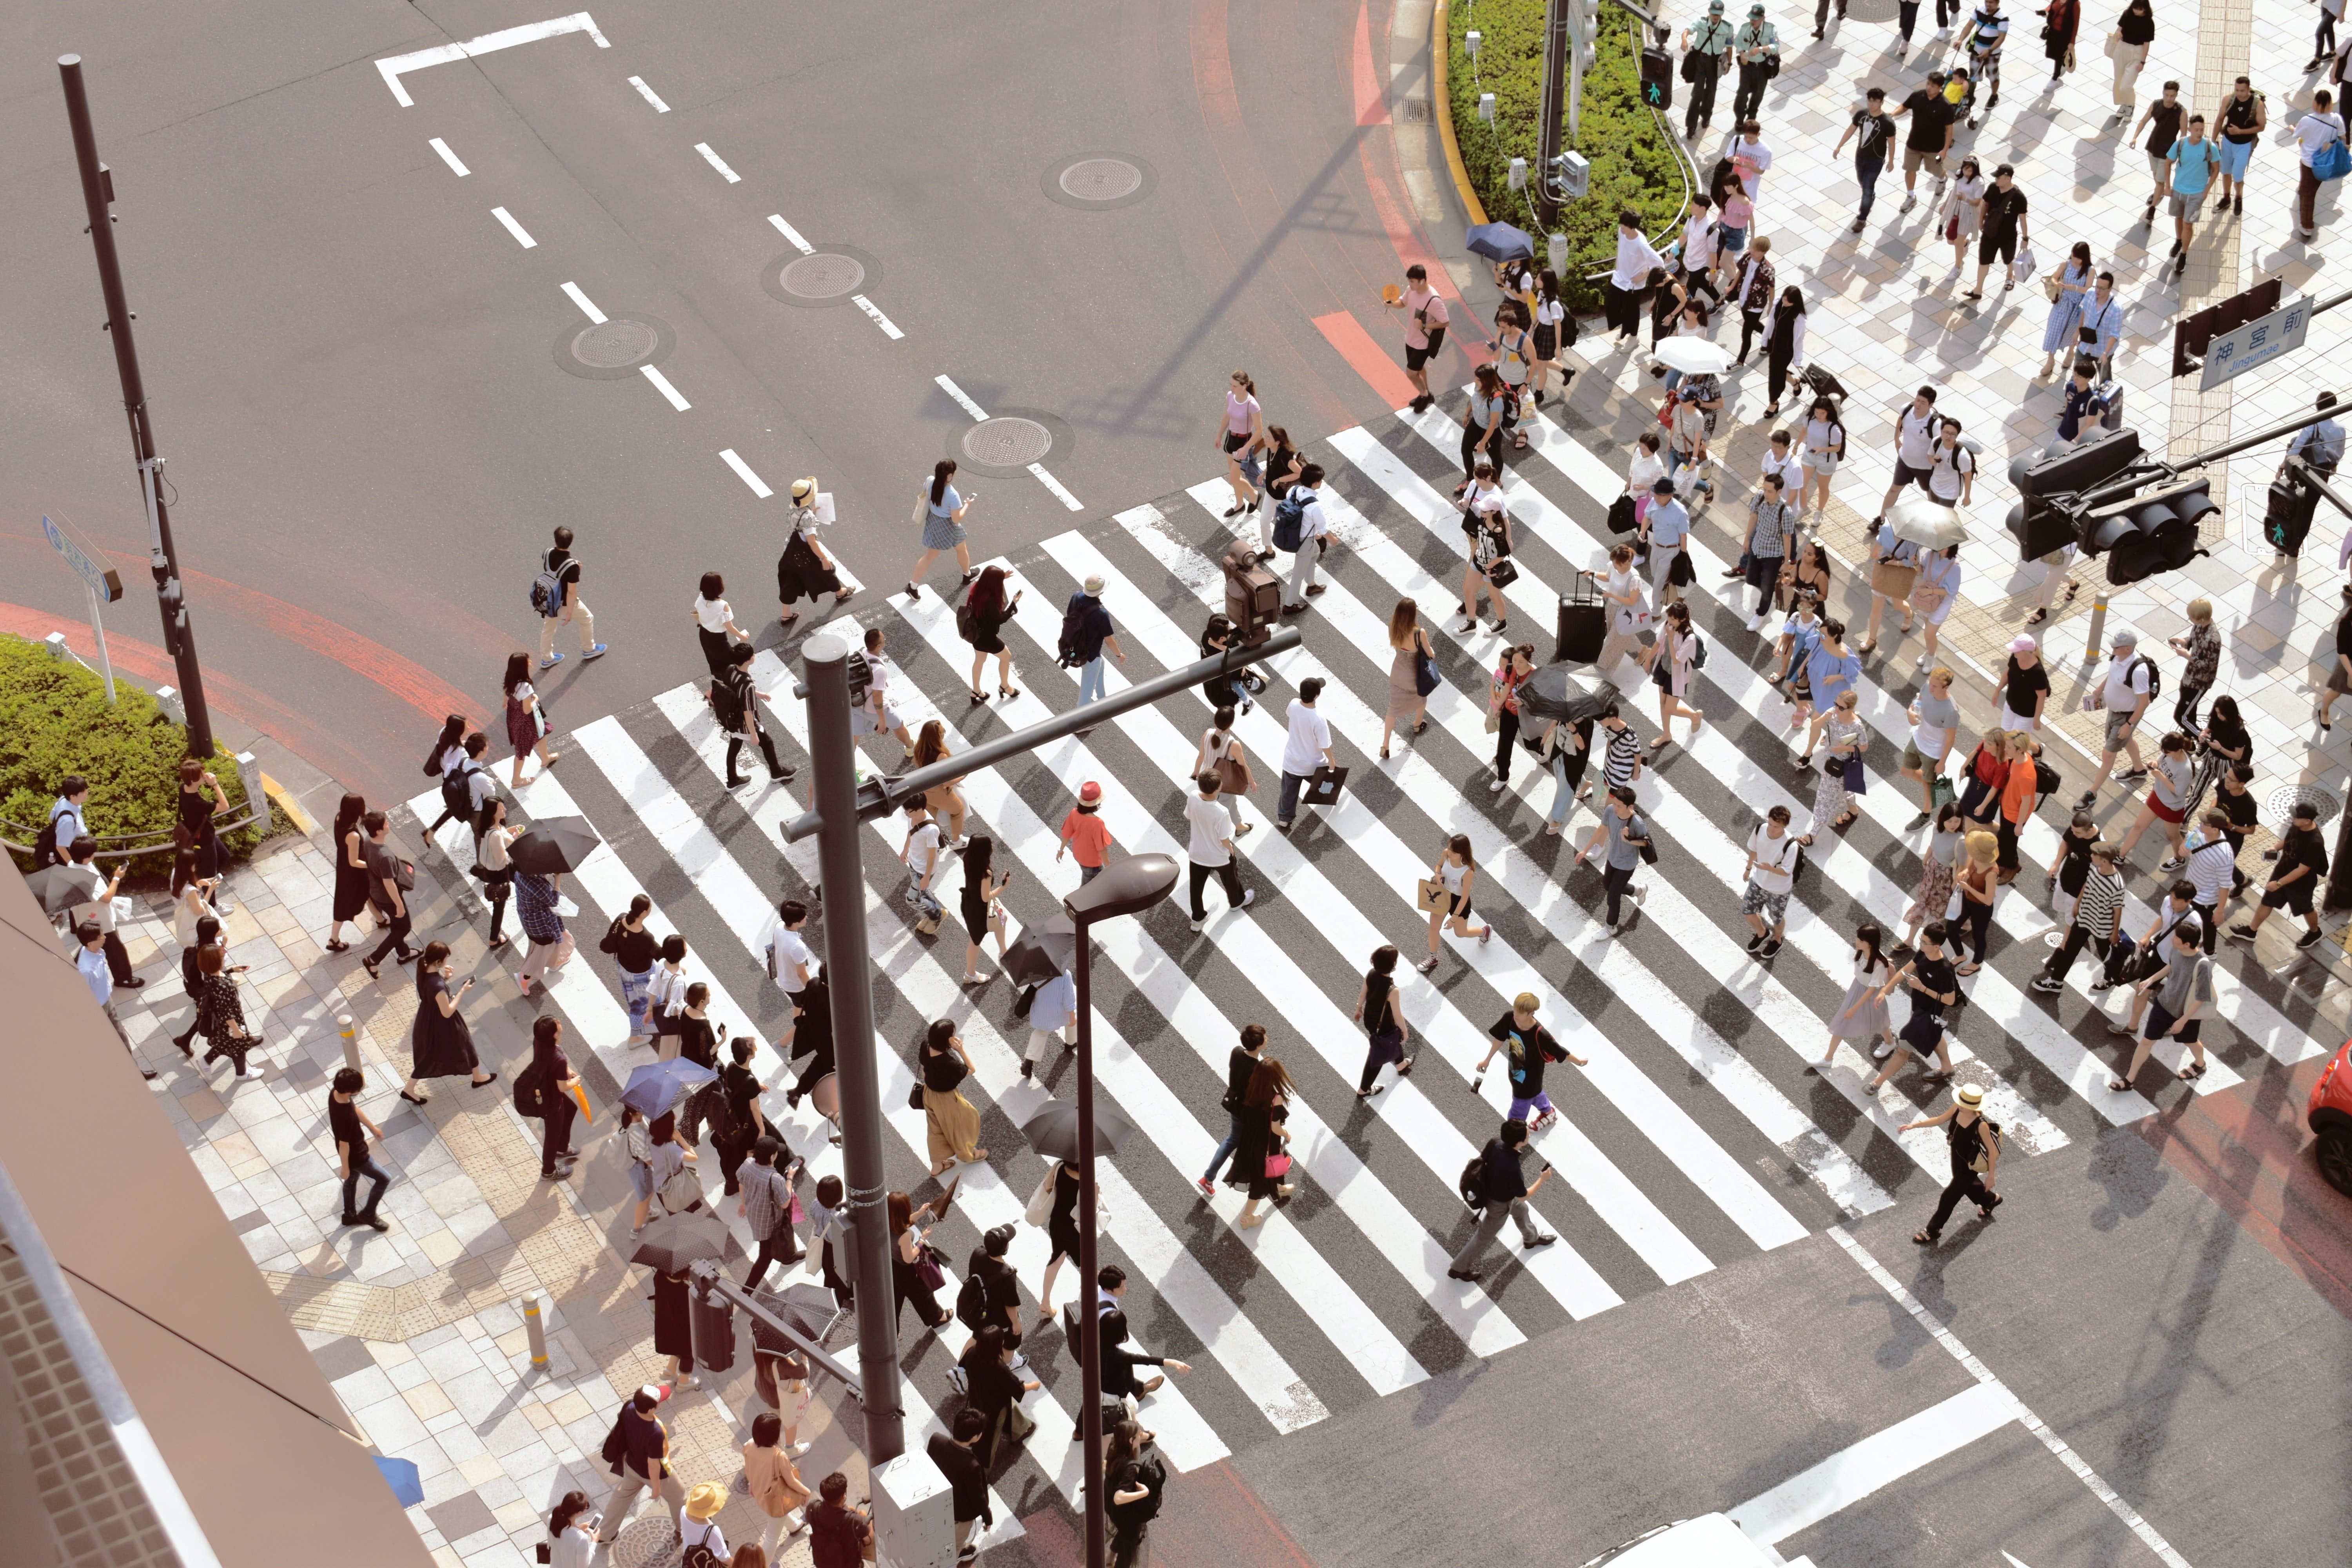
Um grande grupo de pessoas atravessando uma rua

Privacidade de Dados e Anonimização em Python

Conjunto de dados k-anonymous

2-anonymous:

     ZIP code    Age
0    4217        34
1    4217        34
2    1742        77
3    1742        77

Cada combinação de valores nas colunas identificadoras aparece em pelo menos k registros diferentes.

Not 2-anonymous:

     ZIP code    Age
0    4217        34
1    4217        34
2    1742        77
3    1743        77
Privacidade de Dados e Anonimização em Python

K-anonymity: Terminologia

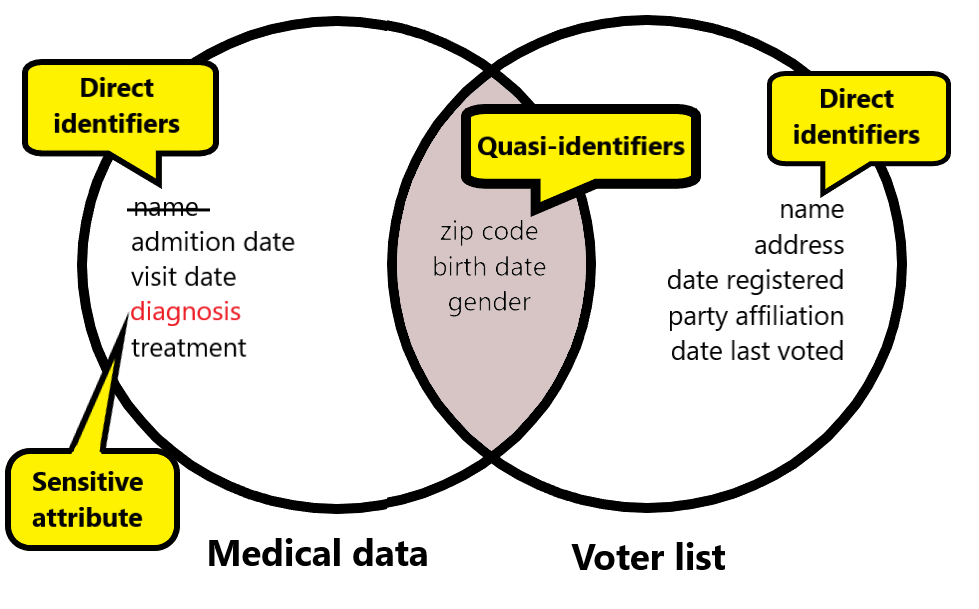
Diagrama mostrando os termos identificadores diretos, quase-identificadores e atributos sensíveis

Privacidade de Dados e Anonimização em Python

Conjunto de dados médicos

# Explore DataFrame 
medical_df.head()
    Age    Department   Condition
0    34    Marketing    Anxiety disorders
1    46    Finance      Flu
2    41    Finance      Flu
3    62    Marketing    Anxiety disorders
4    44    Marketing    Anxiety disorders
Privacidade de Dados e Anonimização em Python

Atributos de privacidade

Atributos de privacidade:

  • Identificadores: Podem ser SSN e números de ID.
  • Quase-identificadores: Age e Department do nosso conjunto de dados
  • Sensíveis: Condition médica do nosso conjunto de dados
Privacidade de Dados e Anonimização em Python

Explorando combinações únicas de quase-identificadores

# Calculate how many unique combinations are for Age and Department
medical_df.groupby(['Age','Department']).size().reset_index(name='Count')
    Age    Department    Count
0    30    Production    2
1    31    Marketing     1
2    32    Marketing     1
3    32    Production    1
4    33    Production    1
5    34    Finance       1
6    34    Marketing     1
7    34    Production    1
8    35    Marketing     1
9    36    Finance       2
10    38    Finance      1
11    38    Production   1
Privacidade de Dados e Anonimização em Python

Abordagem: generalização

# Generalize Age by creating 4 groups of intervals
medical_df['Age_group'] = pd.cut(medical_df['Age'], bins=4)


# Explore the dataset with intervals medical_df.head()
    Age    Department    Condition            Age_group
0    34    Marketing     Anxiety disorders    (29.964, 39.0]
1    46    Finance       Flu                  (39.0, 48.0]
2    41    Finance       Flu                  (39.0, 48.0]
3    62    Marketing     Anxiety disorders    (57.0, 66.0]
4    44    Marketing     Anxiety disorders    (39.0, 48.0]
Privacidade de Dados e Anonimização em Python

Abordagem: generalização

# Calculate how many unique combinations are for Age and Department
medical_df.groupby(['Age_group','Department']).size().reset_index(name='Count')
     Age_group         Department    Count
0    (29.964, 39.0]    Finance       4
1    (29.964, 39.0]    Marketing     4
2    (29.964, 39.0]    Production    6
3    (39.0, 48.0]      Finance       8
4    (39.0, 48.0]      Marketing     5
5    (39.0, 48.0]      Production    4
6    (48.0, 57.0]      Finance       3
7    (48.0, 57.0]      Marketing     2
8    (48.0, 57.0]      Production    4
Privacidade de Dados e Anonimização em Python

Abordagem: generalização

# Set k to be 2, for a 2-anonymous dataset
k = 2


# Calculate how many unique combinations are for Age and Department df_count = medical_df.groupby(['Age_group','Department']).size().reset_index(name='Count')
# Filter the rows that have count less than k df_count[df_count['Count'] < k]
    Age_group    Department    Count
Privacidade de Dados e Anonimização em Python

Vamos praticar!

Privacidade de Dados e Anonimização em Python

Preparing Video For Download...