Introdução e motivação
Detecção de Fraudes em R

Bart Baesens
Professor Data Science at KU Leuven
Instrutores
Instrutores
Instrutores
O que é fraude?
Fraude é um crime incomum, bem planejado, imperceptivelmente oculto, que evolui no tempo e muitas vezes é cuidadosamente organizado, aparecendo em muitos tipos e formas.
Características-chave de modelos bem-sucedidos de analytics de fraude
Características-chave de modelos bem-sucedidos de analytics de fraude
Características-chave de modelos bem-sucedidos de analytics de fraude
Características-chave de modelos bem-sucedidos de analytics de fraude
Características-chave de modelos bem-sucedidos de analytics de fraude
Desafios do modelo de detecção de fraude
Desafios do modelo de detecção de fraude
Desafios do modelo de detecção de fraude
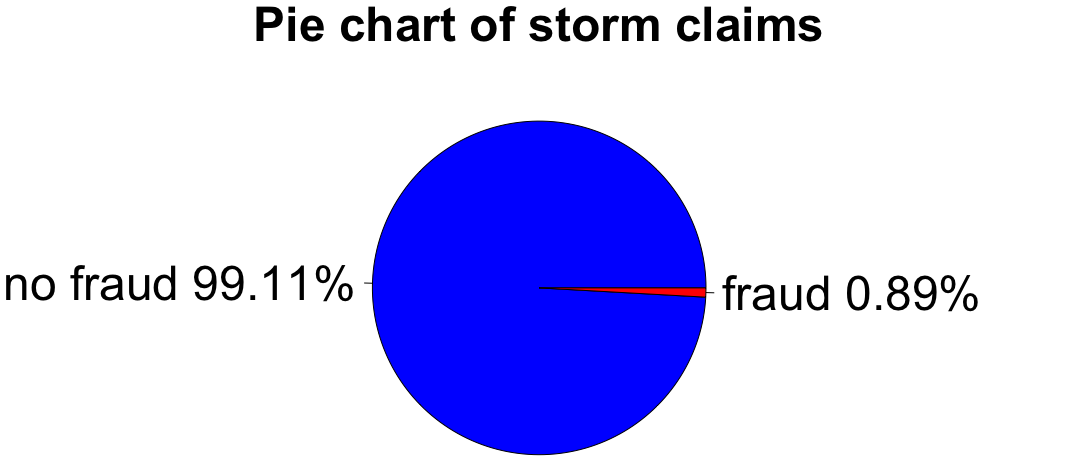
Visualizar desbalanceamento com gráfico de pizza
labels <- c("no fraud", "fraud")
labels <- paste(labels, round(100 * prop.table(table(fraud_label)), 2), "%")
pie(table(fraud_label), labels, col = c("blue", "red"),
      main = "Pie chart of storm claims")
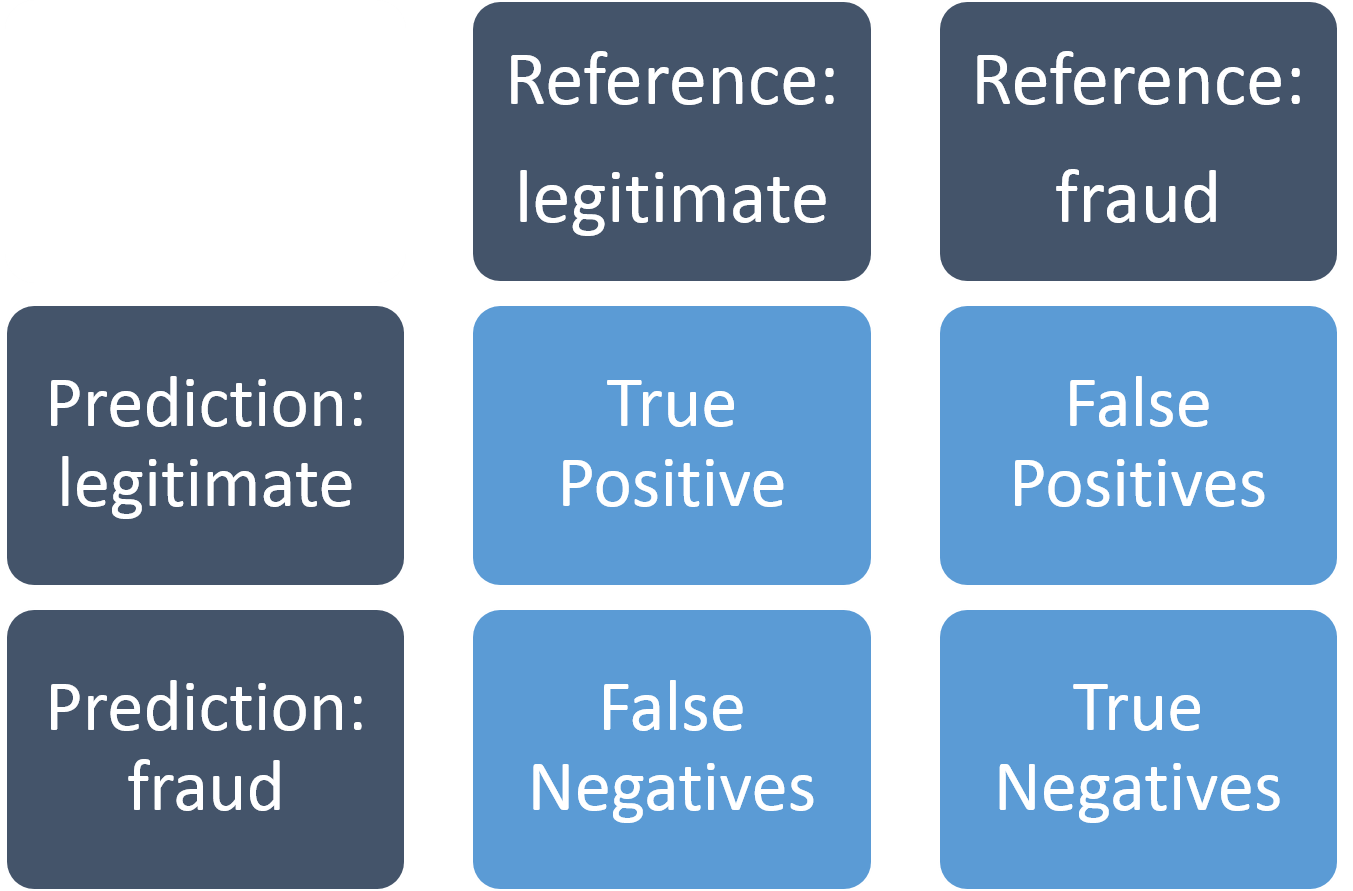
Matriz de confusão
Usado para avaliar o modelo de detecção de fraude: