Detecção de Fraudes em R
Bart Baesens
Professor Data Science at KU Leuven
De preferência, mais de 1000 números que cubram múltiplas ordens.
Note que é sempre possível que os dados simplesmente não sigam a Lei de Benford.
Um conjunto de dados segue a Lei de Benford para os dois primeiros dígitos se a probabilidade de os dois primeiros dígitos $D_1D_2$ serem $d_1d_2$ for aproximadamente:
$$P(D_1D_2=d_1d_2)=\log\left(1+\frac{1}{d_1d_2}\right) \qquad d_1d_2\in [10, 11, ..., 98, 99]$$
benlaw <- function(d) log10(1 + 1 / d)
benlaw(12)
0.03476211
Esse teste é mais confiável que o dos primeiros dígitos e é o mais usado em detecção de fraudes.
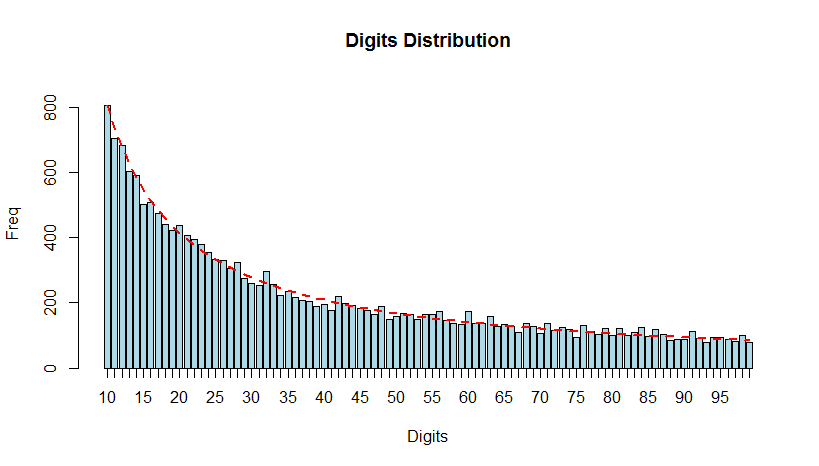
bfd.cen <- benford(census.2009$pop.2009, number.of.digits = 2)
plot(bfd.cen)
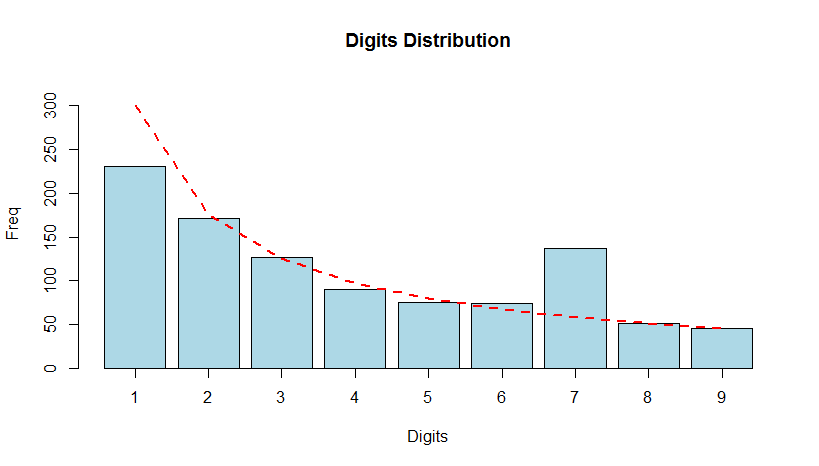
expenses contém 1000 reembolsos.benford.analysis.bfd1.exp <- benford(expenses, number.of.digits = 1)
plot(bfd1.exp)
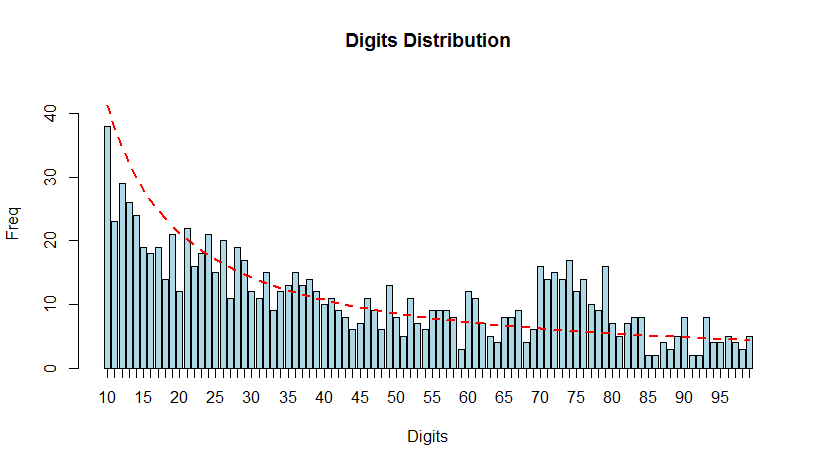
bfd2.exp <- benford(expenses, number.of.digits = 2)
plot(bfd2.exp)
Detecção de Fraudes em R