Lidando com conjuntos de dados desbalanceados

Detecção de Fraudes em R

Bart Baesens

Professor Data Science at KU Leuven

Conjuntos de dados desbalanceados
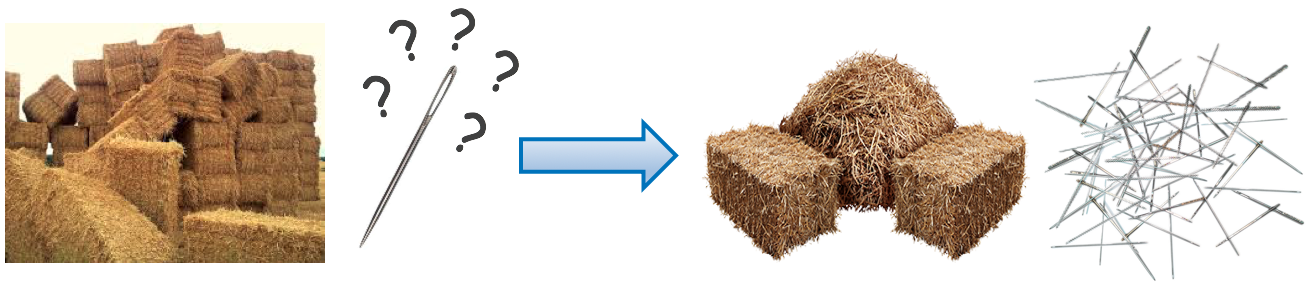
  • Desafio central: rotular eventos como fraude ou não
    • Grande desafio para métodos de classificação e técnicas de detecção de anomalias
  • Classificador tende a favorecer a classe majoritária (= sem fraude)
    • alto erro de classificação nos casos de fraude
  • Classificadores aprendem melhor com distribuição balanceada

palheiro_e_agulha_v2

Detecção de Fraudes em R

Conjuntos de dados desbalanceados

  • Desafio central: rotular eventos como fraude ou não
    • Grande desafio para métodos de classificação e técnicas de detecção de anomalias
  • Classificador tende a favorecer a classe majoritária (= sem fraude)
    • alto erro de classificação nos casos de fraude
  • Classificadores aprendem melhor com distribuição balanceada
  • Solução possível: mudar a distribuição das classes com amostragem

palheiro_e_agulha_v1

Detecção de Fraudes em R

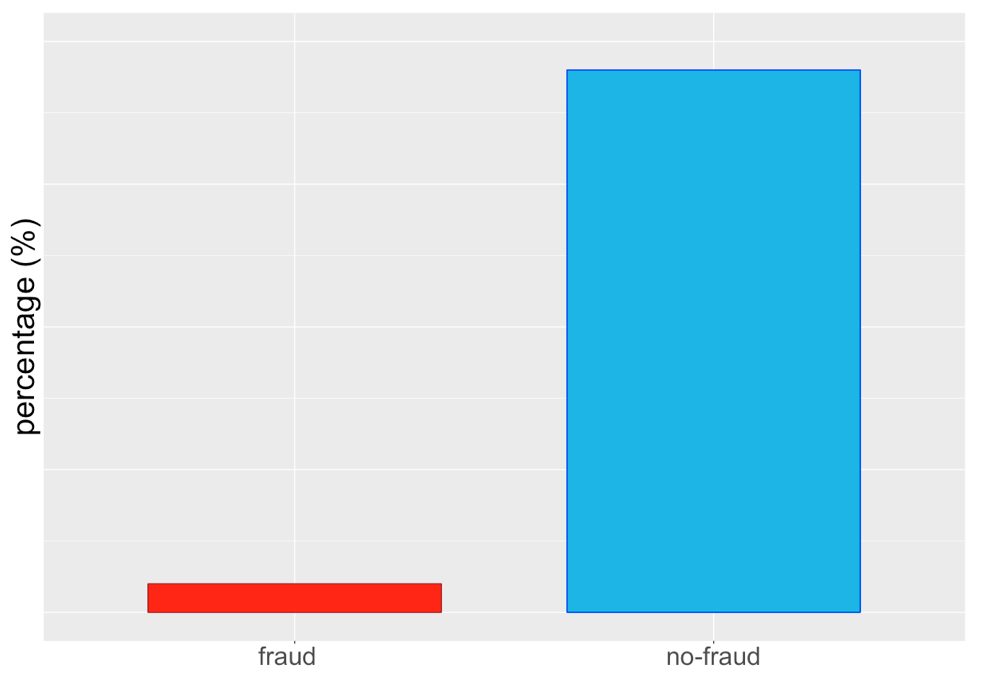
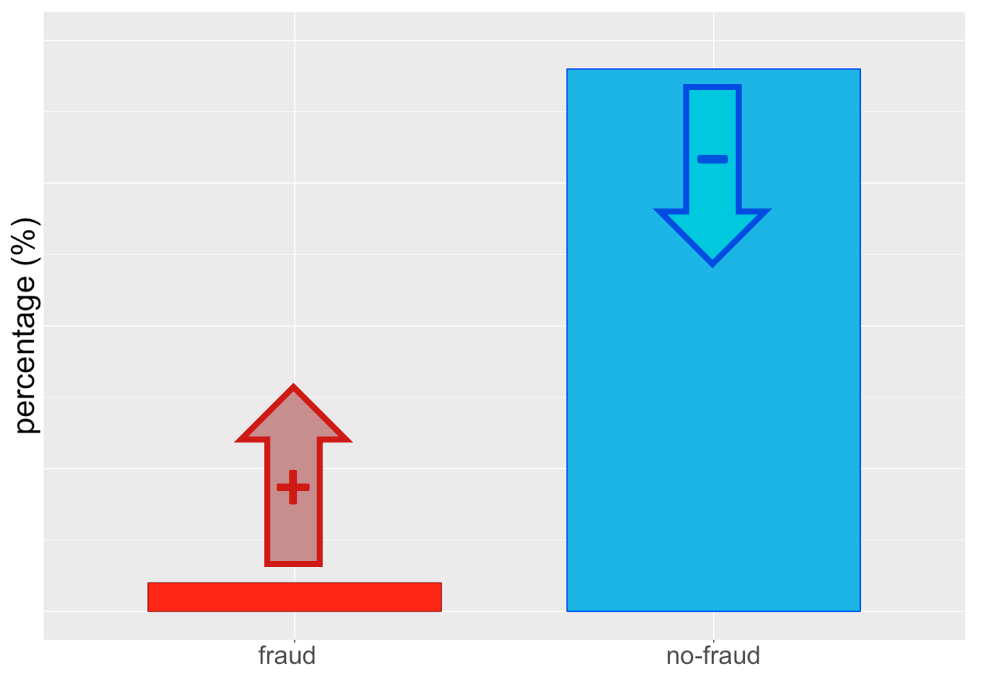
Desbalanceamento original

class_barplot_orig.png

Detecção de Fraudes em R

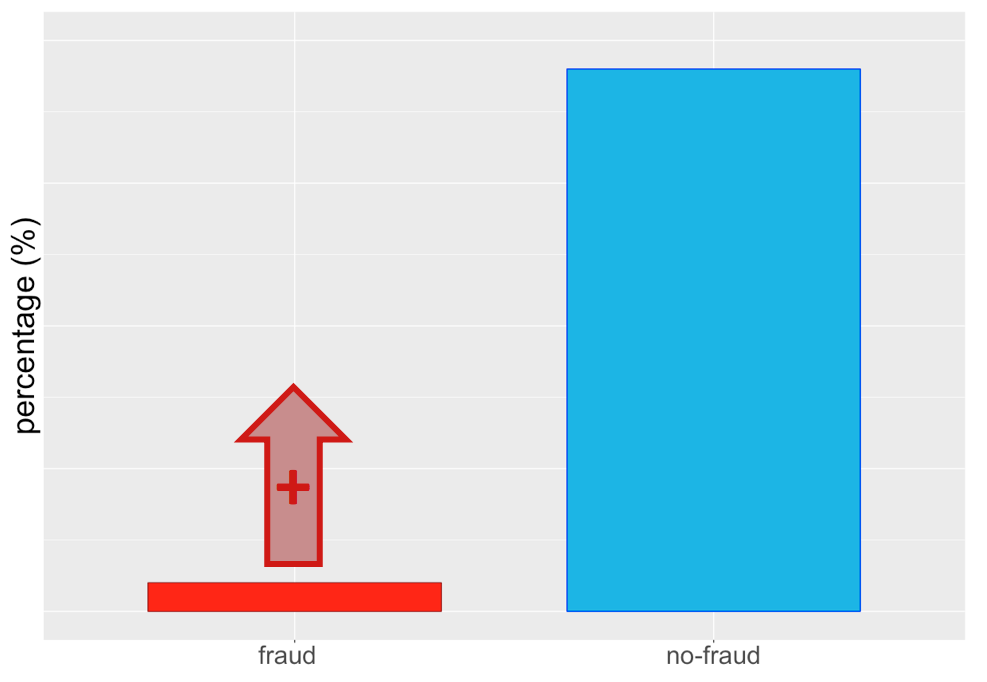
Over-sampling da minoria...

class_barplot_over

Detecção de Fraudes em R

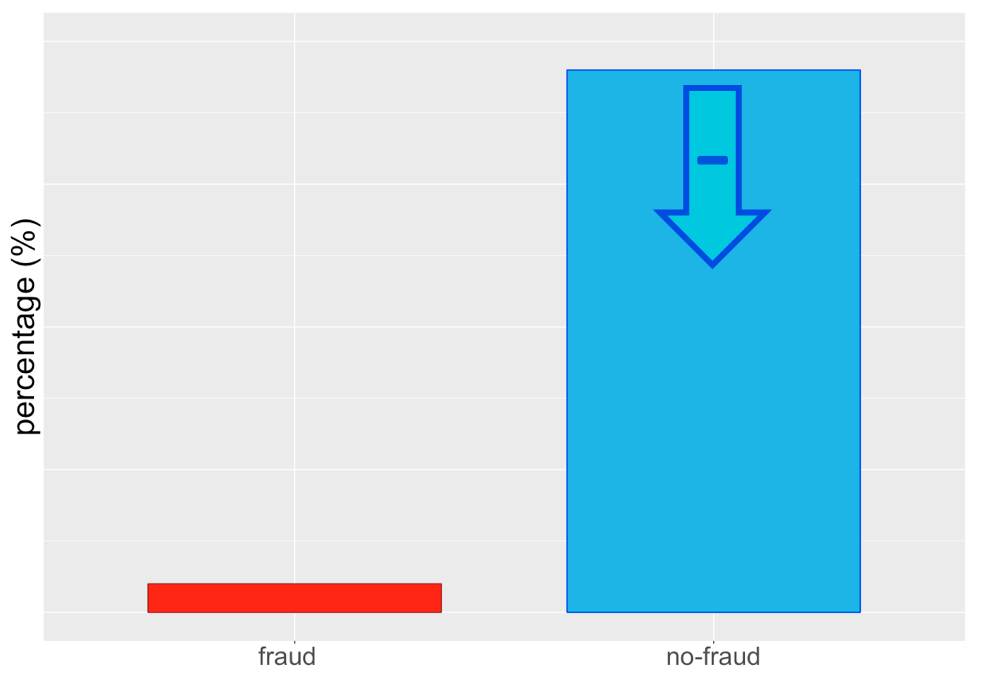
... ou under-sampling da maioria...

class_barplot_under

Detecção de Fraudes em R

... ou ambos!

class_barplot_both

Detecção de Fraudes em R

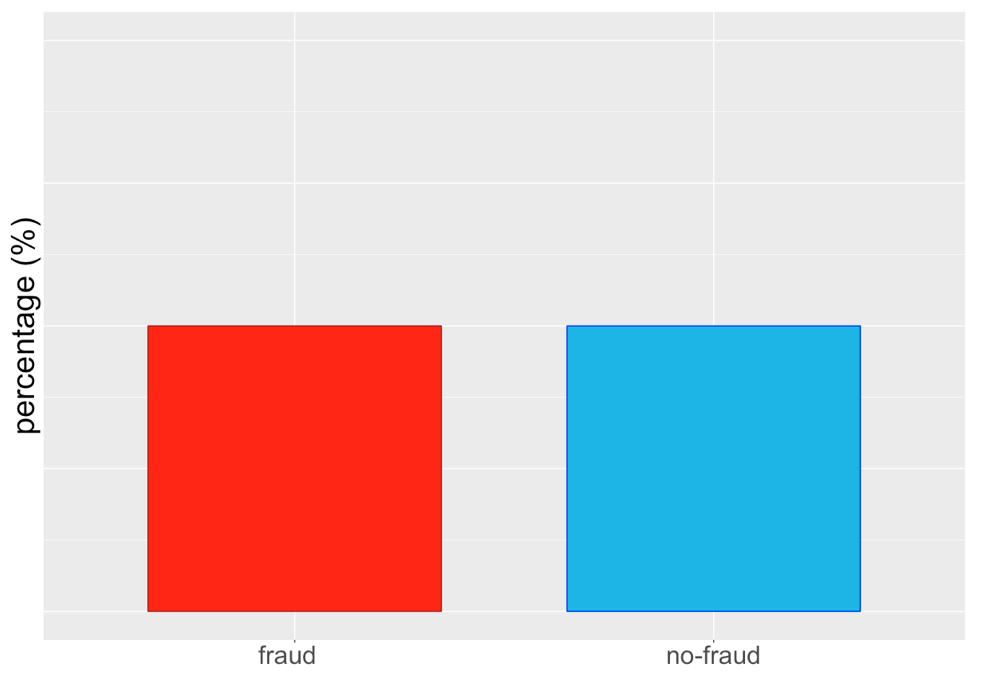
Resultado após amostragem...

class_barplot_result2

Detecção de Fraudes em R

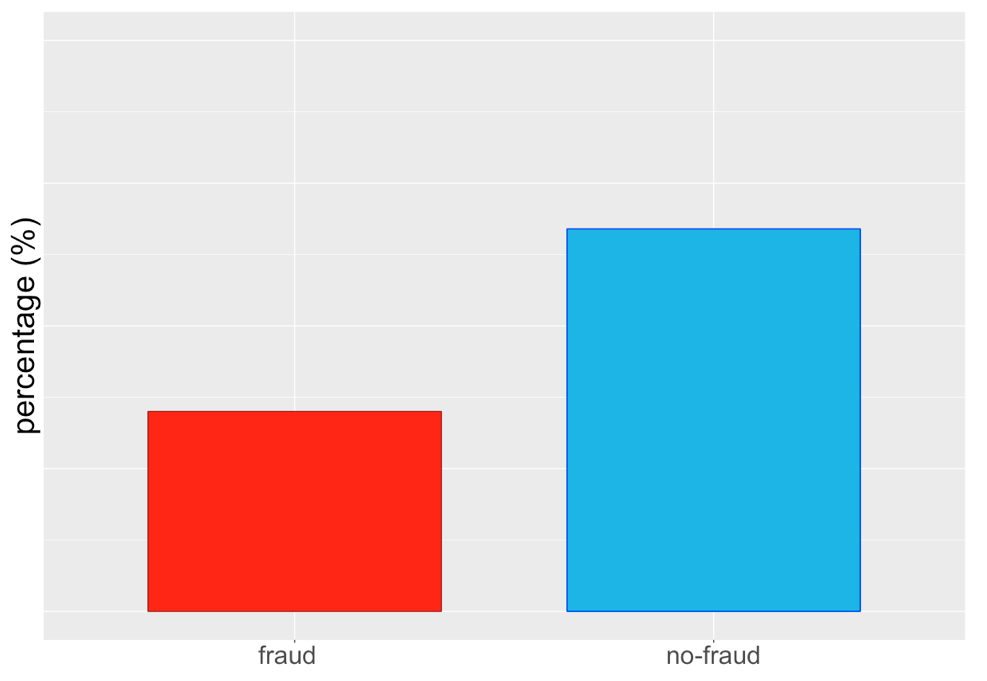
... ou assim

class_barplot_result1

Detecção de Fraudes em R

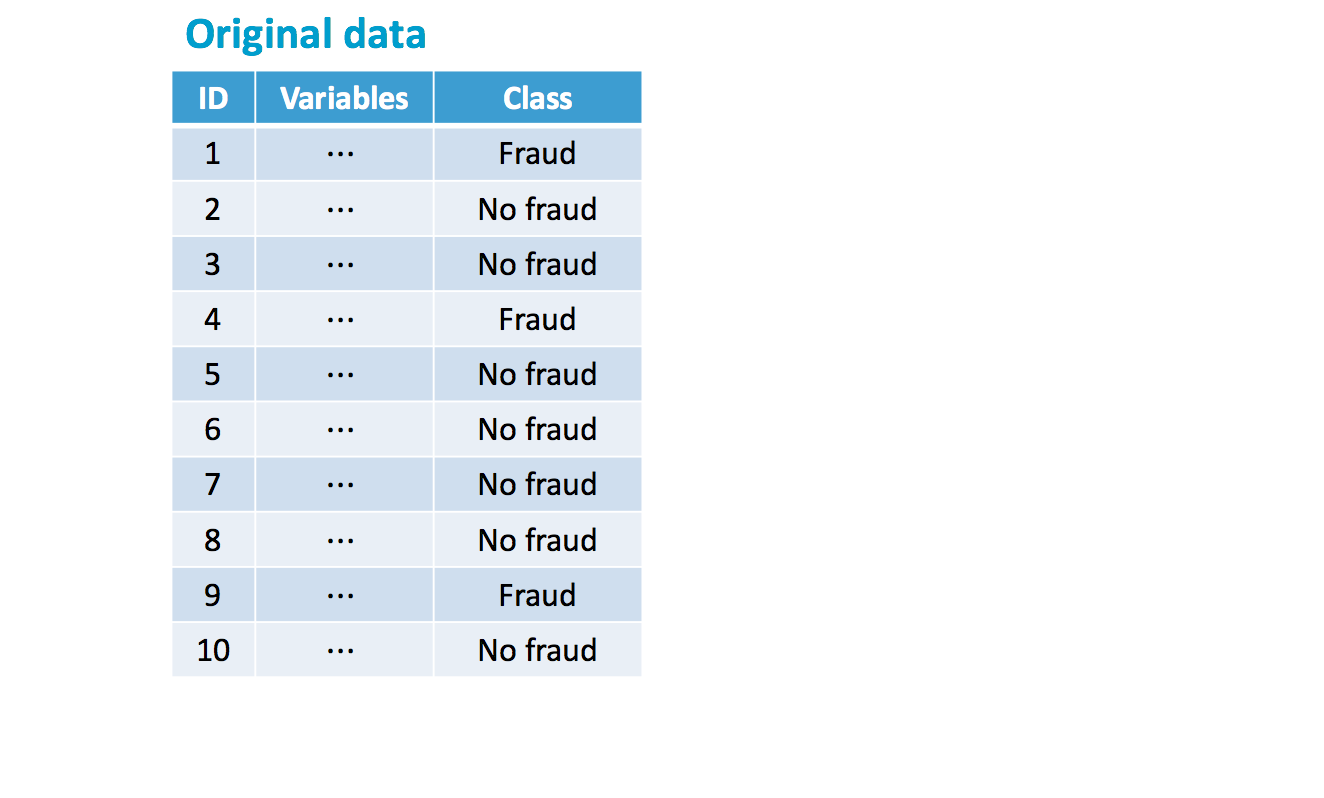
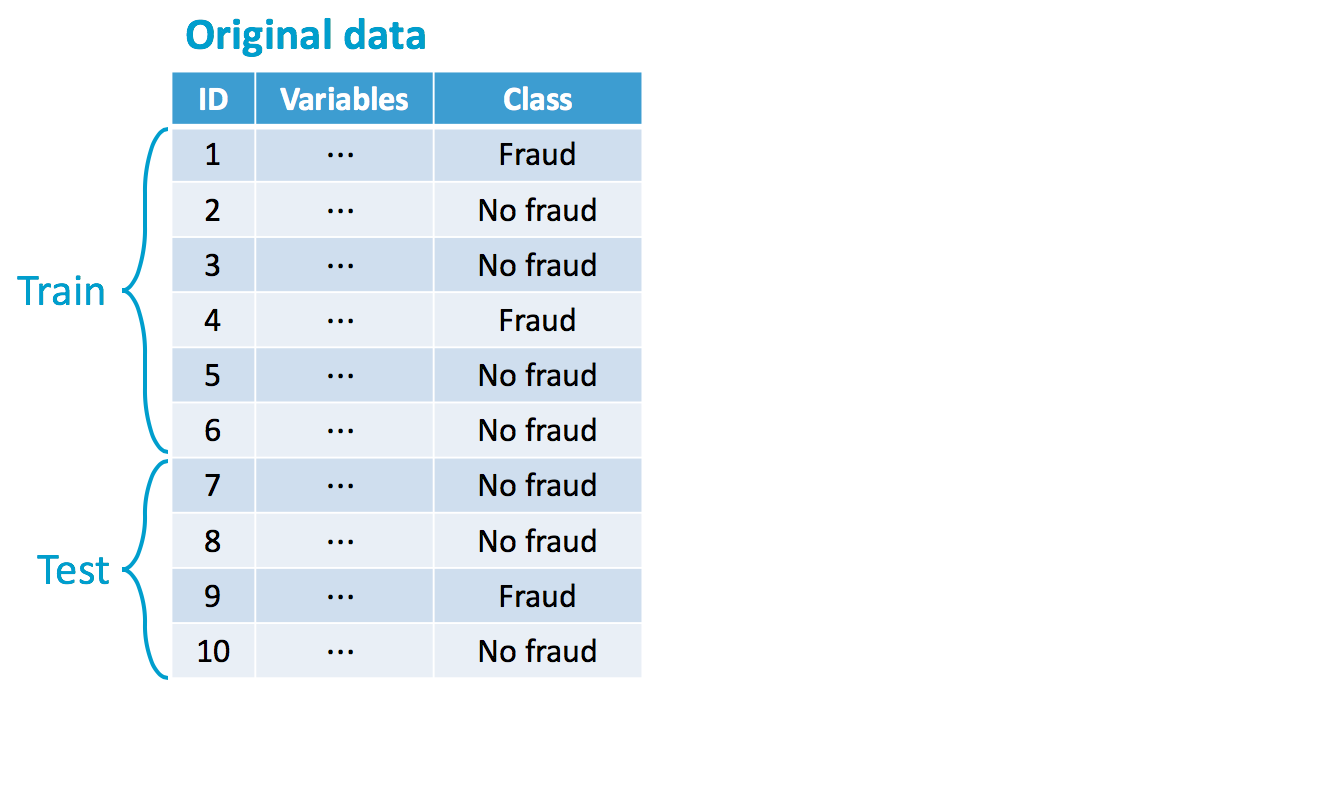
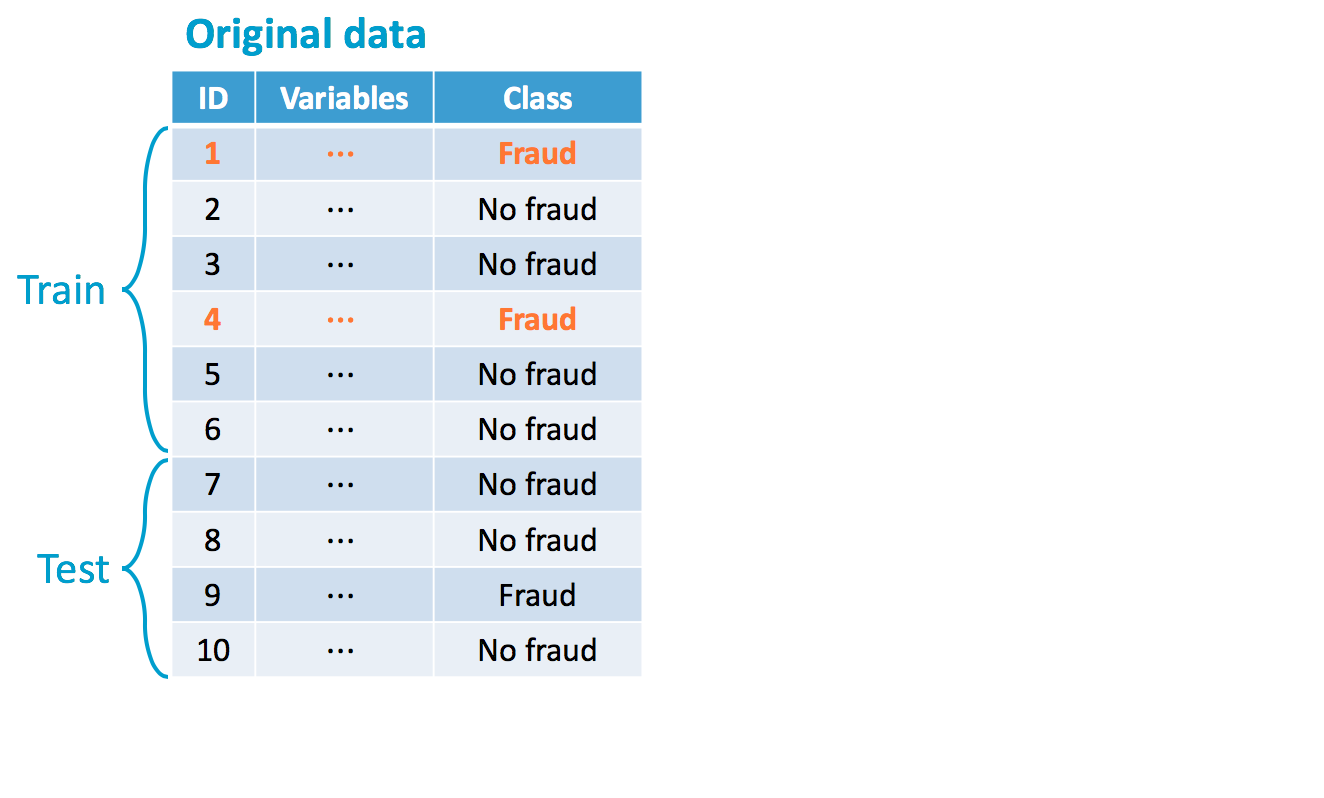
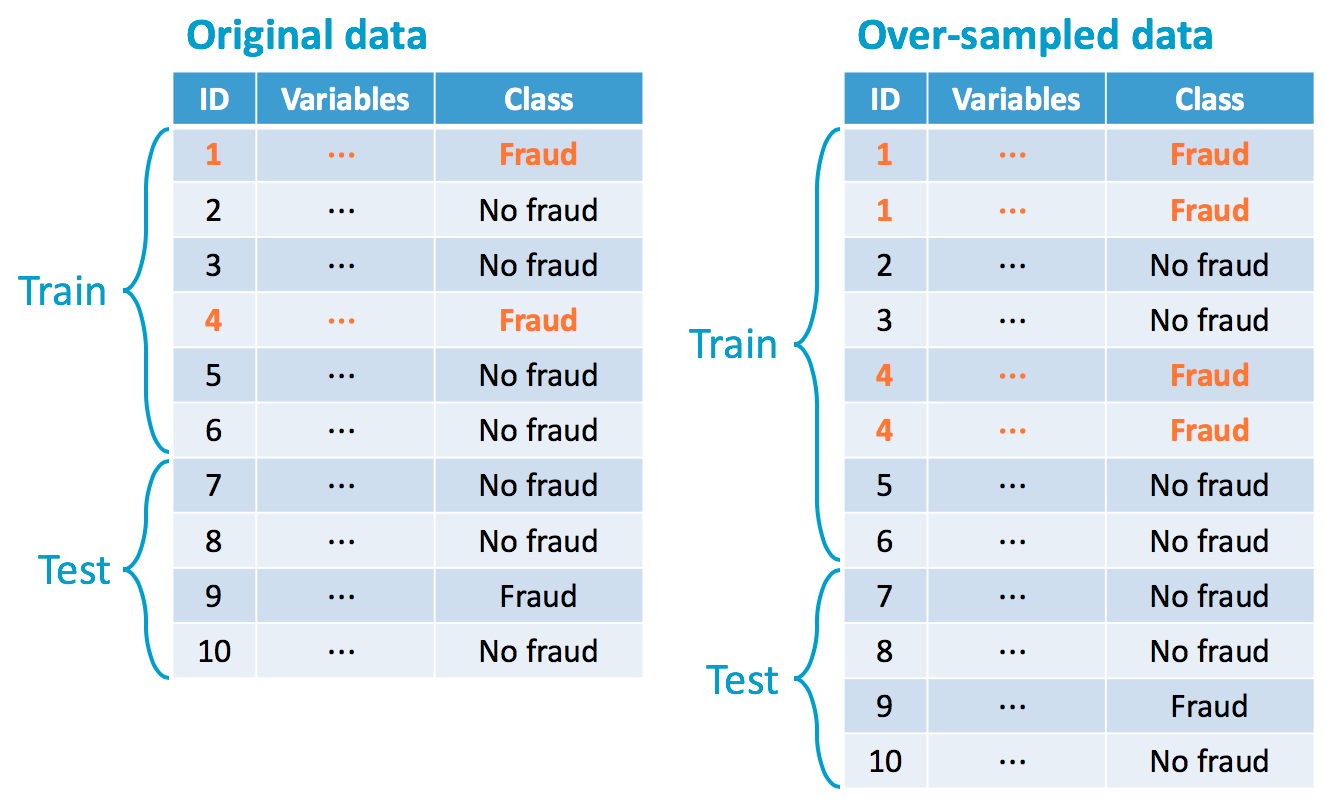
Random over-sampling (ROS)

orig_data_v0

Detecção de Fraudes em R

orig_data_train_test

Detecção de Fraudes em R

random_oversampling_v0

Detecção de Fraudes em R

random_oversampling_v1

Detecção de Fraudes em R

Random over-sampling na prática

  • Conjunto de dados de detecção de fraude em cartão de crédito no Kaggle
    • $\sim$ 300 mil transferências de cartão de crédito anonimizadas rotuladas como fraudulentas ou legítimas
  • Sobre os dados...
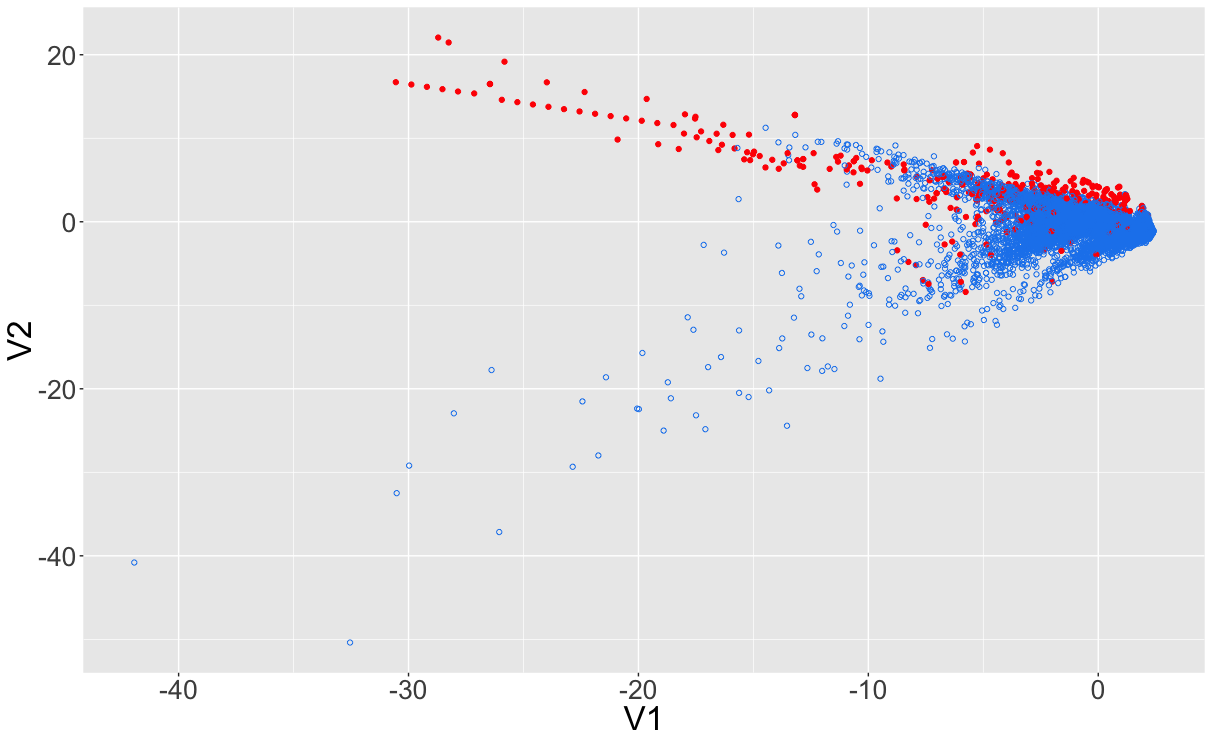
    • Variáveis numéricas (anonimizadas): V1, V2, ... , V28
    • Time = segundos entre cada transferência e a primeira do conjunto de dados
    • Amount = valor da transação
    • Class = variável resposta: 1 em caso de fraude e 0 caso contrário
Detecção de Fraudes em R

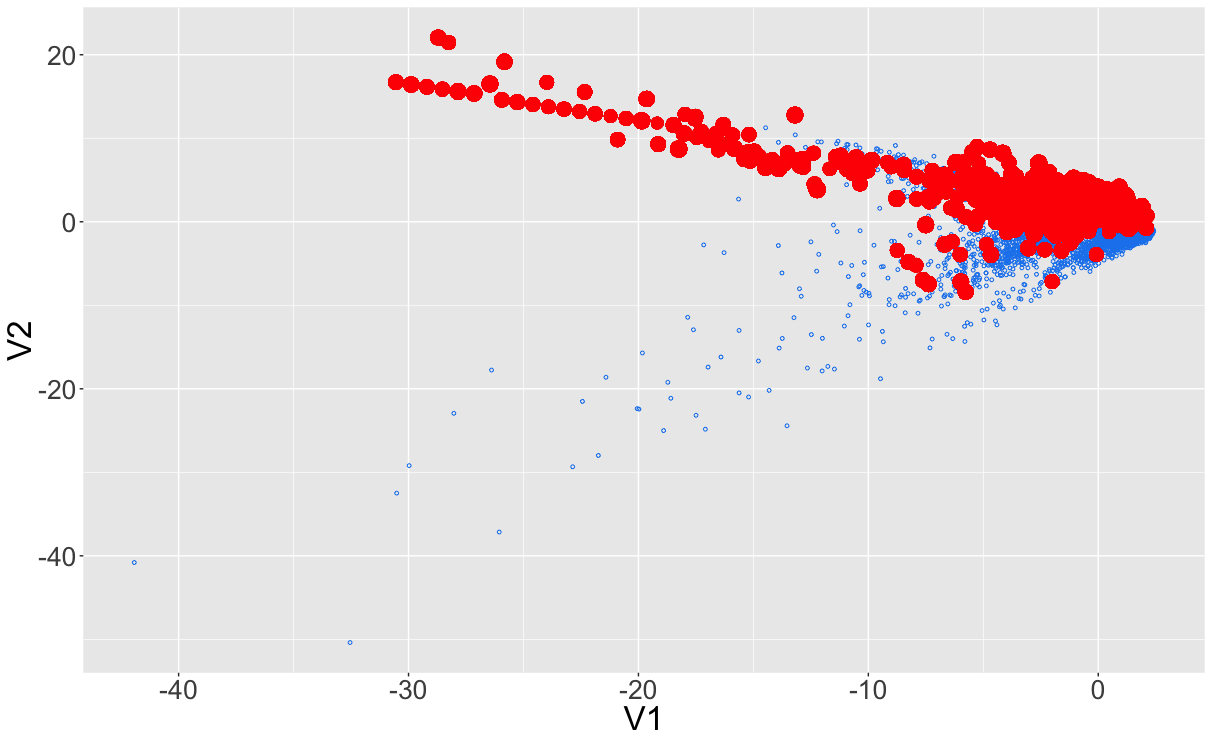
creditcard_V2vsV1

Detecção de Fraudes em R

Verifique o desbalanceamento

head(creditcard)
  Time         V1         V2  ...            V27         V28 Amount Class
1    0  1.1918571  0.2661507  ...  -0.0089830991  0.01472417   2.69     0
2   10  0.3849782  0.6161095  ...   0.0424724419 -0.05433739   9.99     0
3   12 -0.7524170  0.3454854  ...  -0.1809975001  0.12939406  15.99     0
4   17  0.9624961  0.3284610  ...   0.0163706433 -0.01460533  34.09     0
5   34  0.2016859  0.4974832  ...   0.1427572469  0.21923761   9.99     0
prop.table(table(creditcard$Class))
   0    1 
0.98 0.02
Detecção de Fraudes em R

ovun.sample do pacote ROSE

n_legit <- 24108
new_frac_legit <- 0.50
new_n_total <- n_legit / new_frac_legit ## = 24108 / 0.50 = 48216

library(ROSE) oversampling_result <- ovun.sample(formula = Class ~ ., data = creditcard, method = "over", N = new_n_total, seed = 2018)
oversampled_credit <- oversampling_result$data prop.table(table(oversampled_credit$Class))
  0   1 
0.5 0.5
Detecção de Fraudes em R

creditcard_V2vsV1_oversampled

Detecção de Fraudes em R

Vamos praticar!

Detecção de Fraudes em R

Preparing Video For Download...