Do conjunto de dados ao modelo de detecção

Detecção de Fraudes em R

Sebastiaan Höppner

PhD researcher in Data Science at KU Leuven

Roteiro

  • (1) Divida o conjunto em training set e test set
  • (2) Escolha um modelo de machine learning
  • (3) Aplique SMOTE no training set para equilibrar as classes
  • (4) Treine o modelo no training set reequilibrado
  • (5) Teste o desempenho no test set (original)
Detecção de Fraudes em R

Divida o conjunto em training & test

  • Divida o conjunto em training set e test set (ex.: 50/50, 75/25, ...)
  • Garanta que ambos tenham a mesma distribuição de classes (no início)
  • Exemplo: 50% training set e 50% test set
prop.table(table(train$Class))
   0    1 
0.98 0.02
prop.table(table(test$Class))
   0    1 
0.98 0.02
Detecção de Fraudes em R

Escolha e treine o modelo de machine learning

  • Árvore de decisão, rede neural artificial, máquinas de vetores de suporte, regressão logística, random forest, Naive Bayes, k-Nearest Neighbors, ...
  • Exemplo: algoritmo Classification And Regression Tree (CART)
  • Função rpart no pacote rpart
library(rpart)

model1 = rpart(Class ~ ., data = train)
Detecção de Fraudes em R
library(partykit)
plot(as.party(model1))
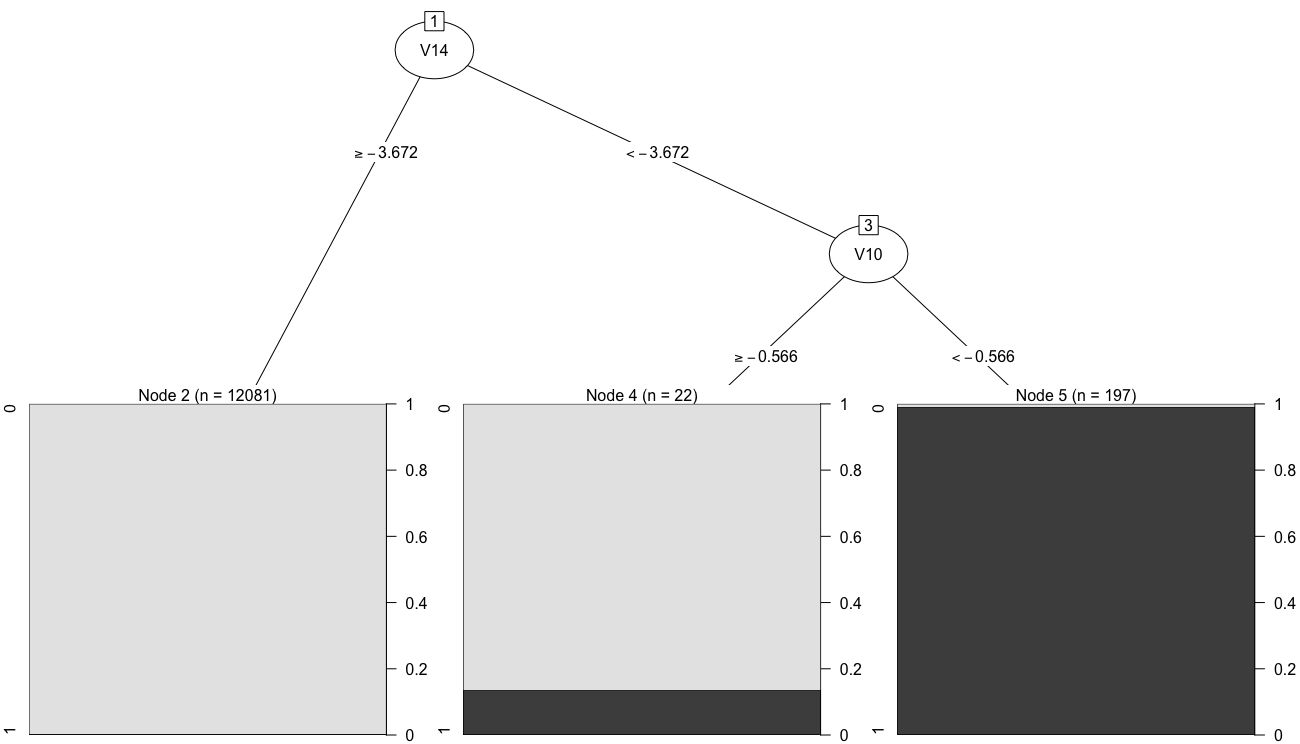
tree1

Detecção de Fraudes em R
## Prever a probabilidade de fraude no test set
scores1 = predict(model1, newdata = test, type = "prob")[, 2]

## Prever a classe (fraude ou não) no test set predicted_class1 = factor(ifelse(scores1 > 0.5, 1, 0))
## Matriz de confusão e acurácia, library(caret) CM1 = confusionMatrix(data = predicted_class1, reference = test$Class)
          Reference         
Prediction     0     1
         0 12046    55
         1     8   191       Accuracy : 0.994878
library(pROC)
auc(roc(response = test$Class, predictor = scores1)) ## Area Under ROC Curve (AUC)
Area under the ROC curve: 0.8938
Detecção de Fraudes em R

Aplique SMOTE no training set

library(smotefamily)
set.seed(123)

smote_result = SMOTE(X = train[, -17],
                     target = train$Class,
                     K = 5,
                     dup_size = 10)

train_oversampled = smote_result$data colnames(train_oversampled)[17] = "Class"
prop.table(table(train_oversampled$Class))
        0         1 
0.8166667 0.1833333
Detecção de Fraudes em R
library(rpart)
model2 = rpart(Class ~ ., data = train_oversampled)
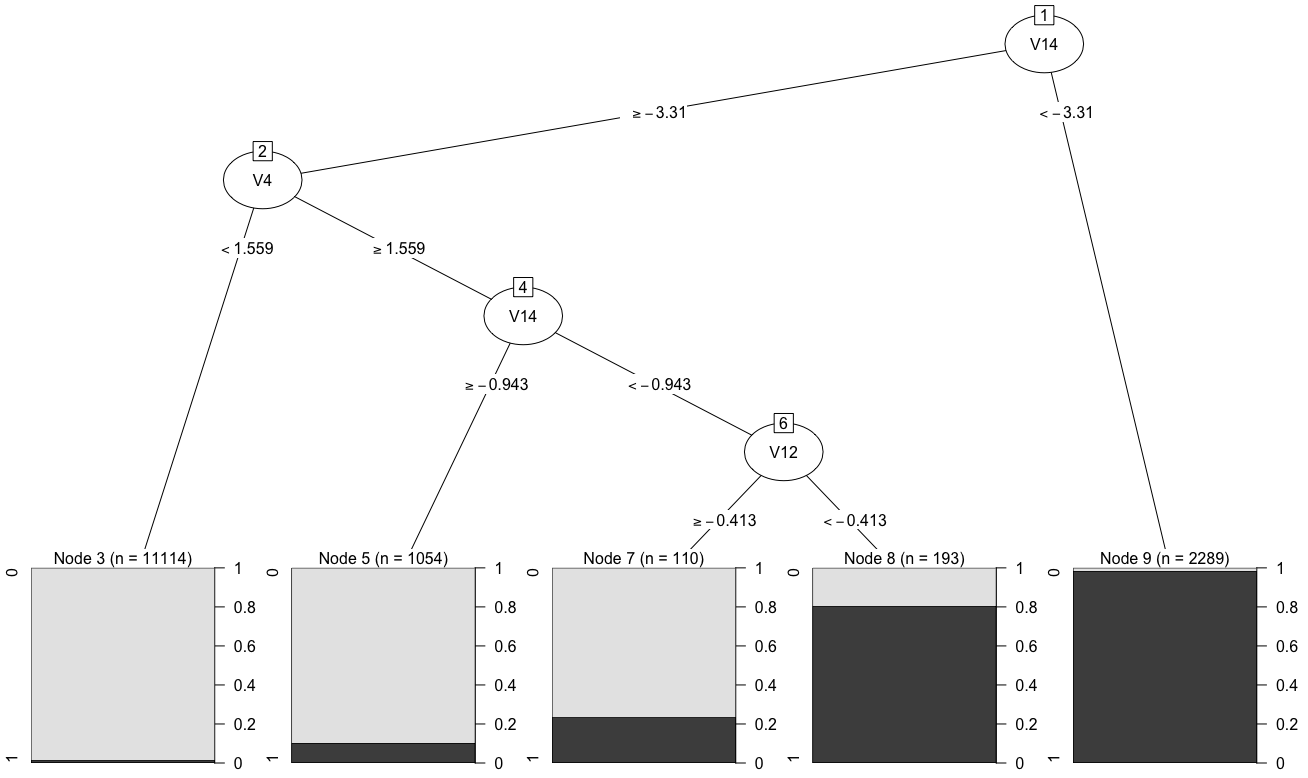
tree2

Detecção de Fraudes em R
## Prever a probabilidade de fraude no test set
scores2 = predict(model2, newdata = test, type = "prob")[, 2]

## Prever a classe (fraude ou não) no test set predicted_class2 = factor(ifelse(scores2 > 0.5, 1, 0))
## Matriz de confusão e acurácia library(caret) CM2 = confusionMatrix(data = predicted_class2, reference = test$Class)
          Reference
Prediction     0     1
         0 11967    34
         1    87   212       Accuracy : 0.9901626                                
library(pROC)
auc(roc(response = test$Class, predictor = scores2)) ## Area Under ROC Curve (AUC)
Area under the curve: 0.9538
Detecção de Fraudes em R

Custo de implantar um modelo de detecção

  • Considere os diferentes custos da detecção de fraude ao avaliar um algoritmo
  • Custos estão associados a
    • erros de classificação (falsos positivos e falsos negativos) e
    • classificações corretas (verdadeiros positivos e verdadeiros negativos)
Detecção de Fraudes em R

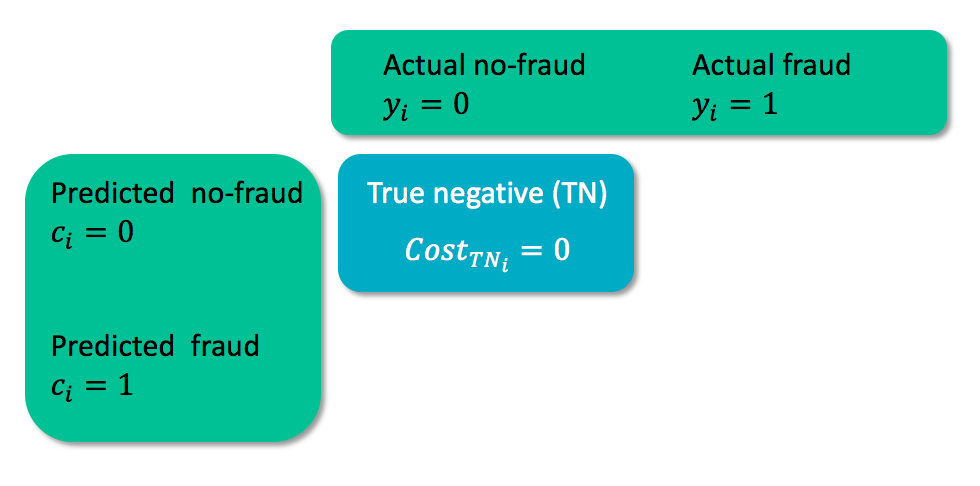
Matriz de custo

cost_matrix_1

  • $y_i$ = classe verdadeira do caso $i$
  • $c_i$ = classe prevista para o caso $i$
Detecção de Fraudes em R

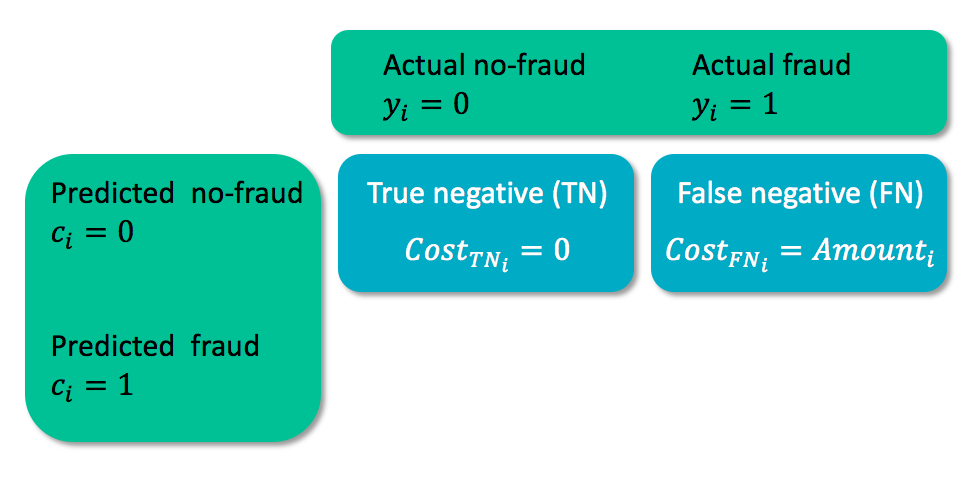
Matriz de custo

cost_matrix_2

  • $y_i$ = classe verdadeira do caso $i$
  • $c_i$ = classe prevista para o caso $i$
Detecção de Fraudes em R

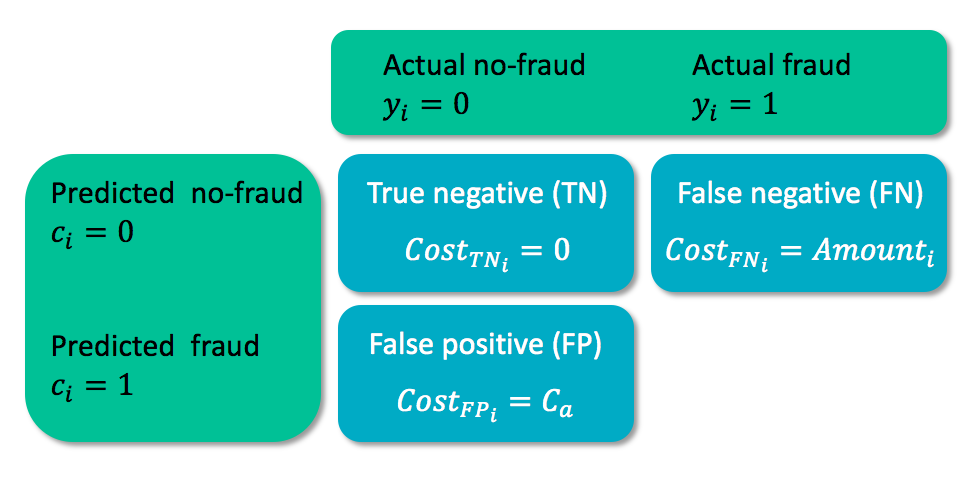
Matriz de custo

cost_matrix_3

  • $C_a$ = custo para analisar o caso
Detecção de Fraudes em R

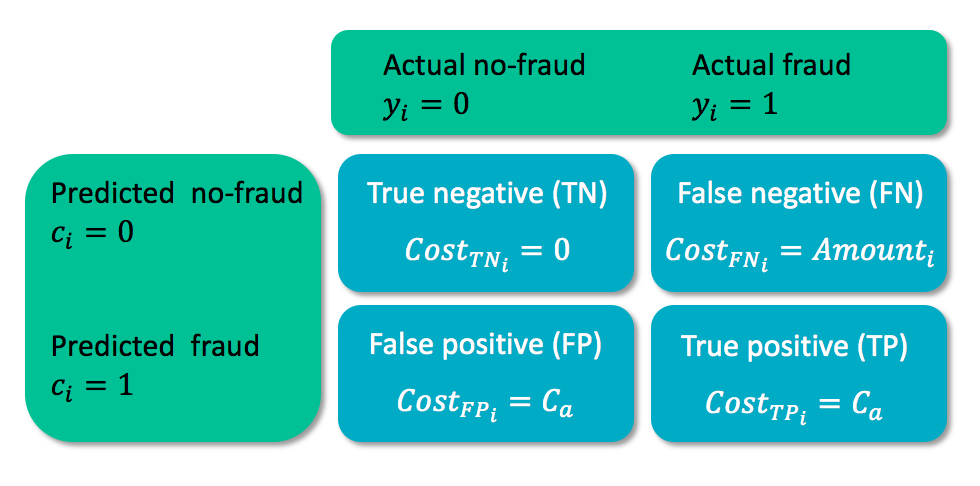
Matriz de custo

cost_matrix_4

  • $C_a$ = custo para analisar o caso
Detecção de Fraudes em R

Métrica de custo para um modelo de detecção

  • Considere os custos reais de cada caso: $$Cost(model)=\sum_{i=1}^{N}y_i(1-c_i)Amount_i + c_iC_a$$
    • $y_i$ = classe verdadeira do caso $i$
    • $c_i$ = classe prevista para o caso $i$
cost_model = function(predicted.classes, true.classes, amounts, fixedcost) {

    cost = sum(true.classes * (1 - predicted.classes) * amounts +
               predicted.classes * fixedcost)

    return(cost)
}
Detecção de Fraudes em R

Custo real da detecção de fraude

## Custo total sem usar SMOTE:
cost_model(predicted_class1, test$Class, test$Amount, fixedcost = 10)
10061.8
## Custo total usando SMOTE:
cost_model(predicted_class2, test$Class, test$Amount, fixedcost = 10)
7431.93
  • As perdas caem 26%!
Detecção de Fraudes em R

Vamos praticar!

Detecção de Fraudes em R

Preparing Video For Download...