Trabalhando com um objeto de previsão

Projetando Pipelines de Previsão para Produção

Rami Krispin

Senior Manager, Data Science and Engineering

Trabalhe com um objeto de previsão

  • Preparação dos dados
  • Treinar e testar vários modelos de previsão
  • Avaliar o desempenho dos modelos
  • O pacote statsforecast
    • mlforecast nos exercícios
Projetando Pipelines de Previsão para Produção

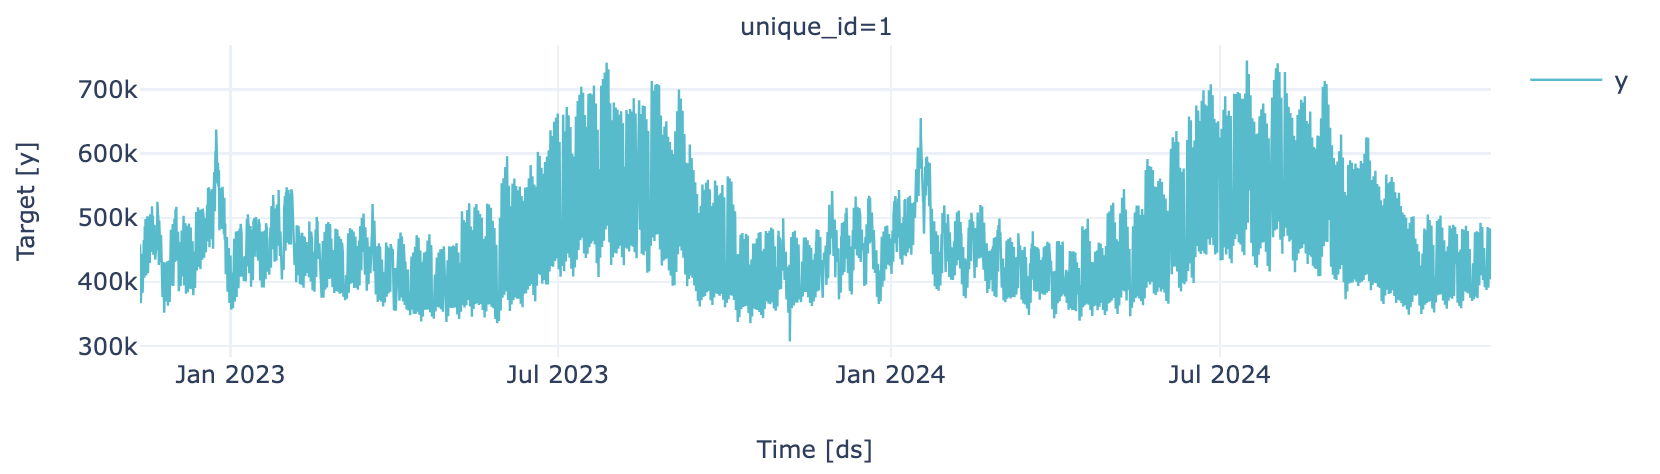
Partição de treino

Séries temporais

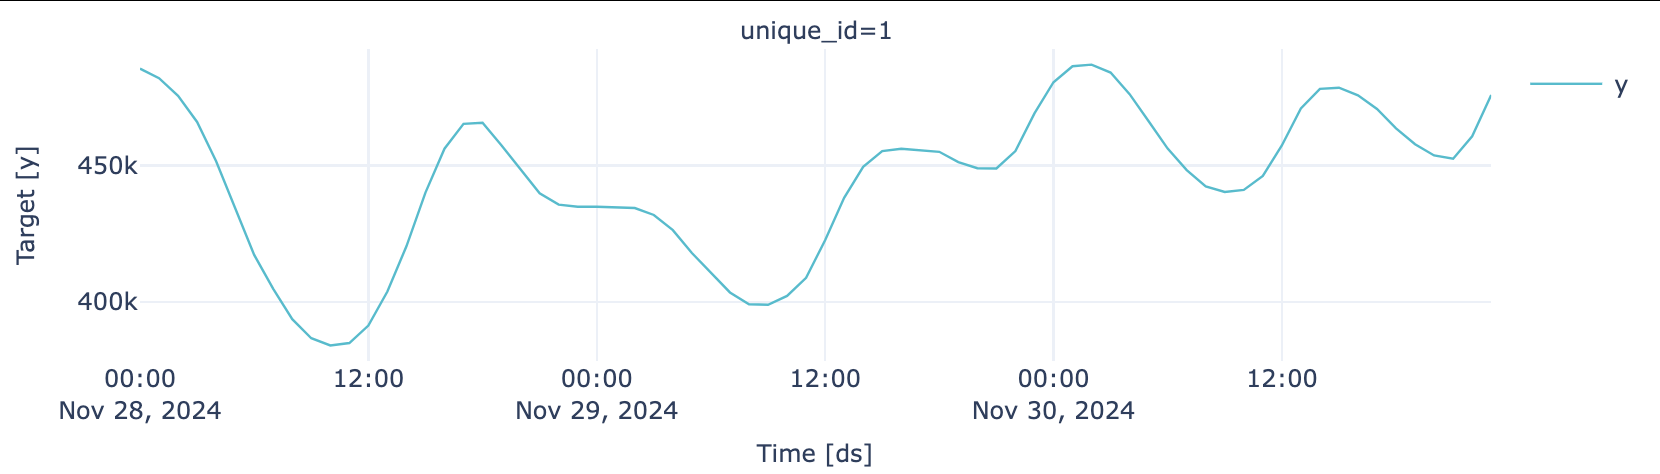
Partição de teste

Partição de teste

Projetando Pipelines de Previsão para Produção

Bibliotecas necessárias

import pandas as pd 
import datetime 
Projetando Pipelines de Previsão para Produção

Bibliotecas necessárias

from statsforecast import StatsForecast

from statsforecast.models import (
    DynamicOptimizedTheta,
    SeasonalNaive,
    AutoARIMA,
    HoltWinters,
    MSTL
)

from utilsforecast.plotting import plot_series
Projetando Pipelines de Previsão para Produção

O formato de dados do statsforecast

Formato de entrada dos dados:

  1. unique_id - o ID da série
  2. ds - o timestamp da série
  3. y - os valores da série
Projetando Pipelines de Previsão para Produção

Preparação dos dados - carregamento

ts = pd.read_csv("data/data.csv")
ts["ds"] = pd.to_datetime(ts["ds"])
ts = ts.sort_values("ds")
ts = ts[["unique_id", "ds", "y"]]

os.environ['NIXTLA_ID_AS_COL'] = '1'
 unique_id        ds             y
0    1    2022-11-11 23:00:00    456403
1    1    2022-11-12 00:00:00    458842
2    1    2022-11-12 01:00:00    455111
3    1    2022-11-12 02:00:00    448035
4    1    2022-11-12 03:00:00    438165
Projetando Pipelines de Previsão para Produção

Preparação dos dados - divisão treino/teste

  • Dividir a série temporal em partições de treino e teste
    • usando datetime.timedelta
    • deixar as últimas 72 horas para teste
test_length = 72

train_end = end  - datetime.timedelta(hours = test_length)

train = ts[ts["ds"] <= train_end]
test = ts[ts["ds"] > train_end]
Projetando Pipelines de Previsão para Produção

Preparação dos dados

plot_series(train, engine = "plotly")

Séries temporais

plot_series(test, engine = "plotly")

Partição de teste

Projetando Pipelines de Previsão para Produção

Previsão com StatsModels

# Instantiate models with hourly seasonality
auto_arima = AutoARIMA()
s_naive = SeasonalNaive(season_length=24)
theta =  DynamicOptimizedTheta(season_length=24)

# Instantiate models with hourly and weekly seasonality mstl1 = MSTL(season_length=[24, 24 * 7], trend_forecaster=AutoARIMA(), alias="MSTL_ARIMA_trend") mstl2 = MSTL(season_length=[24, 24 * 7], trend_forecaster=HoltWinters(), alias="MSTL_Holt_trend")
Projetando Pipelines de Previsão para Produção

Previsão com StatsModels

# Combine models into a list
stats_models = [auto_arima, s_naive, theta, mstl1, mstl2]

# Instantiate the model object sf = StatsForecast( models=stats_models, freq="h", fallback_model = AutoARIMA(), n_jobs= -1)
Projetando Pipelines de Previsão para Produção

Previsão com StatsModels

# Combine models into a list
stats_models = [auto_arima, s_naive, theta, mstl1, mstl2]

# Instantiate the model object sf = StatsForecast( models=stats_models, freq="h", fallback_model = AutoARIMA(), n_jobs= -1)
# Create the forecast forecast_stats = sf.forecast(df=train, h=72, level=[95])
Projetando Pipelines de Previsão para Produção

Previsão com StatsModels

p = sf.plot(test, forecast_stats, engine = "plotly", level=[95])
p.update_layout(height=400)
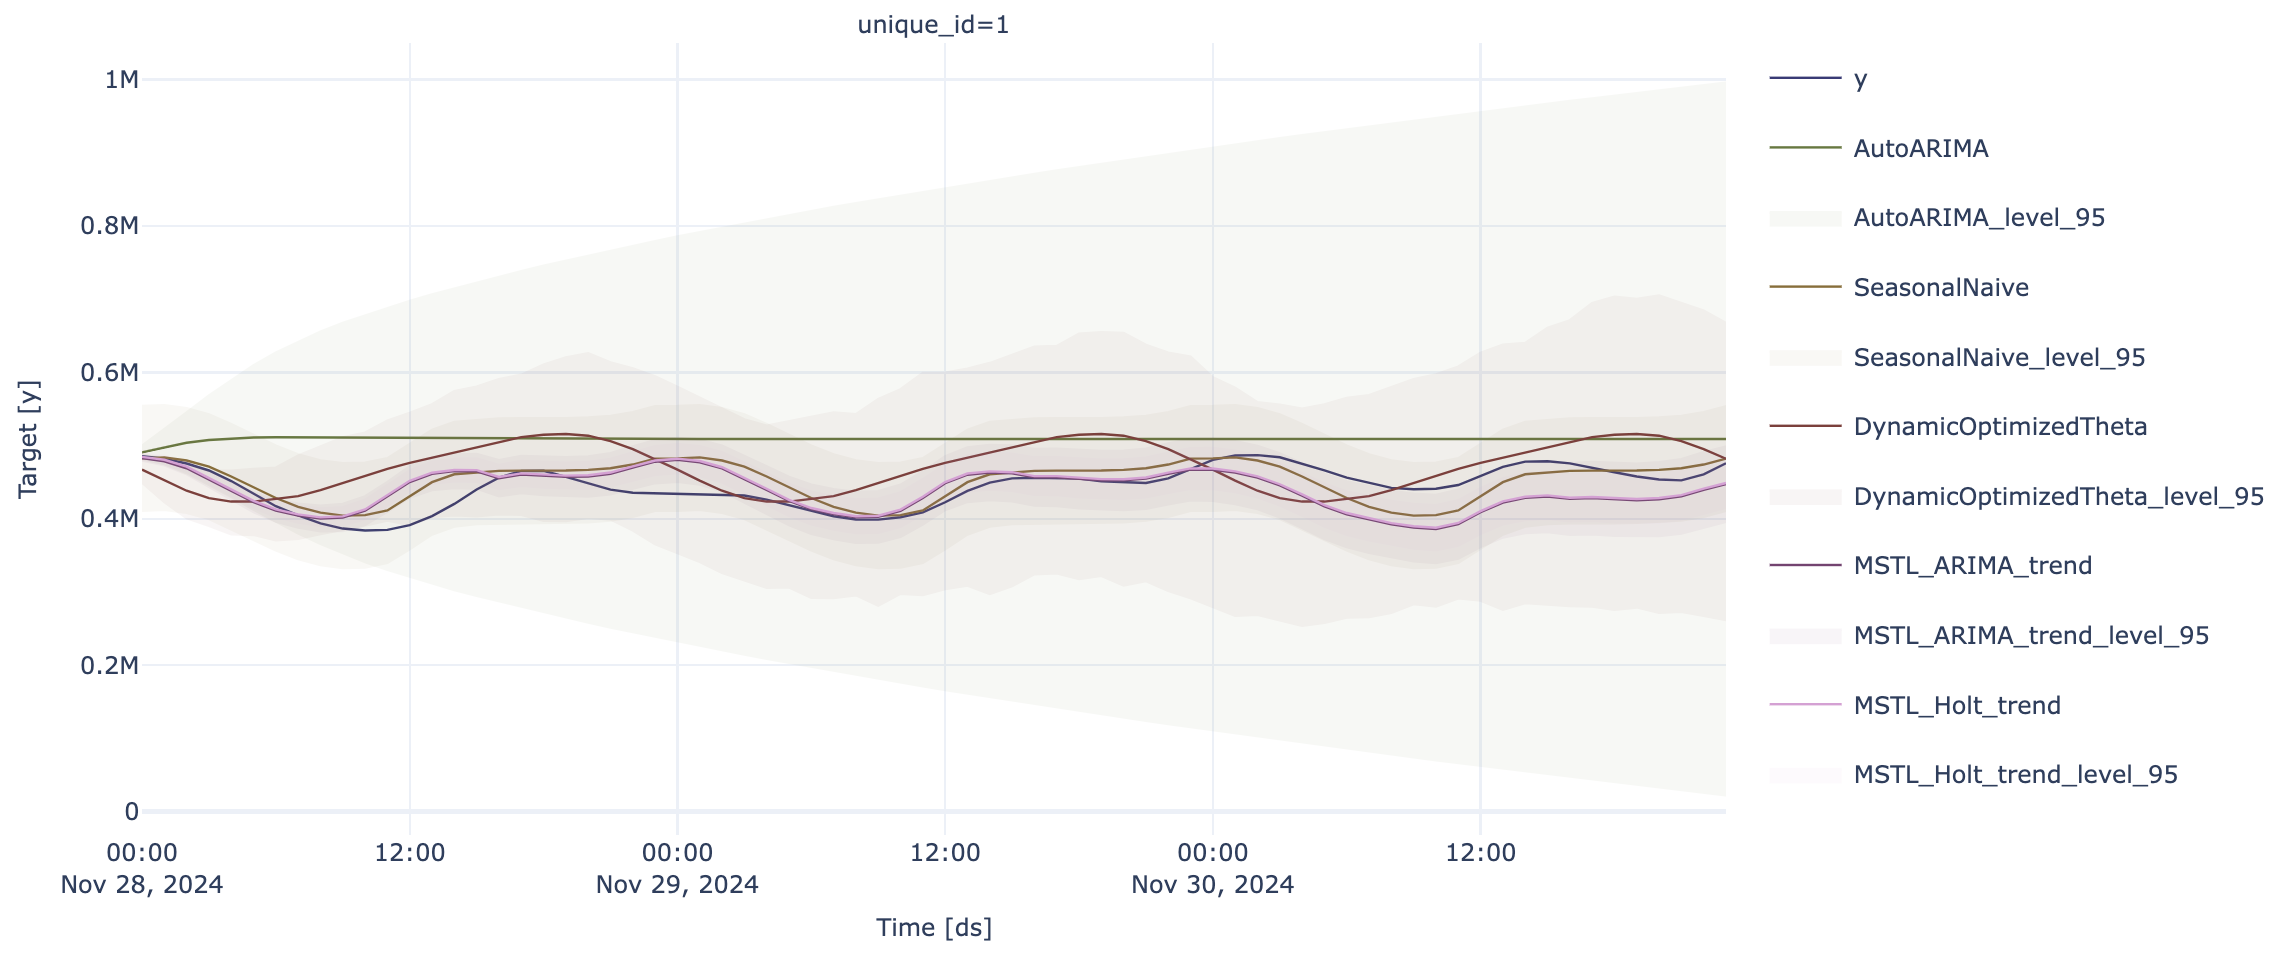
Gráfico de previsão

Projetando Pipelines de Previsão para Produção

Avaliação do modelo

def mape(y, yhat):
    mape = mean(abs(y - yhat)/ y) 
    return mape

def rmse(y, yhat):
    rmse = (mean((y - yhat) ** 2 )) ** 0.5
    return rmse

def coverage(y, lower, upper):
    coverage = sum((y <= upper) & (y >= lower)) / len(y)
    return coverage
Projetando Pipelines de Previsão para Produção

Avaliação do modelo

fc = forecast_stats.merge(test, how="left", on="ds")
fc_performance = None

for i in [str(m) for m in stats_models]:
    m = mape(y = fc["y"], yhat = fc[i])
    r = rmse(y = fc["y"], yhat = fc[i])
    c = coverage(y = fc["y"], lower = fc[i + "-lo-95"], upper = fc[i + "-hi-95"])

perf = {"model": i, "mape": m, "rmse": r, "coverage": c} if fc_performance is None: fc_performance = pd.DataFrame([perf]) else: fc_performance = pd.concat([fc_performance, pd.DataFrame([perf])]) fc_performance.reset_index(drop=True, inplace=True)
Projetando Pipelines de Previsão para Produção

Avaliação do modelo

print(fc_performance.sort_values("rmse"))
     model                    mape        rmse            coverage
1    SeasonalNaive            0.041340    22410.483959    1.000000
4    MSTL_Holt_trend          0.053939    30201.299395    0.513889
3    MSTL_ARIMA_trend         0.053771    30428.240235    0.666667
2    DynamicOptimizedTheta    0.090566    45189.869437    0.916667
0    AutoARIMA                0.149790    70483.617198    1.000000
Projetando Pipelines de Previsão para Produção

Avaliação do modelo

print(fc_performance.sort_values("rmse"))
     model                    mape        rmse            coverage
1    SeasonalNaive            0.041340    22410.483959    1.000000
4    MSTL_Holt_trend          0.053939    30201.299395    0.513889
3    MSTL_ARIMA_trend         0.053771    30428.240235    0.666667
2    DynamicOptimizedTheta    0.090566    45189.869437    0.916667
0    AutoARIMA                0.149790    70483.617198    1.000000

Podemos melhorar os resultados?

  • Ajustes diferentes para mais precisão
  • Experimentos ajudam muito
Projetando Pipelines de Previsão para Produção

Vamos praticar!

Projetando Pipelines de Previsão para Produção

Preparing Video For Download...