Tests d'hypothèse
Études de cas en pensée statistique

Justin Bois
Lecturer, Caltech
Effets d'une mutation sur l'activité
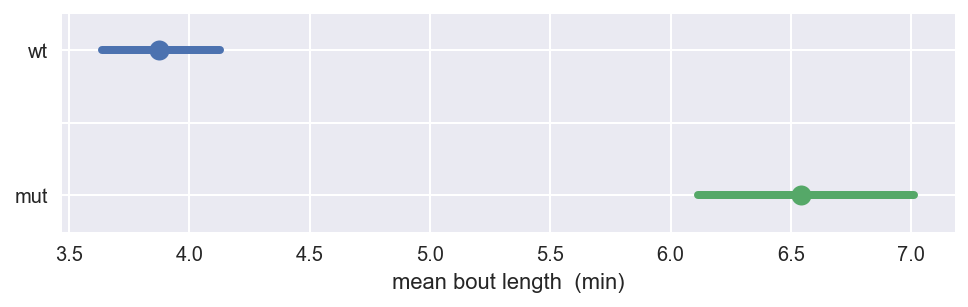
Définitions des génotypes
- Type sauvage : Aucune mutation
- Hétérozygote : Mutation sur un des deux chromosomes
- Mutant : Mutation sur les deux chromosomes
Effets d'une mutation sur l'activité
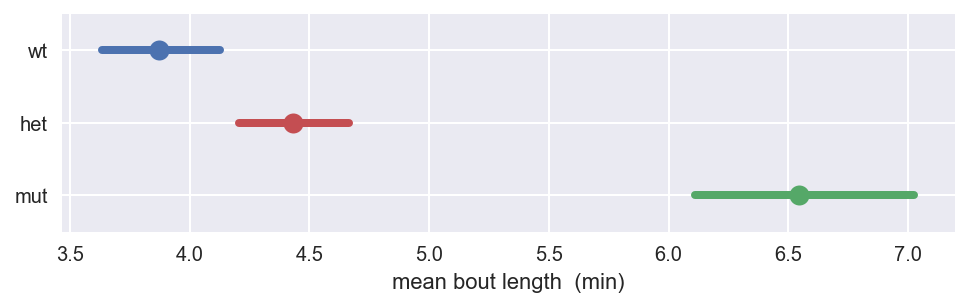
Effets d'une mutation sur l'activité
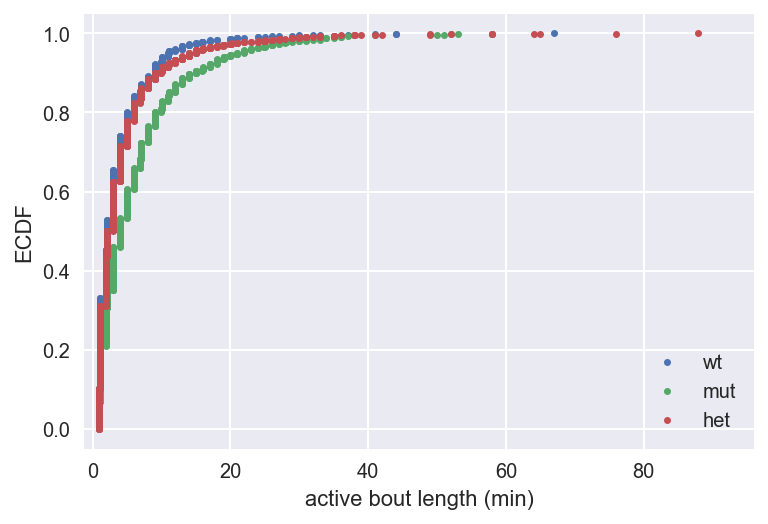
Test d'hypothèse
Évaluation du caractère plausible des données observées en supposant qu'une hypothèse est vraie
p-value
La probabilité d'obtenir une valeur de votre statistique de test au moins aussi extrême que celle observée, en supposant la nullité vraie
Statistique de test
- Un nombre unique calculé à partir des données observées et de données simulées sous l'hypothèse nulle
- Sert de base de comparaison
p-value
La probabilité d'obtenir une valeur de votre statistique de test au moins aussi extrême que celle observée, en supposant la nullité vraie
Nécessite de préciser :
- Hypothèse nulle simulable
- Statistique de test calculable sur les données observées et simulées
- Définition de au moins aussi extrême que
Pipeline d'un test d'hypothèse
- Énoncer clairement l'hypothèse nulle
- Définir la statistique de test
- Générer de nombreux jeux de données simulés en supposant la nullité vraie
- Calculer la statistique de test pour chaque jeu simulé
- La p-value est la fraction des jeux simulés où la statistique est au moins aussi extrême que pour les données réelles
Spécifier le test
Hypothèse nulle : les durées de phases actives des poissons de type sauvage et hétérozygotes sont distribuées de façon identique
Statistique de test : différence de durée moyenne des phases actives entre hétérozygotes et type sauvage
Au moins aussi extrême que : la statistique de test est supérieure ou égale à l'observée

