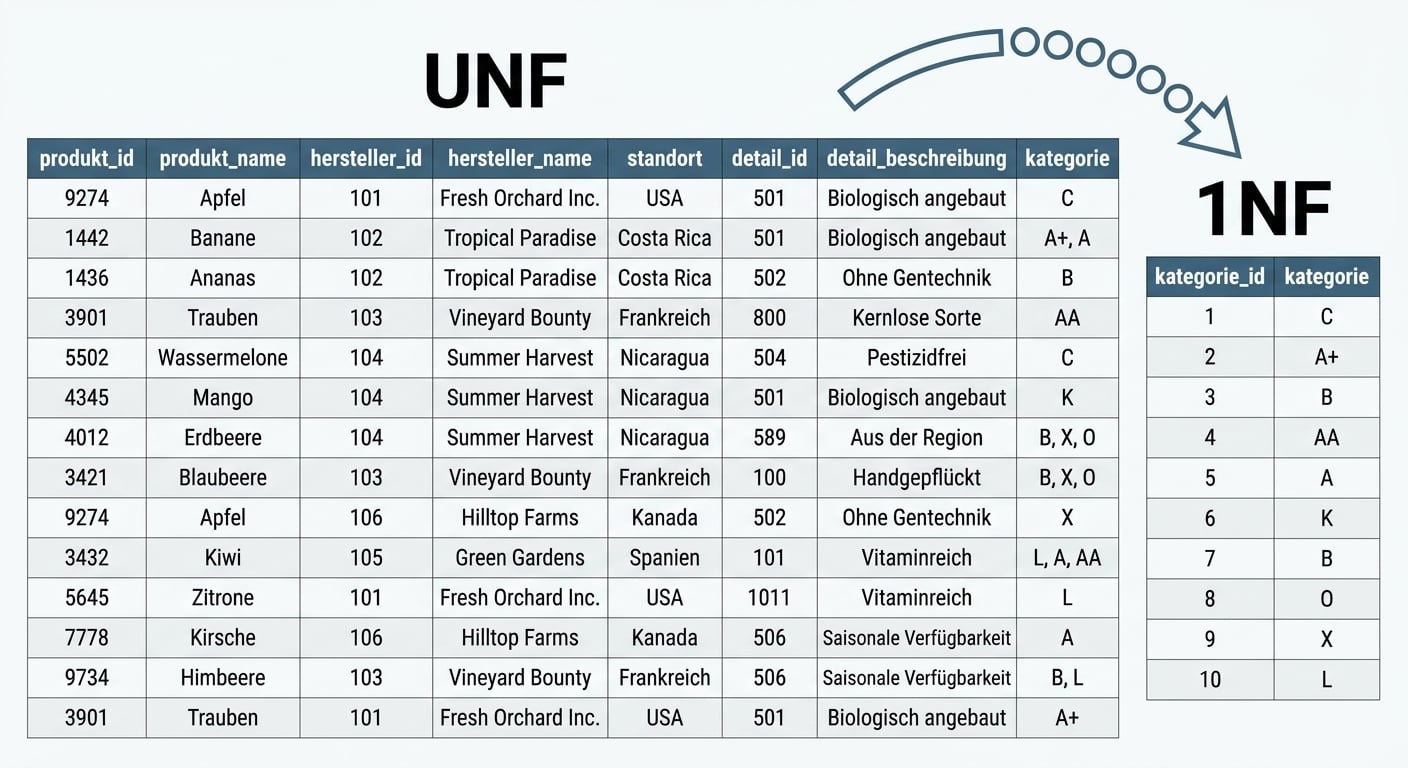
Die erste Normalform
Einführung in das Data Modeling in Snowflake

Nuno Rocha
Director of Engineering
Der Prozess der Daten-Normalisierung
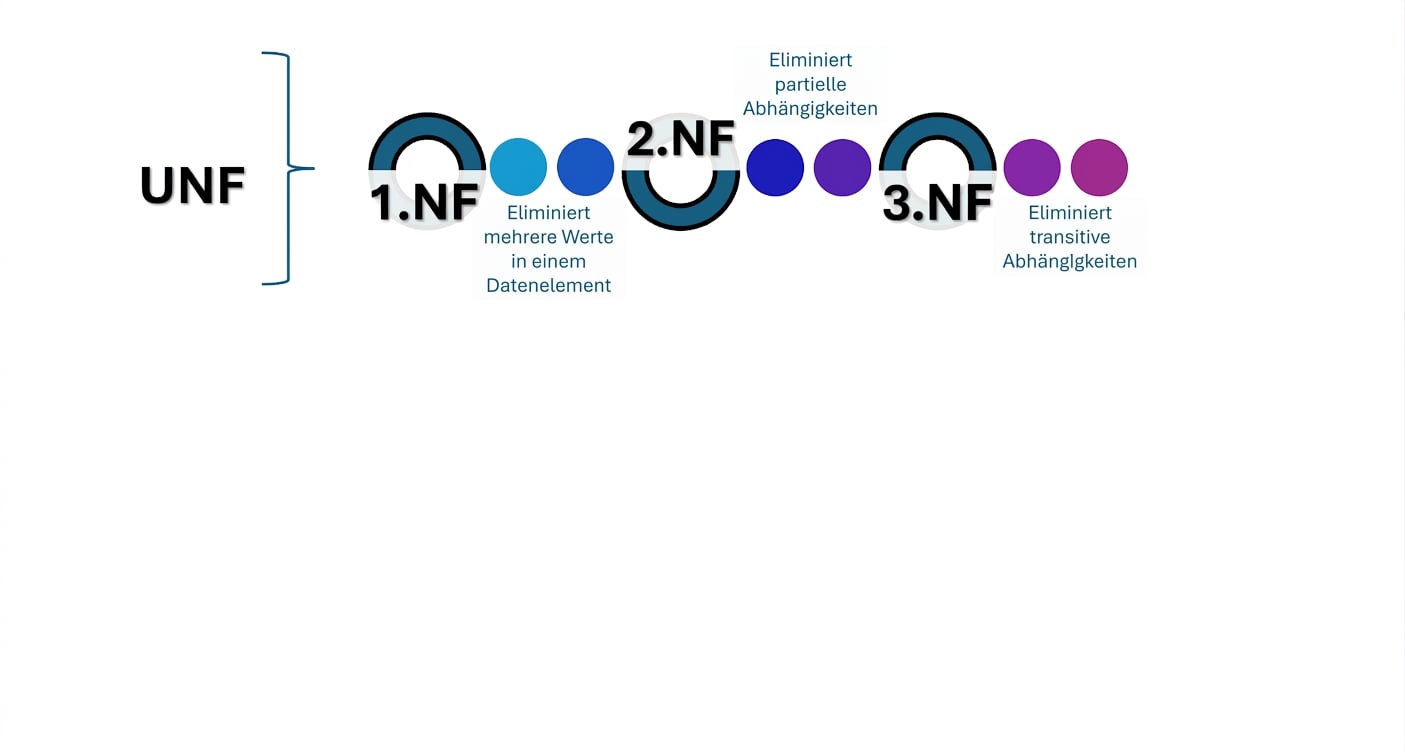
- Daten-Normalisierung: Mehrstufiger Prozess, um Daten so zu strukturieren, dass Duplikate und Abhängigkeiten minimiert werden
Der Prozess der Daten-Normalisierung (1)
- Daten-Normalisierung: Mehrstufiger Prozess, um Daten so zu strukturieren, dass Duplikate und Abhängigkeiten minimiert werden
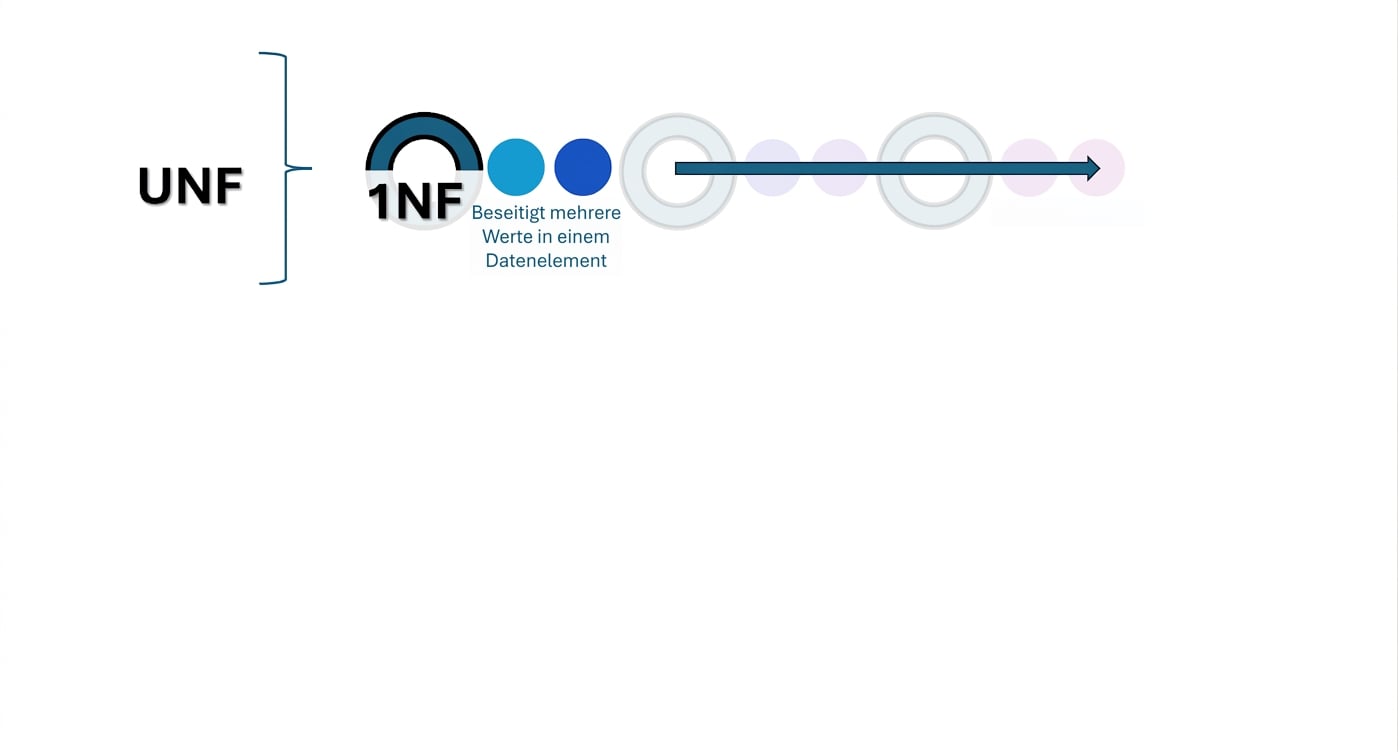
Der Prozess der Daten-Normalisierung (2)
- Daten-Normalisierung: Mehrstufiger Prozess, um Daten so zu strukturieren, dass Duplikate und Abhängigkeiten minimiert werden
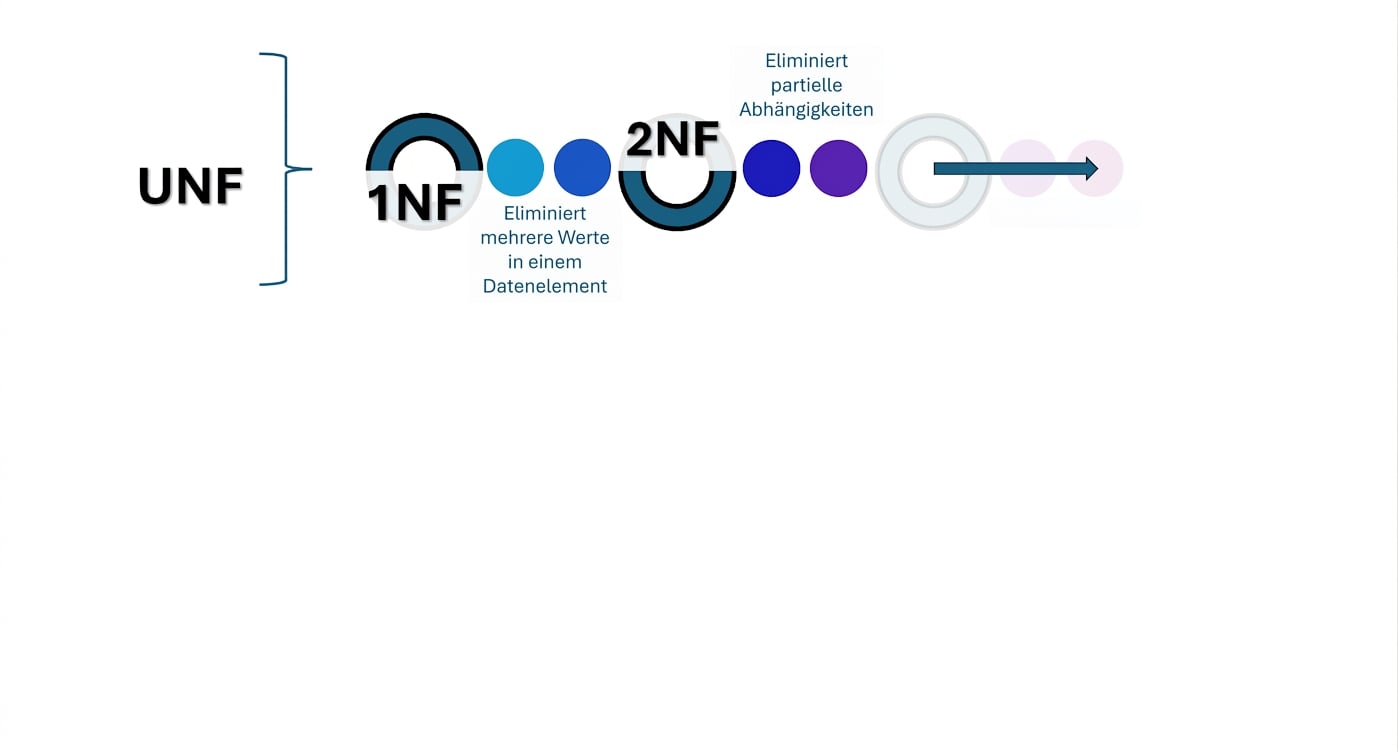
Der Prozess der Daten-Normalisierung (3)
- Daten-Normalisierung: Mehrstufiger Prozess, um Daten so zu strukturieren, dass Duplikate und Abhängigkeiten minimiert werden
Die erste Normalform
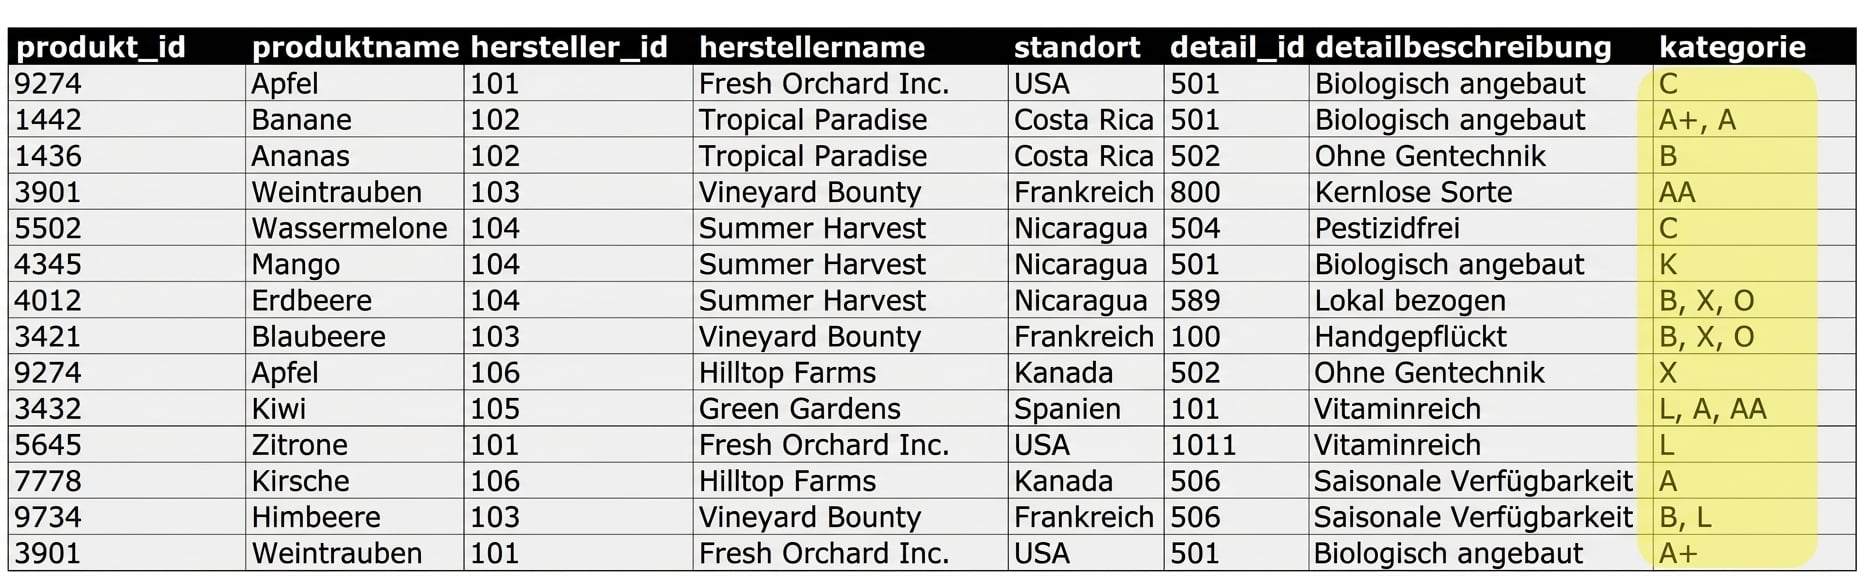
- Erste Normalform (1NF): Stellt sicher, dass jede Spalte einer Entität eindeutige atomare Werte enthält
Die erste Normalform (1)
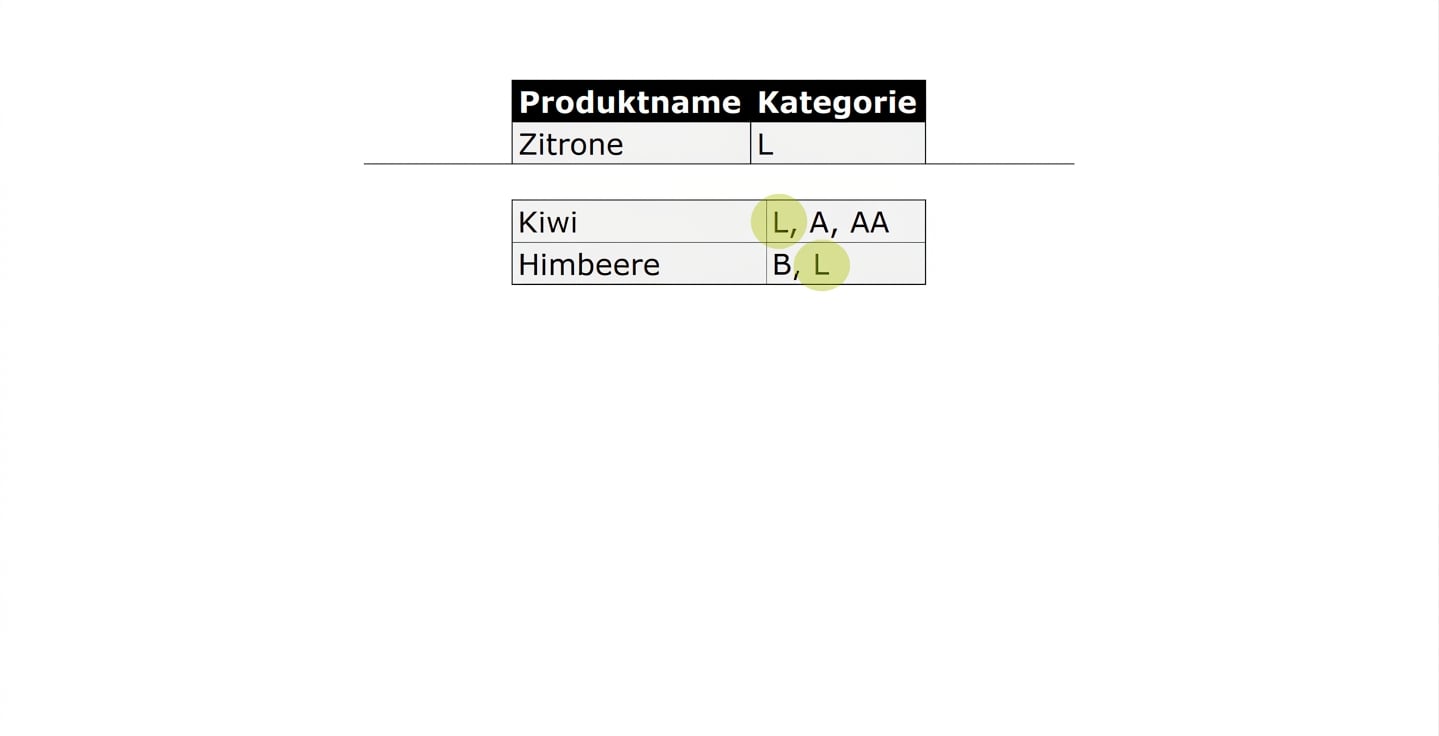
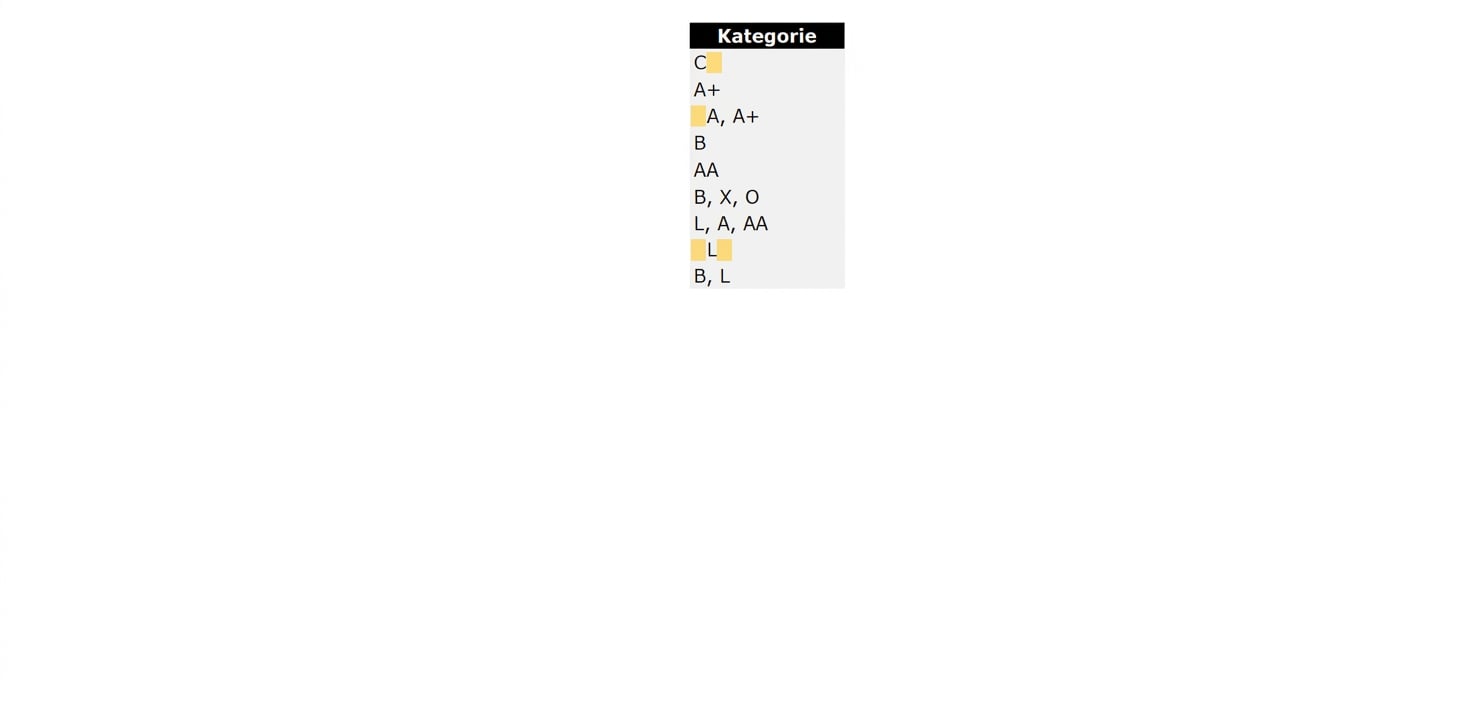
- UNF-Kategoriedaten: L-Kategorie ist nicht isoliert und kann deshalb nicht gezielt aktualisiert werden
Die erste Normalform (2)
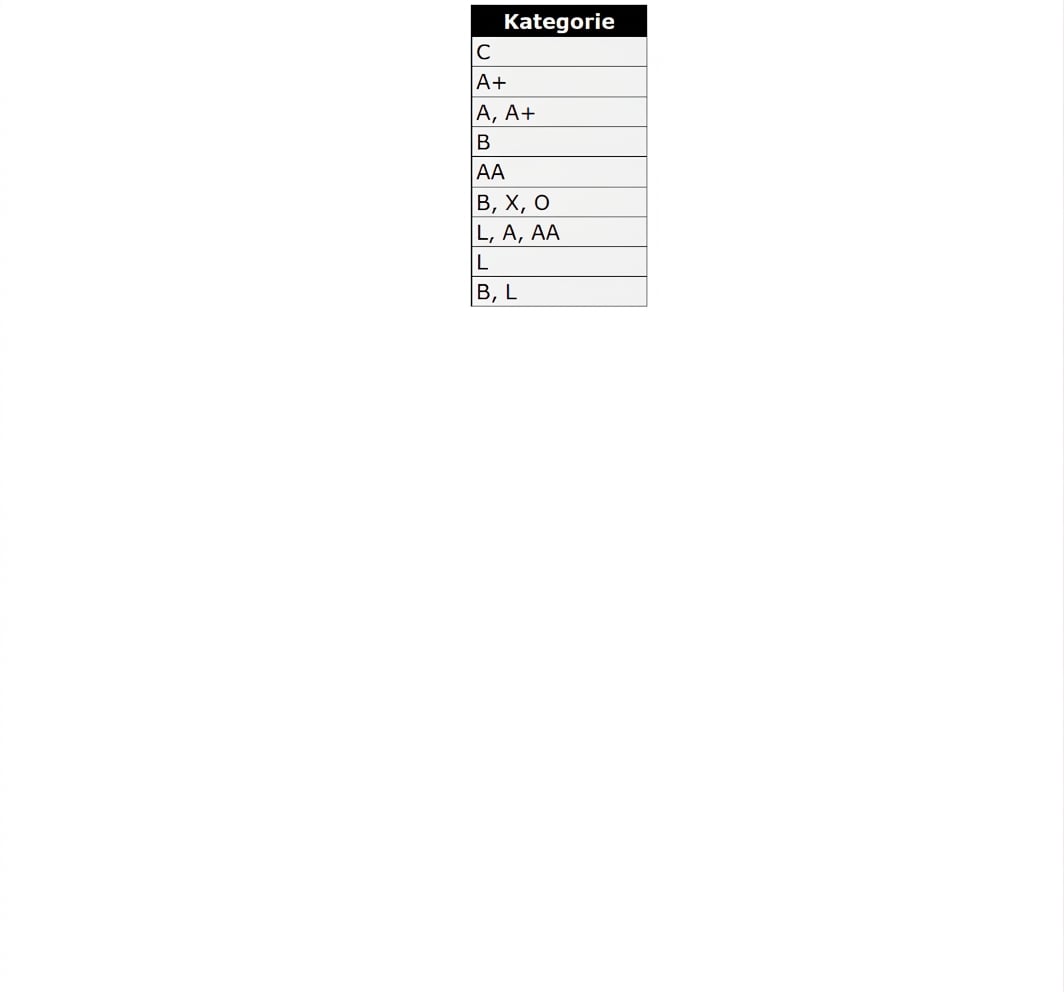
- Validierungsschritt: Frage die eindeutigen Werte ab, um die Einhaltung der 1NF zu prüfen.
SELECT DISTINCT category
FROM allproducts;
Snowflake-Funktionen für 1NF
- TRIM: Entfernt Leerzeichen am Anfang und Ende von Werten
SELECT TRIM(category)
FROM allproducts;
Snowflake-Funktionen für 1NF
- TRIM: Entfernt Leerzeichen am Anfang und Ende von Werten.
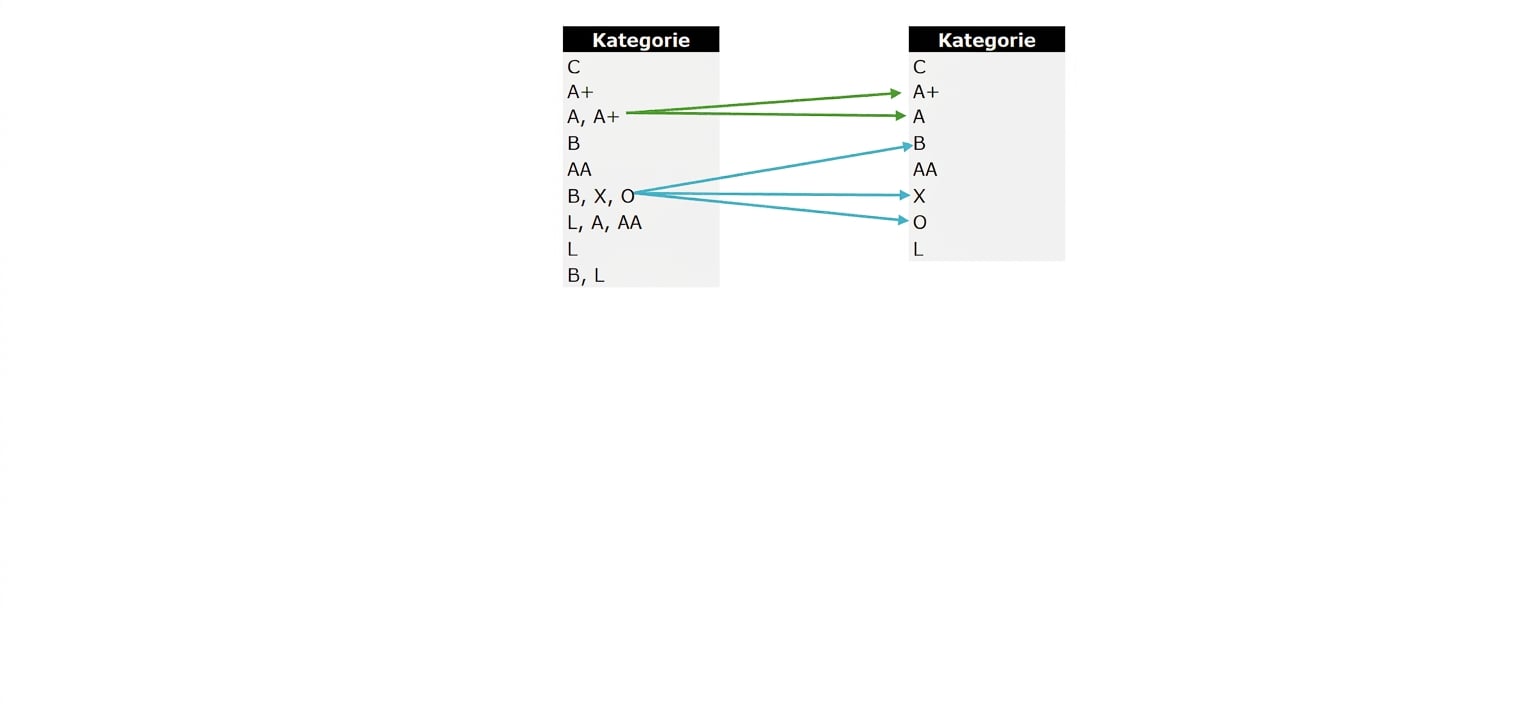
- LATERAL & FLATTEN: Behandeln eine Werteliste wie eine Tabelle mit Einzelwerten.
- SPLIT: Trennt Werte anhand eines Trennzeichens.
SELECT TRIM(f.value)
FROM allproducts,
LATERAL FLATTEN(INPUT => SPLIT(allproducts.category, ',')) f;
Auf dem Weg zur Daten-Normalisierung