Bootstrap-Konfidenzintervalle
Fallstudien zum statistischen Denken

Justin Bois
Lecturer, Caltech
EDA ist der erste Schritt
„Explorative Datenanalyse ist nie die ganze Geschichte, aber nichts anderes kann als Fundament, als erster Schritt dienen."
--John Tukey
ECDFs der aktiven Episodenlänge
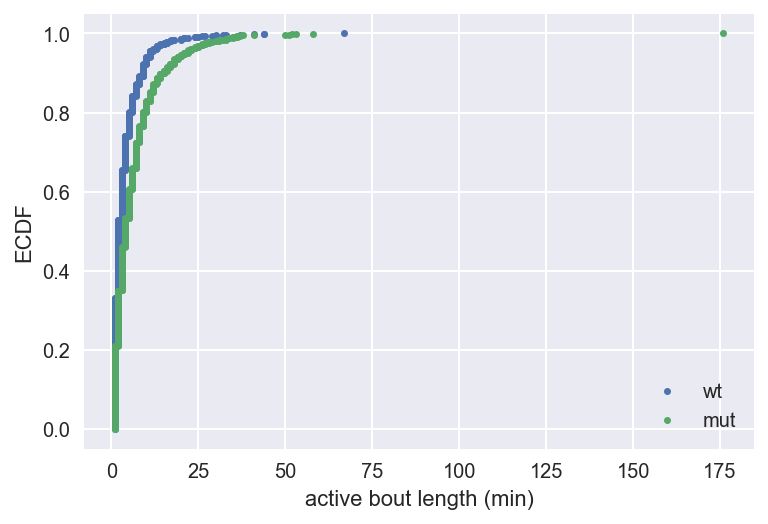
1 Daten mit freundlicher Genehmigung von Avni Gandhi, Grigorios Oikonomou und David Prober, Caltech
Optimaler Parameterwert
- Optimale Parameterwert: Der Wert des Parameters einer Wahrscheinlichkeitsverteilung, der die Daten am besten beschreibt
- Optimaler Parameter für die Exponentialverteilung: Aus dem Mittelwert der Daten berechnet
np.mean(nuclear_incident_times)
87.140350877192986
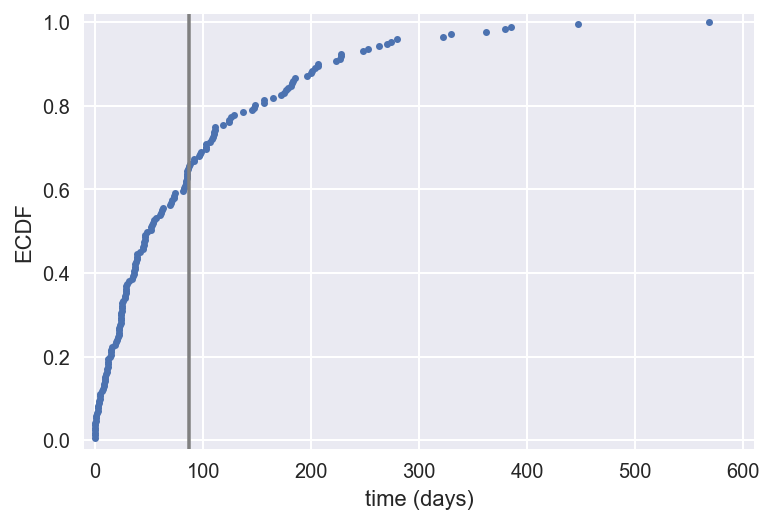
1 Datenquelle: Wheatley, Sovacool und Sornette, Nuclear Events Database
Bootstrap-Stichprobe
Ein neu gezogenes Array aus den Daten
# Resample nuclear_incident_times with replacement
bs_sample = np.random.choice(
  nuclear_incident_times,
  replace=True,
  size=len(inter_times)
)
Bootstrap-Replikate
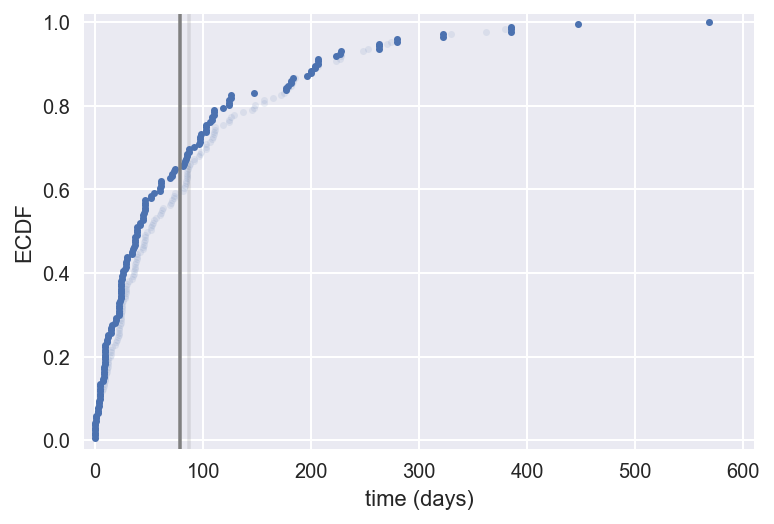
1 Datenquelle: Wheatley, Sovacool und Sornette, Nuclear Events Database
Bootstrap-Replikate
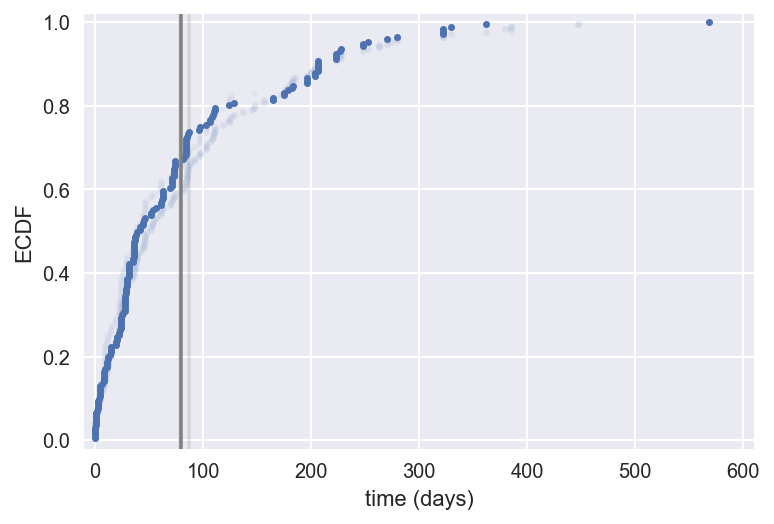
1 Datenquelle: Wheatley, Sovacool und Sornette, Nuclear Events Database
Bootstrap-Replikate
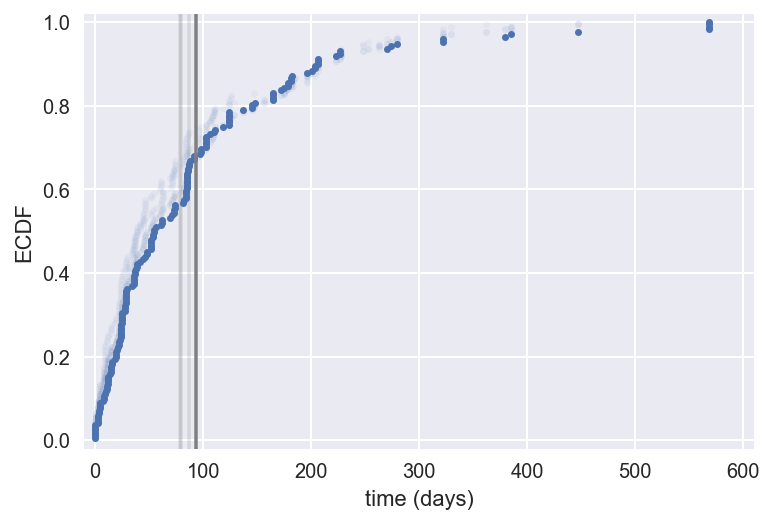
1 Datenquelle: Wheatley, Sovacool und Sornette, Nuclear Events Database
Bootstrap-Replikate
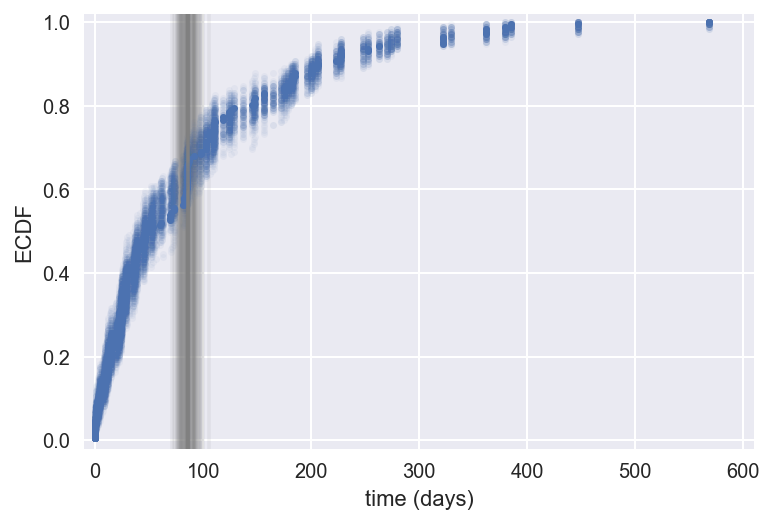
1 Datenquelle: Wheatley, Sovacool und Sornette, Nuclear Events Database
Bootstrap-Replikate
Bootstrap-Replikat: Eine aus einer Bootstrap-Stichprobe berechnete Statistik
dcst.draw_bs_reps()
Funktion zum Ziehen von Bootstrap-Replikaten aus einem Datensatz
# Draw 10000 replicates of the mean from
# nuclear_incident_times
bs_reps = dcst.draw_bs_reps(
  nuclear_incident_times, np.mean, size=10000
)
Das Bootstrap-Konfidenzintervall
1 Datenquelle: Wheatley, Sovacool und Sornette, Nuclear Events Database
Das Bootstrap-Konfidenzintervall
Wenn wir Messungen immer wiederholten, lägen p % der beobachteten Werte innerhalb des p %-Konfidenzintervalls
Das Bootstrap-Konfidenzintervall
np.percentile(bs_reps, [2.5, 97.5])
array([ 73.31505848, 102.39181287])

