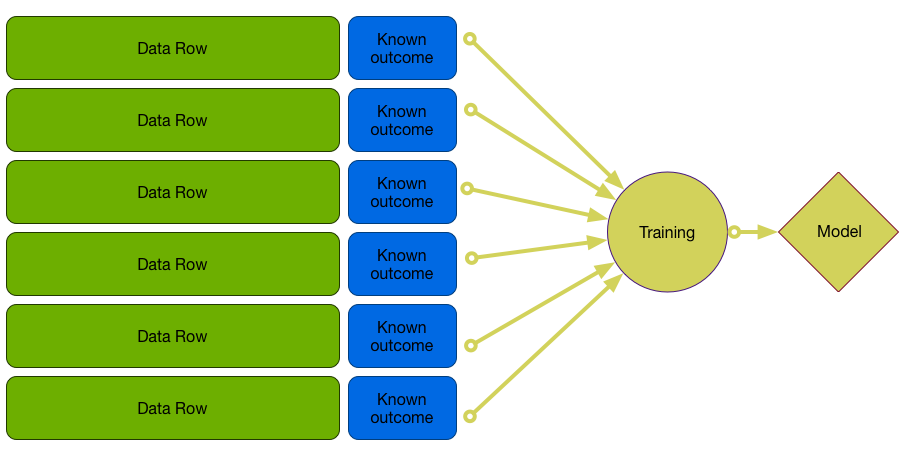
Treinando um Modelo da Maneira Certa
Aprendizado Supervisionado em R: Regressão

Nina Zumel and John Mount
Win-Vector, LLC
Modelos podem ir muito melhor no treino do que em dados futuros.
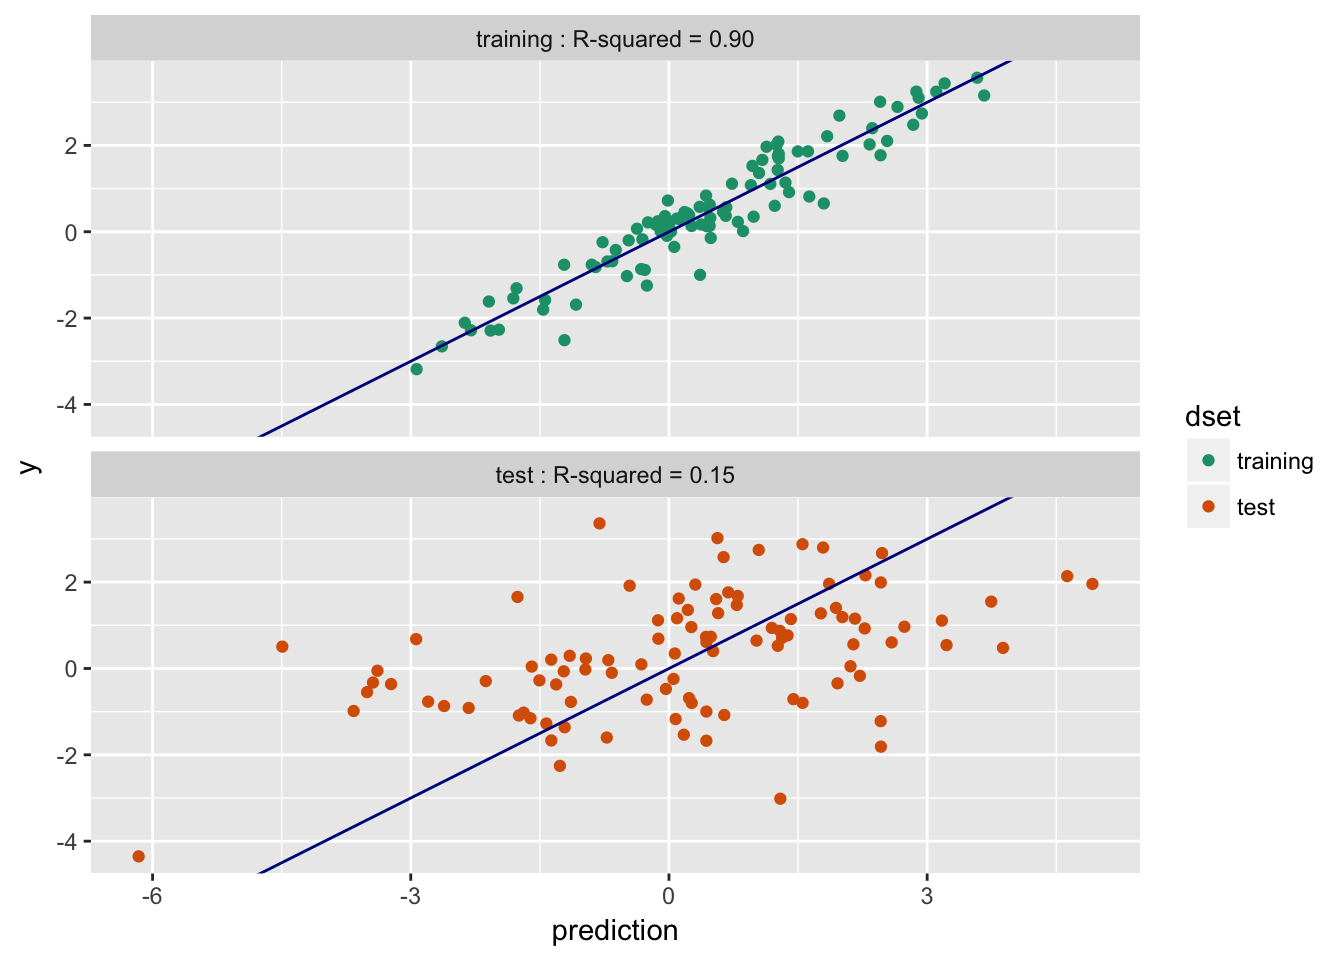
- $R^2$ treino: 0,9; $R^2$ teste: 0,15 — Overfit
Divisão Treino/Teste
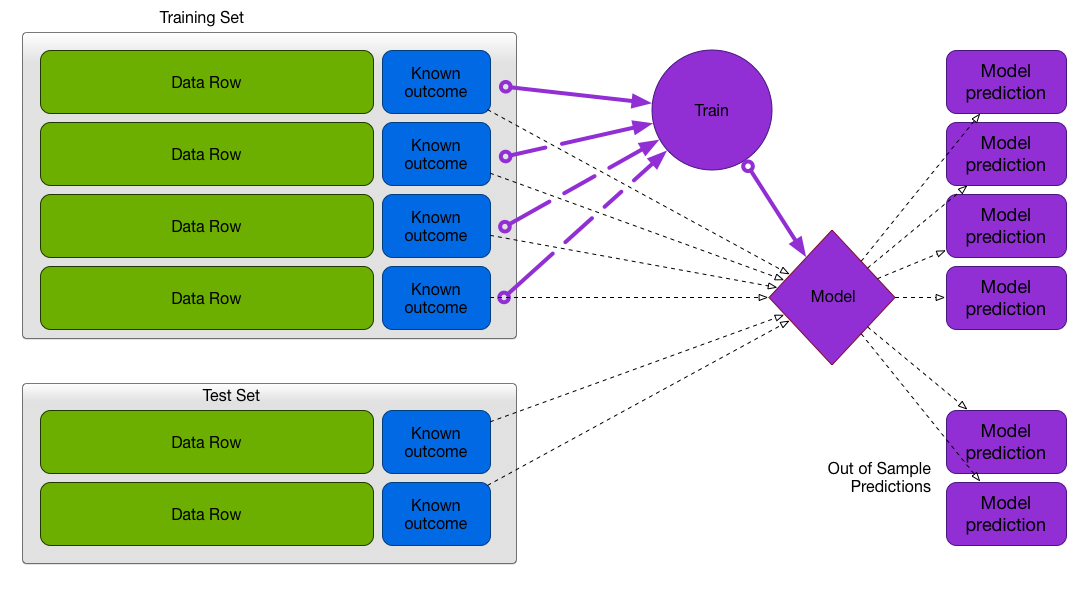
Método recomendado quando há muitos dados
Exemplo: Modelar Desemprego Feminino
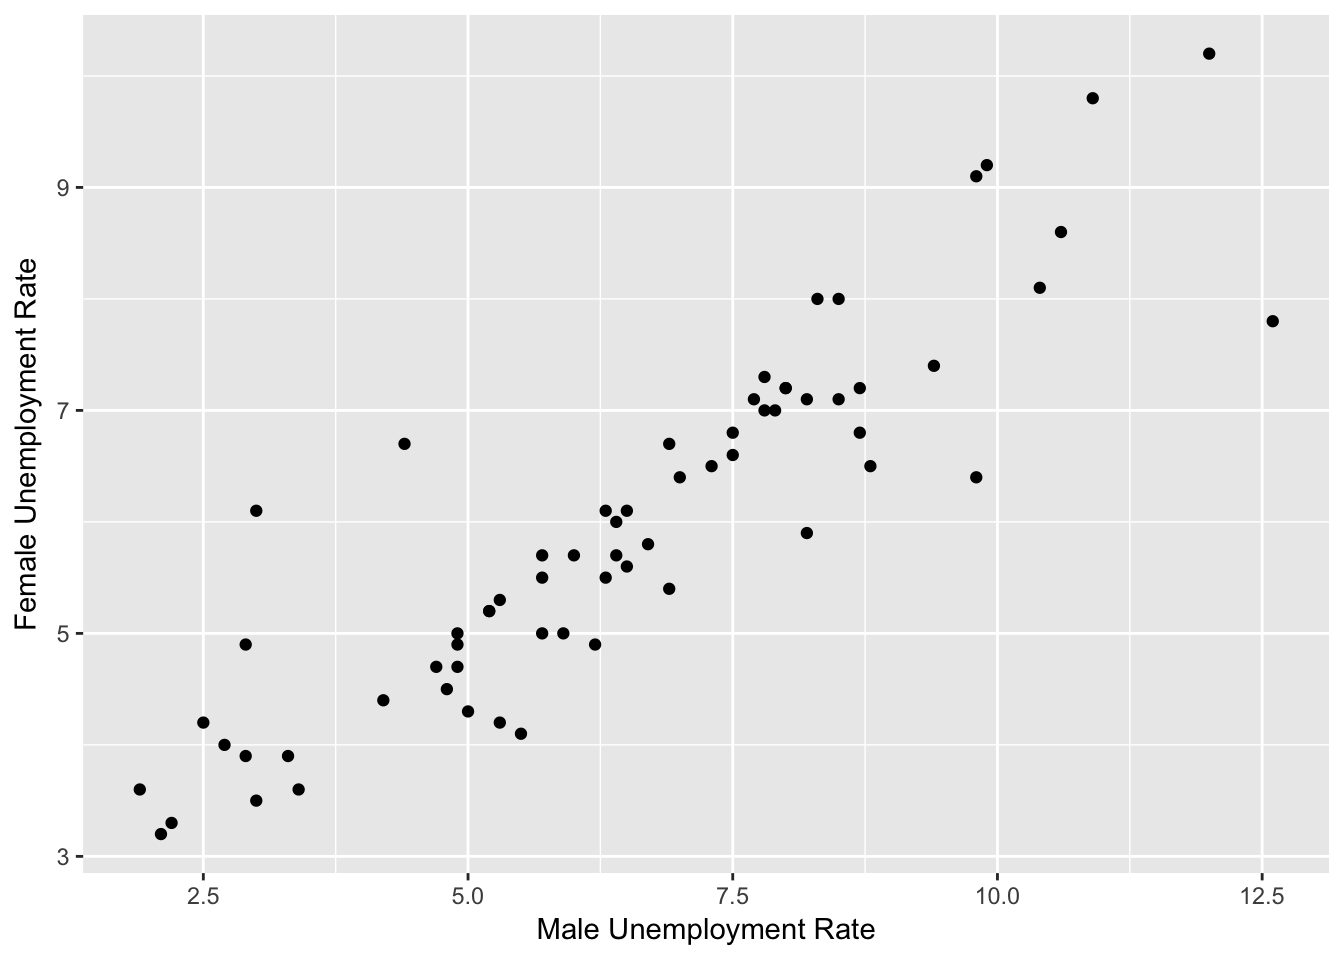
- Treine em 66 linhas e teste em 30
Desempenho do Modelo: Treino vs. Teste
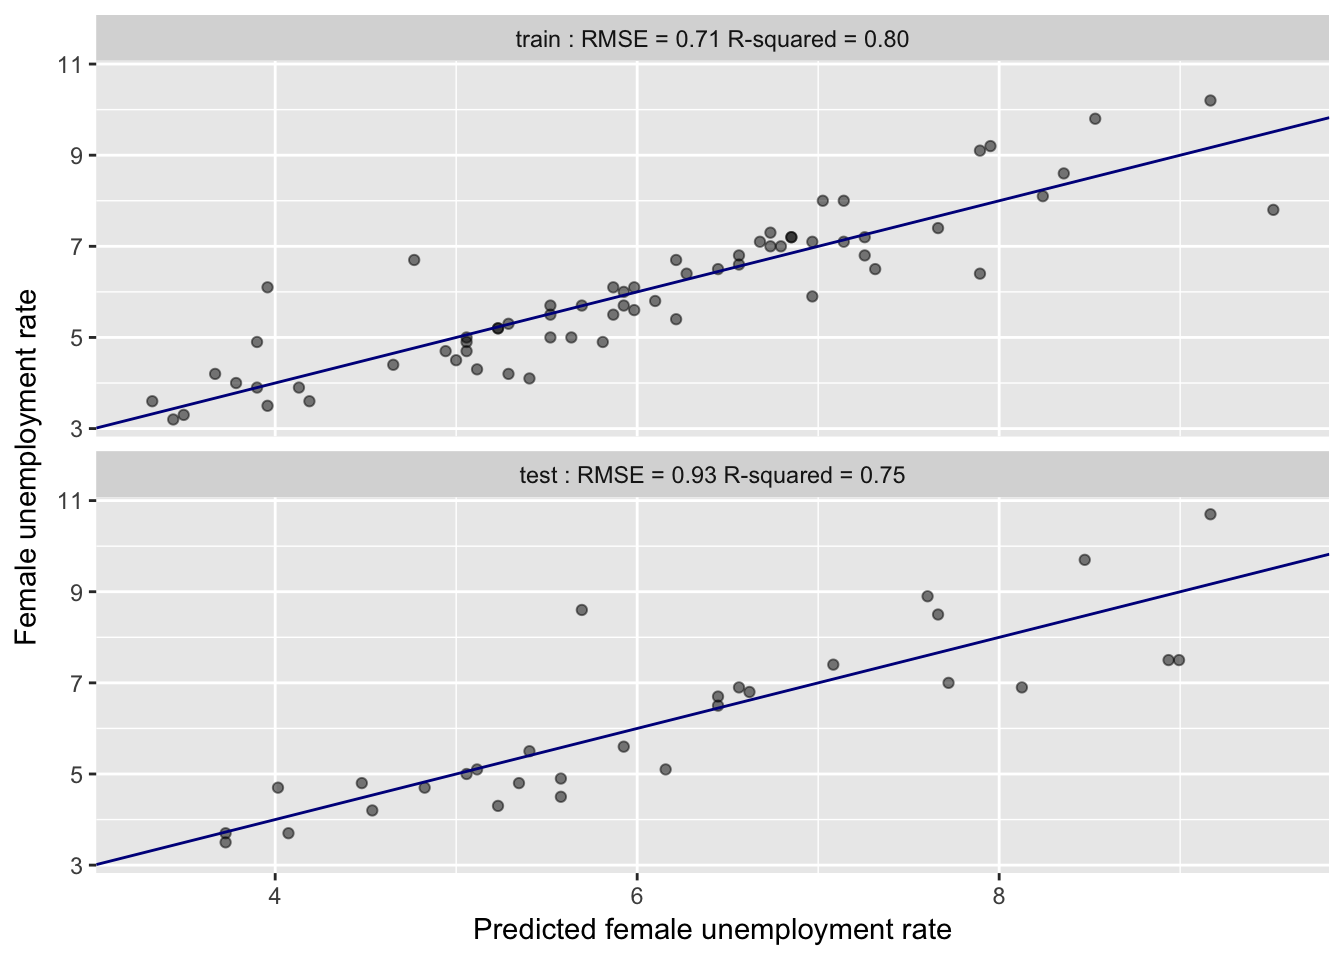
- Treino: RMSE 0,71, $R^2$ 0,8
- Teste: RMSE 0,93, $R^2$ 0,75
Validação Cruzada
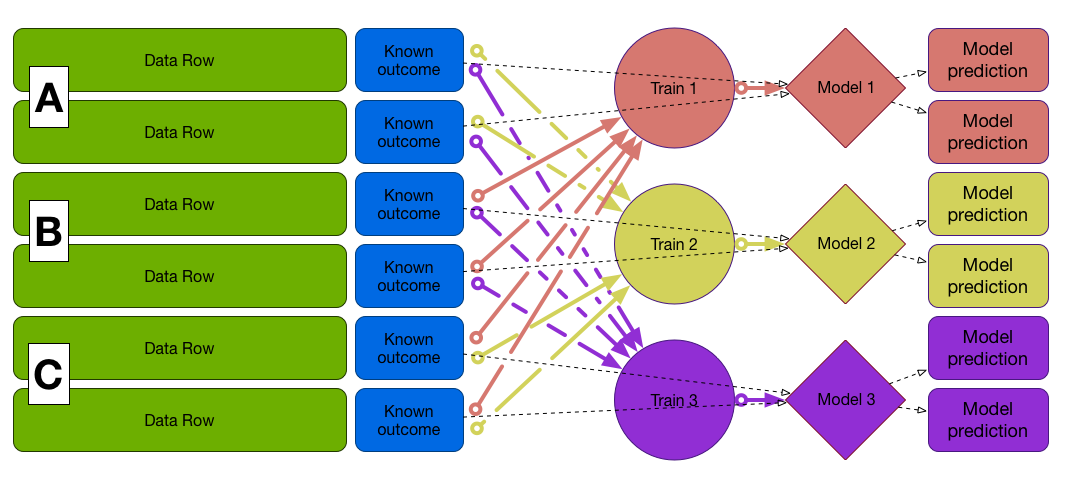
Preferível quando os dados não são grandes o suficiente para separar um conjunto de teste
Validação Cruzada
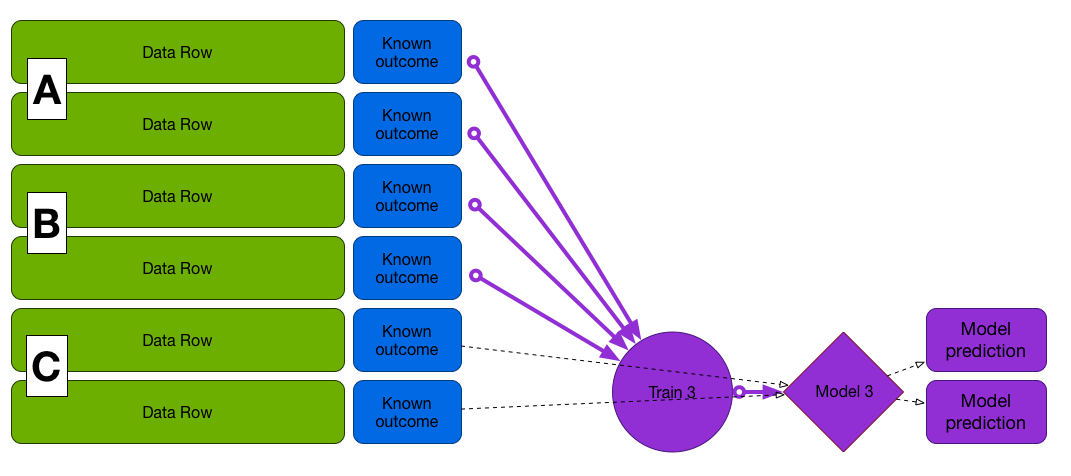
Validação Cruzada
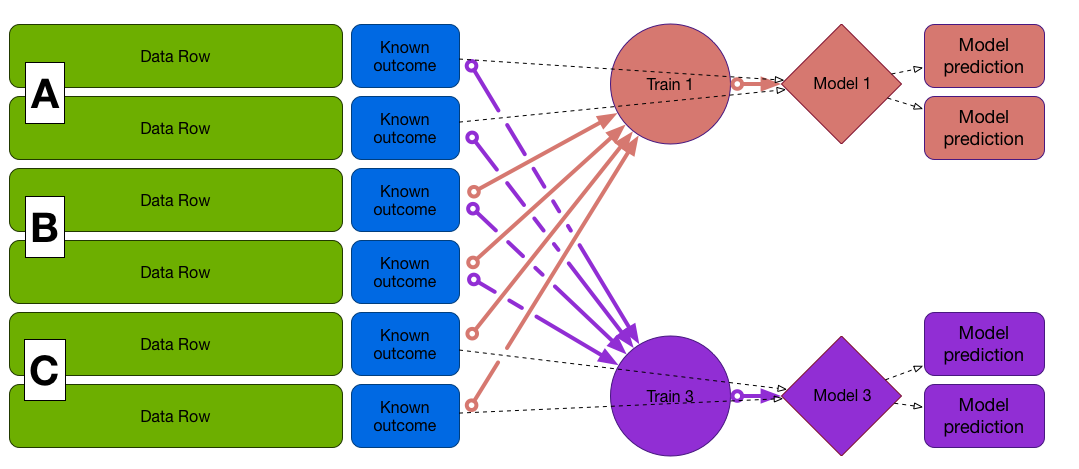
Validação Cruzada
Modelo Final