AI optimaliseren voor snelheid, kosten en kwaliteit
AI-ondersteund coderen voor developers
Francesca Donadoni
AI Curriculum Manager, DataCamp
Metrieken
Latency
(responstijd): hoe lang het model nodig heeft om te antwoorden
Metrieken
Latency
(responstijd): hoe lang het model nodig heeft om te antwoorden
$$
Tokencosten
(per 1M tokens): geldelijke kosten van het gebruik van een AI‑model
Metrieken
Latency
(responstijd): hoe lang het model nodig heeft om te antwoorden
$$
Tokencosten
(per 1M tokens): geldelijke kosten van het gebruik van een AI‑model
$$
Kwaliteit
(slagingspercentage bij tests/dekking): hoe vaak de gegenereerde code werkt zoals bedoeld
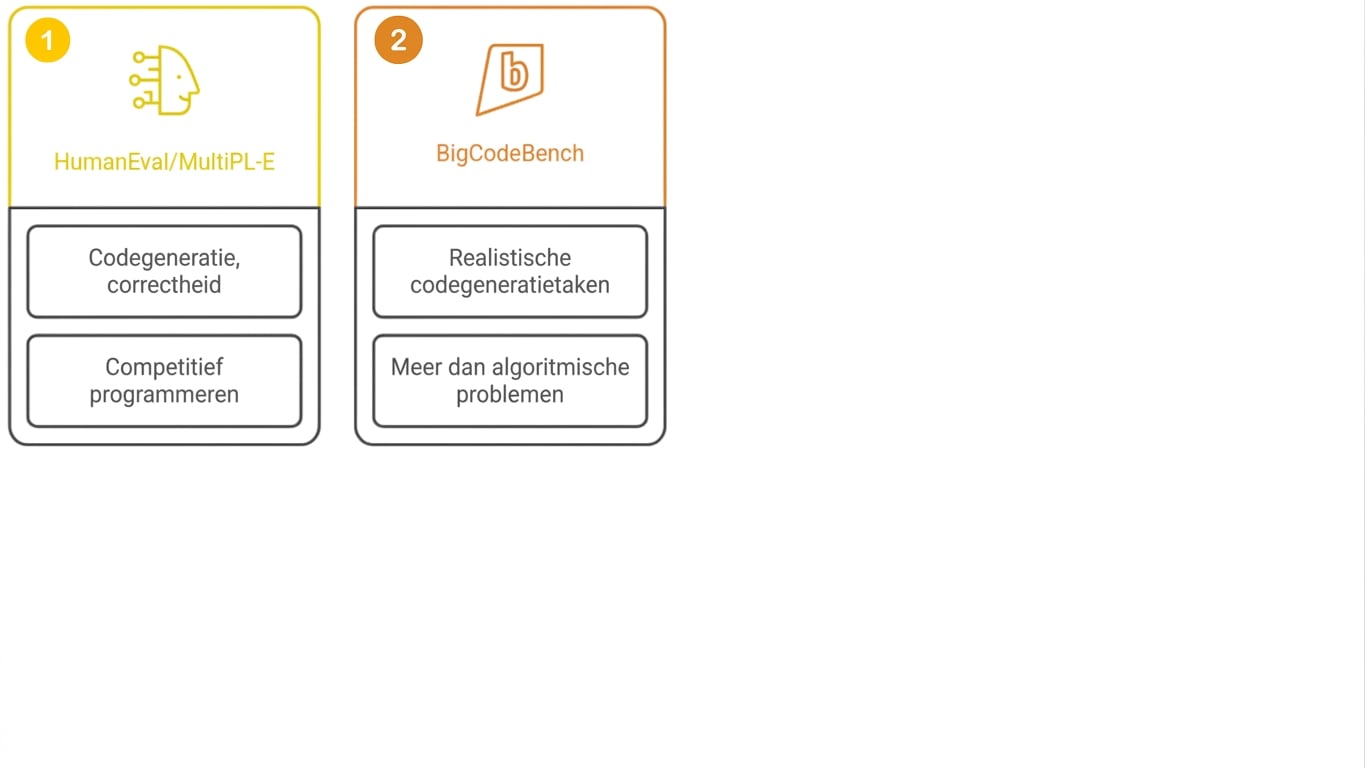
Modelbenchmarking
$$
1
https://github.com/openai/human-eval
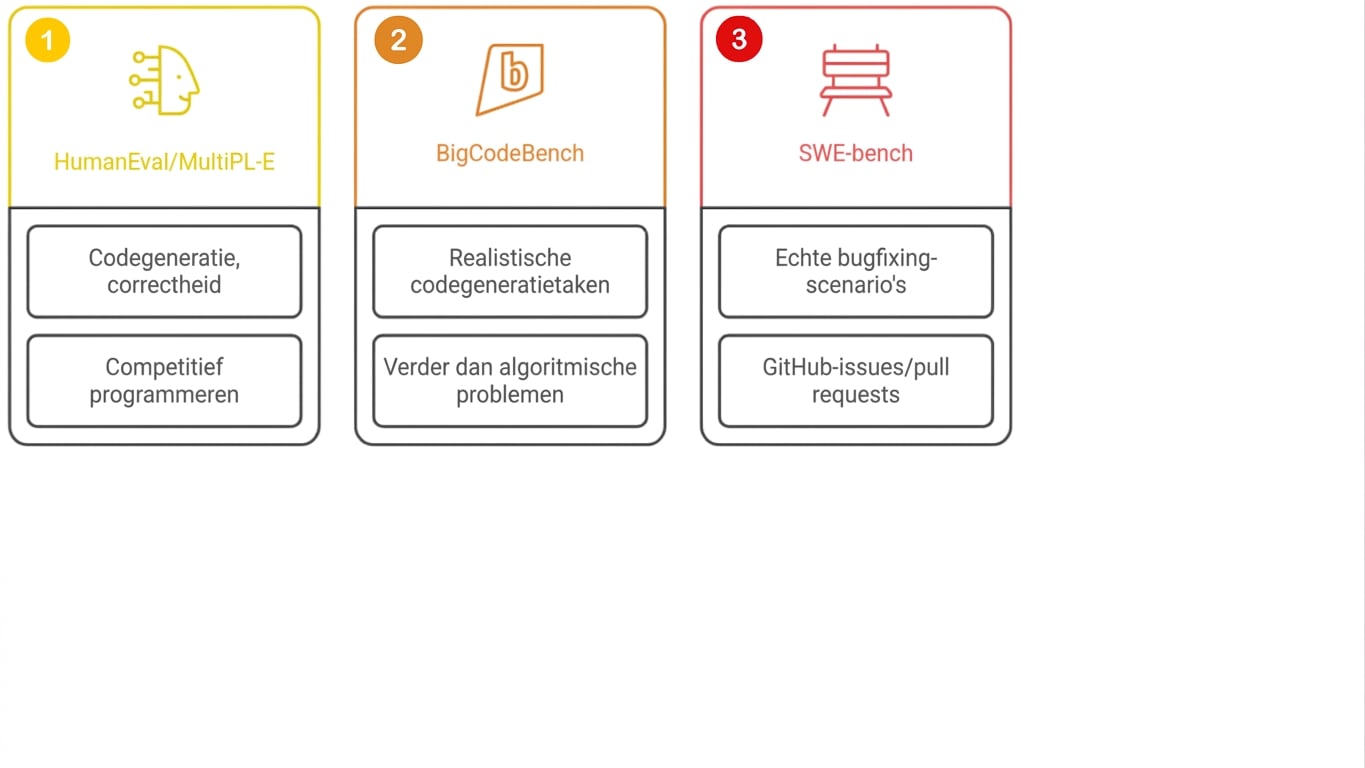
Modelbenchmarking
$$
1
https://github.com/bigcode-project/bigcodebench
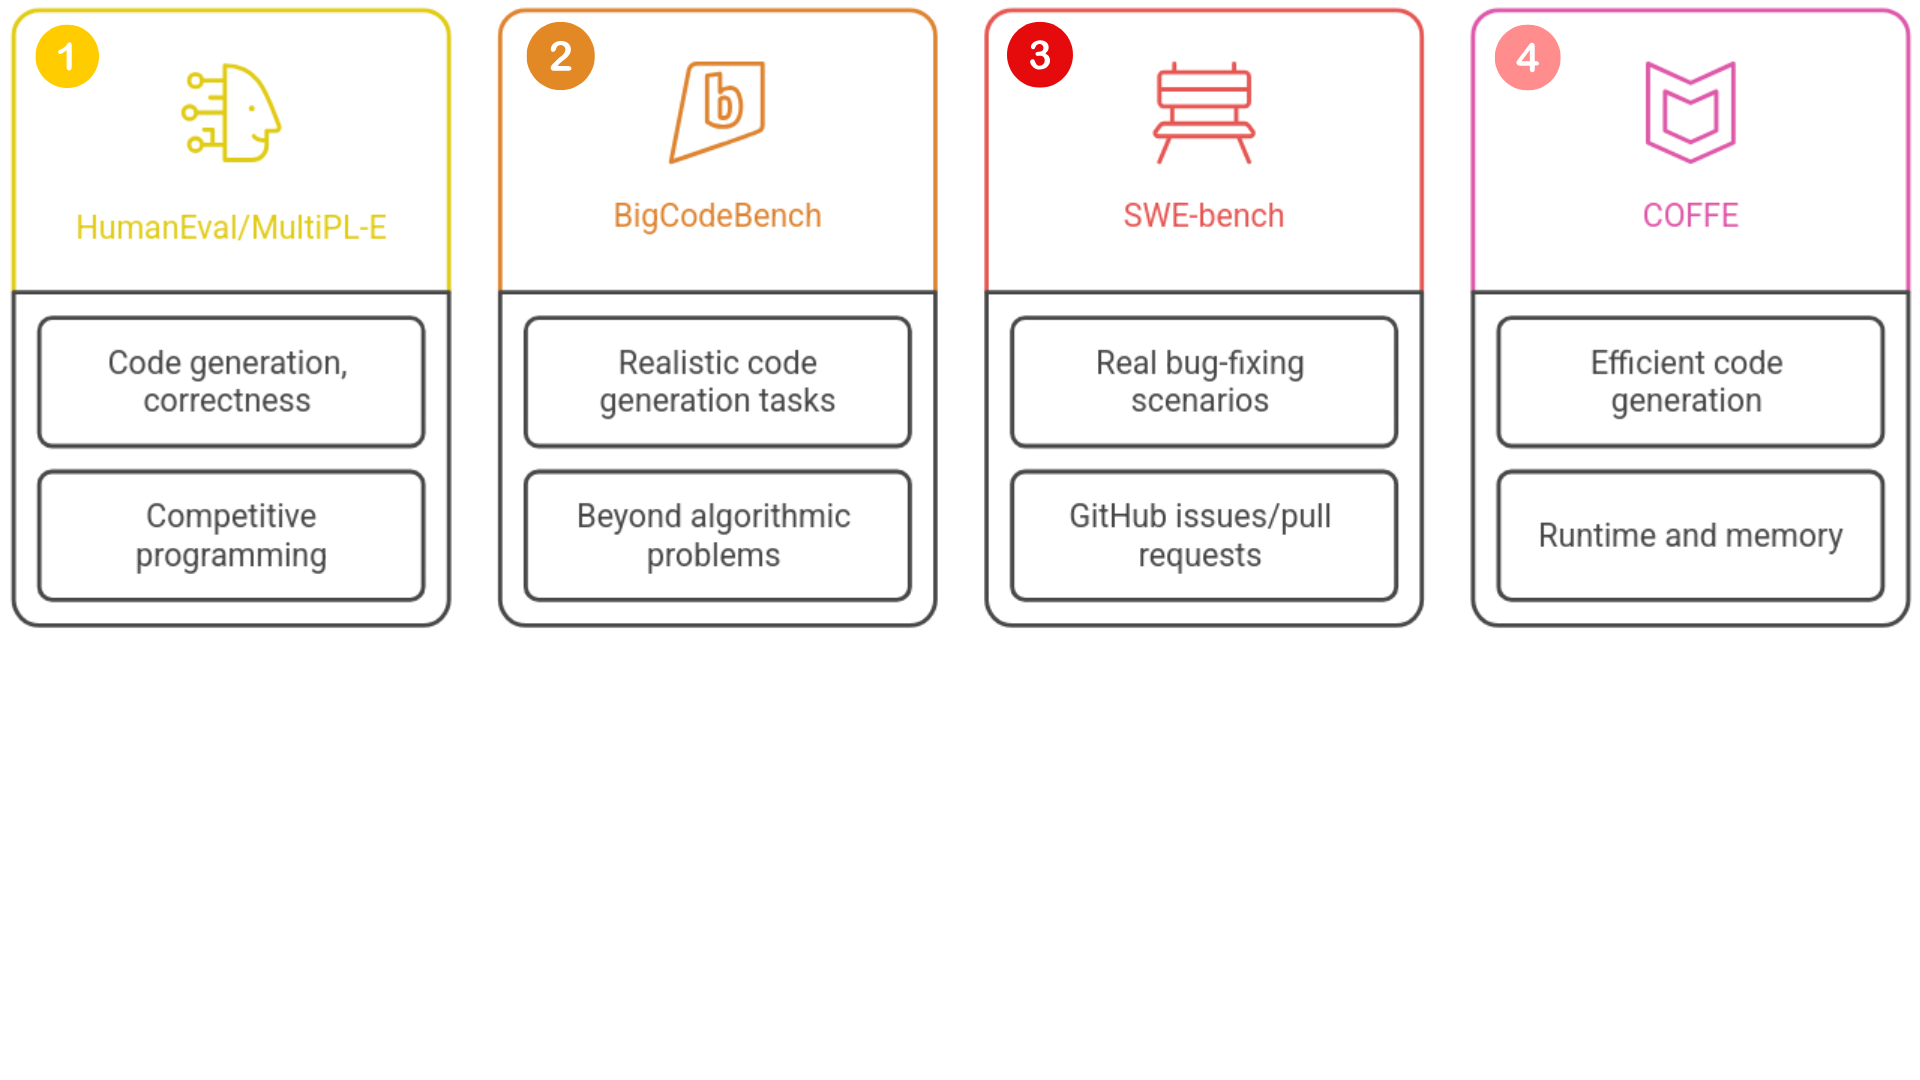
Modelbenchmarking
$$
1
https://github.com/SWE-bench/SWE-bench
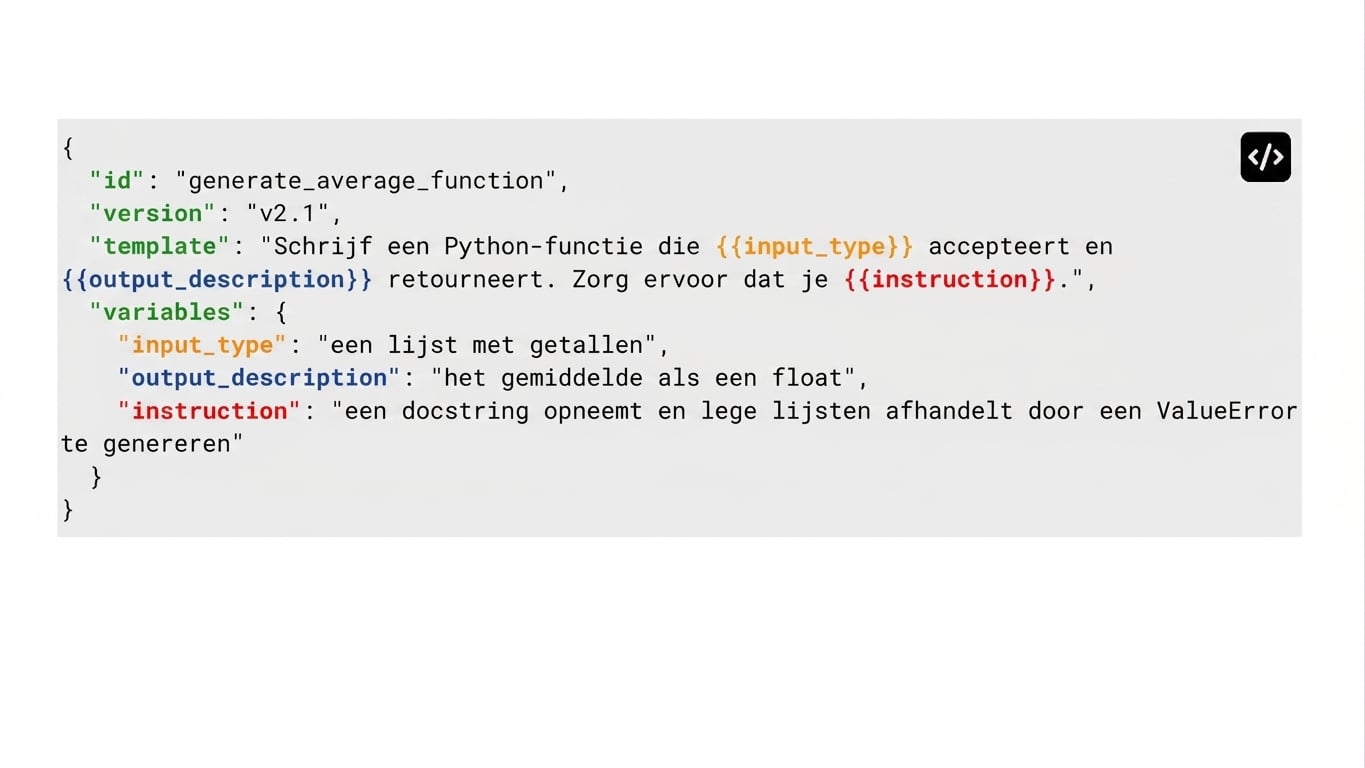
Modelbenchmarking
$$
1
https://github.com/JohnnyPeng18/Coffe
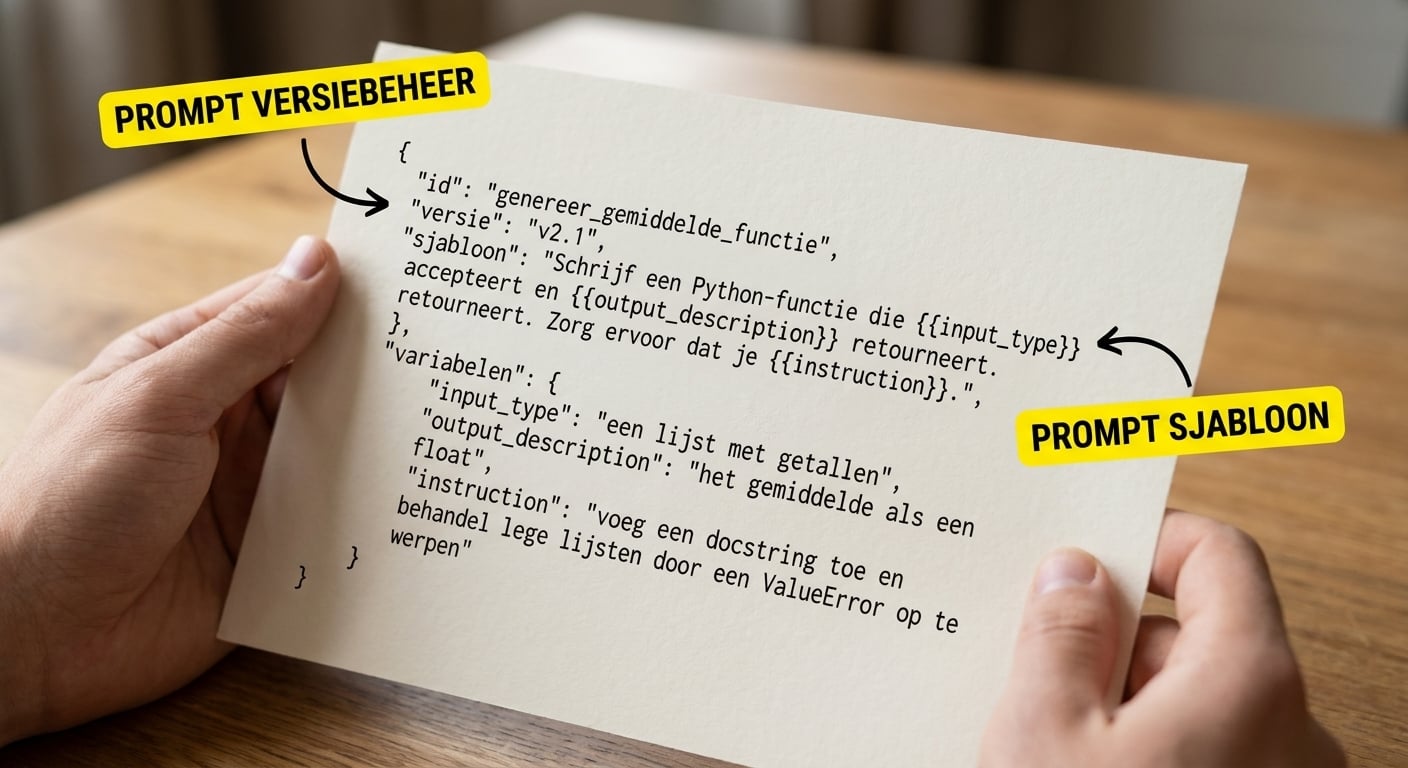
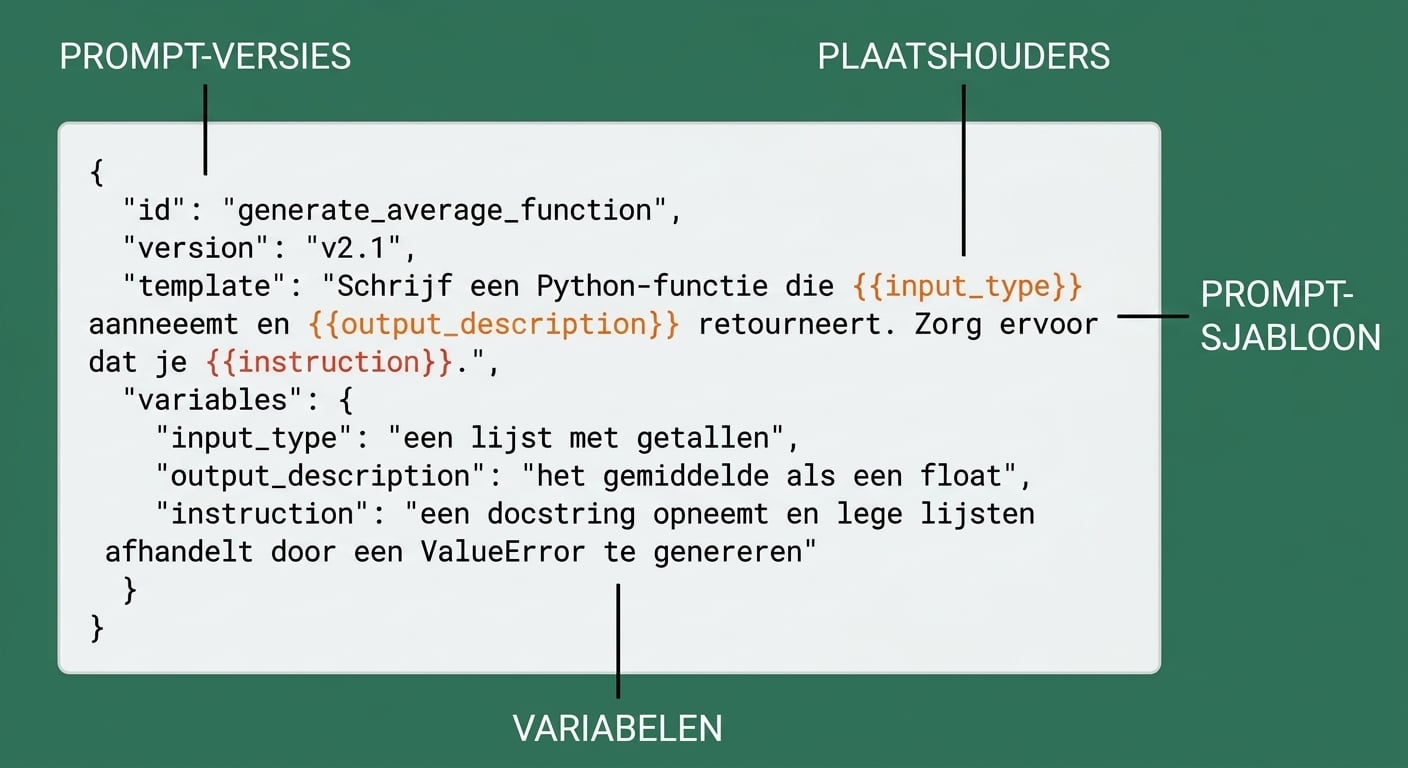
Versiebeheer voor prompts
Promptcaching
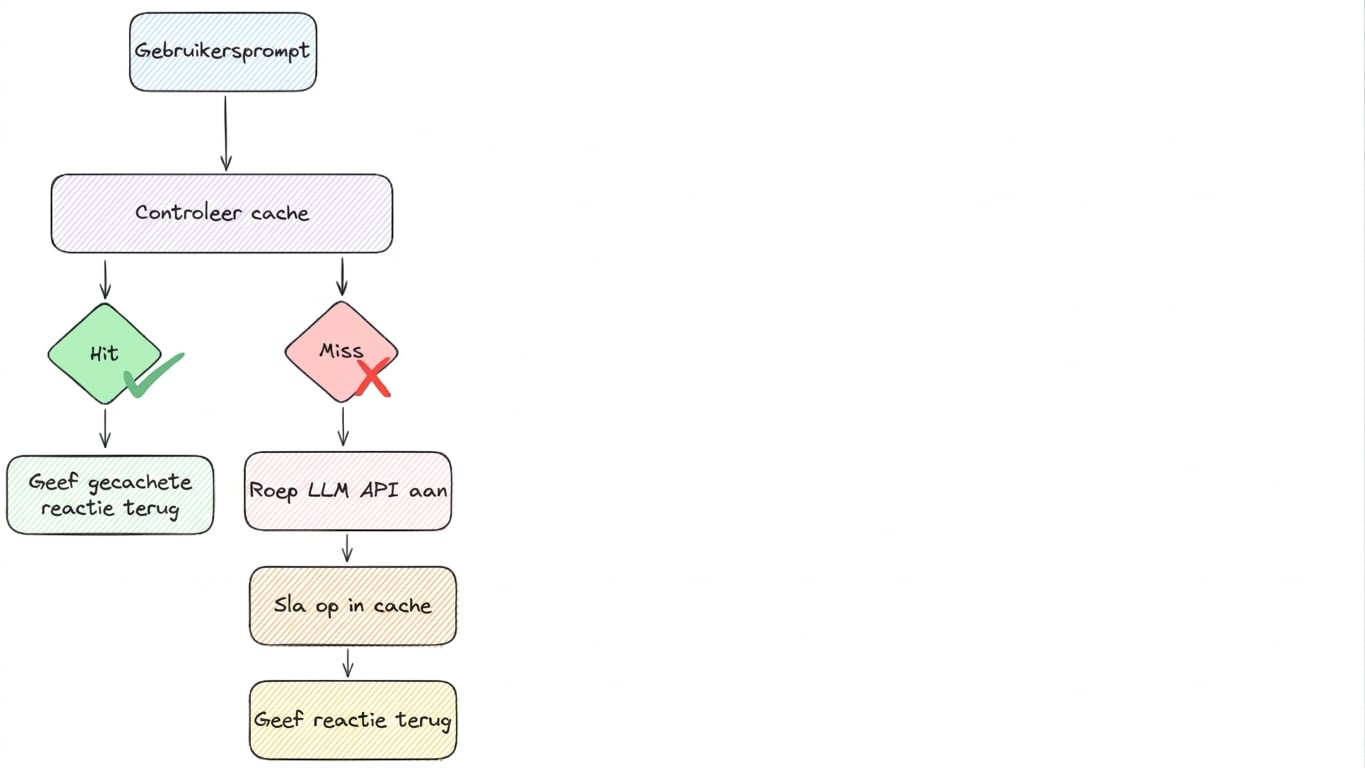
Caching werkt door het opslaan van:
Prompt
Invoer
Model
Temperatuur
Laten we oefenen!
AI-ondersteund coderen voor developers
Preparing Video For Download...