Generare e confrontare coppie

Pulizia dei dati in R

Maggie Matsui

Content Developer @ DataCamp

Quando le join non bastano
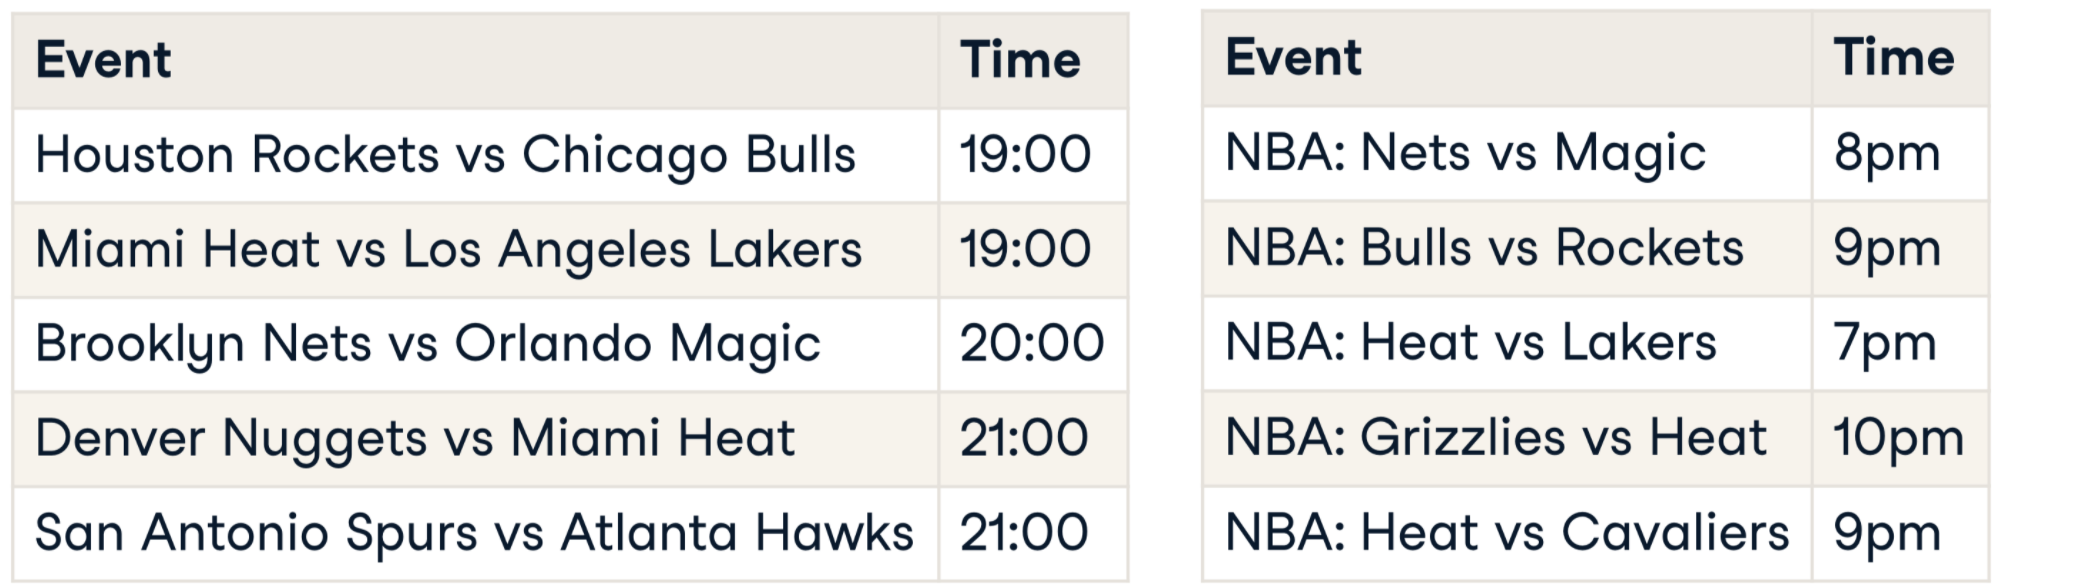
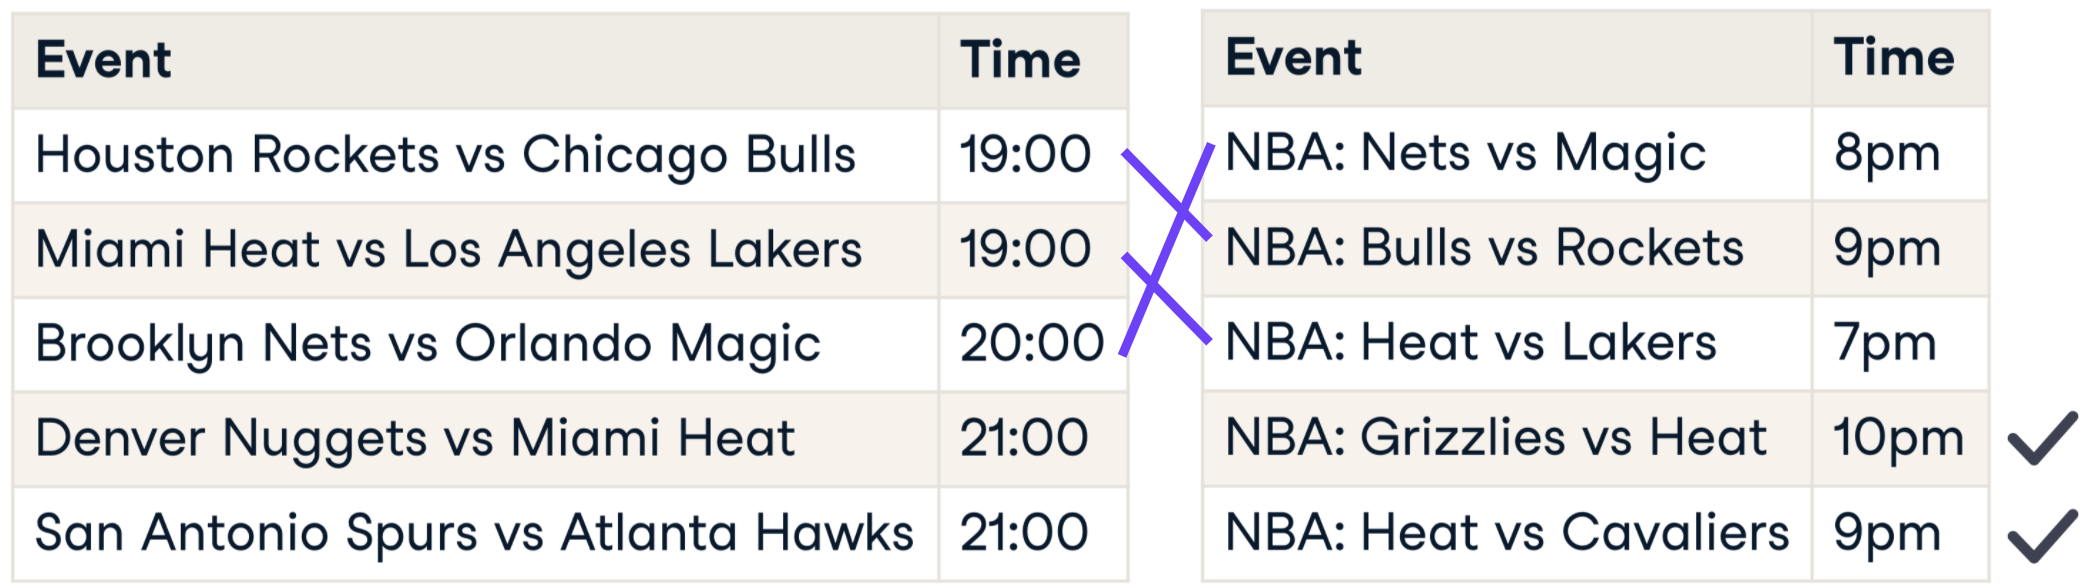
La tabella a sinistra ha colonne evento e ora. Partite mostrate: Houston Rockets vs Chicago Bulls alle 19:00. Miami Heat vs Los Angeles Lakers alle 19:00. Brooklyn Nets vs Orlando Magic alle 20:00. Denver Nuggets vs. Miami Heat alle 21:00. San Antonio Spurs vs Atlanta Hawks alle 21:00. La tabella a destra ha: NBA: Nets vs Magic alle 8pm. NBA: Bulls vs Rockets alle 9pm. NBA: Heat vs Lakers alle 7pm. NBA: Grizzlies vs Heat alle 10pm. NBA: Heat vs Cavaliers alle 9pm.

Pulizia dei dati in R

Quando le join non bastano

Pulizia dei dati in R

Cos'è il record linkage?

record_linkage_1.png

Pulizia dei dati in R

Cos'è il record linkage?

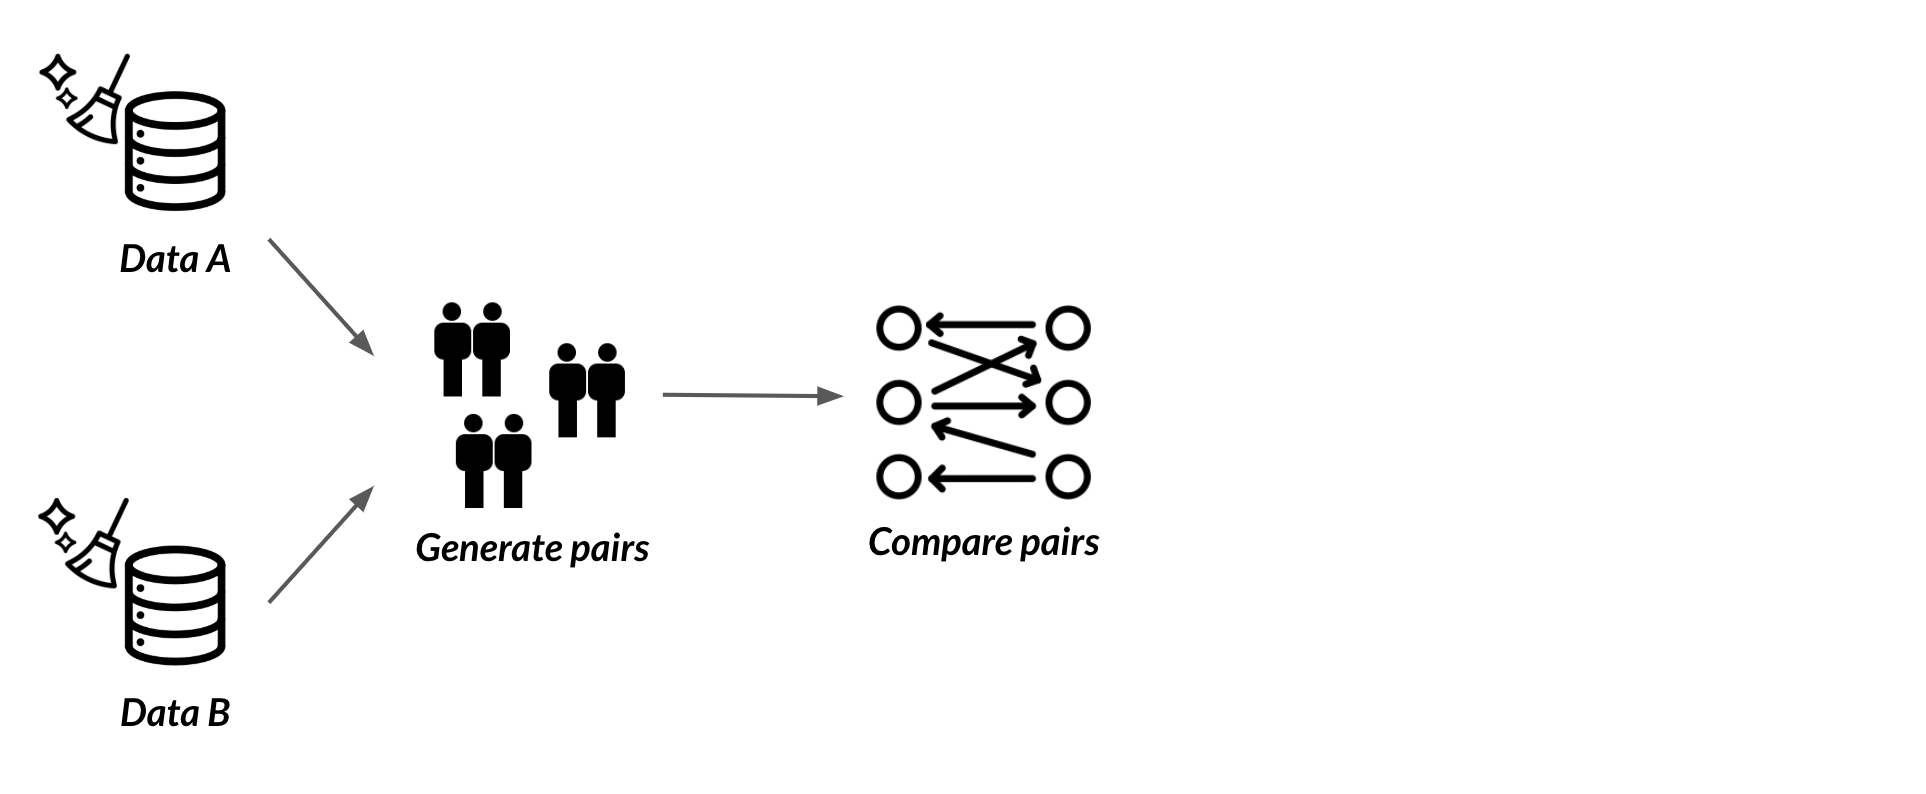
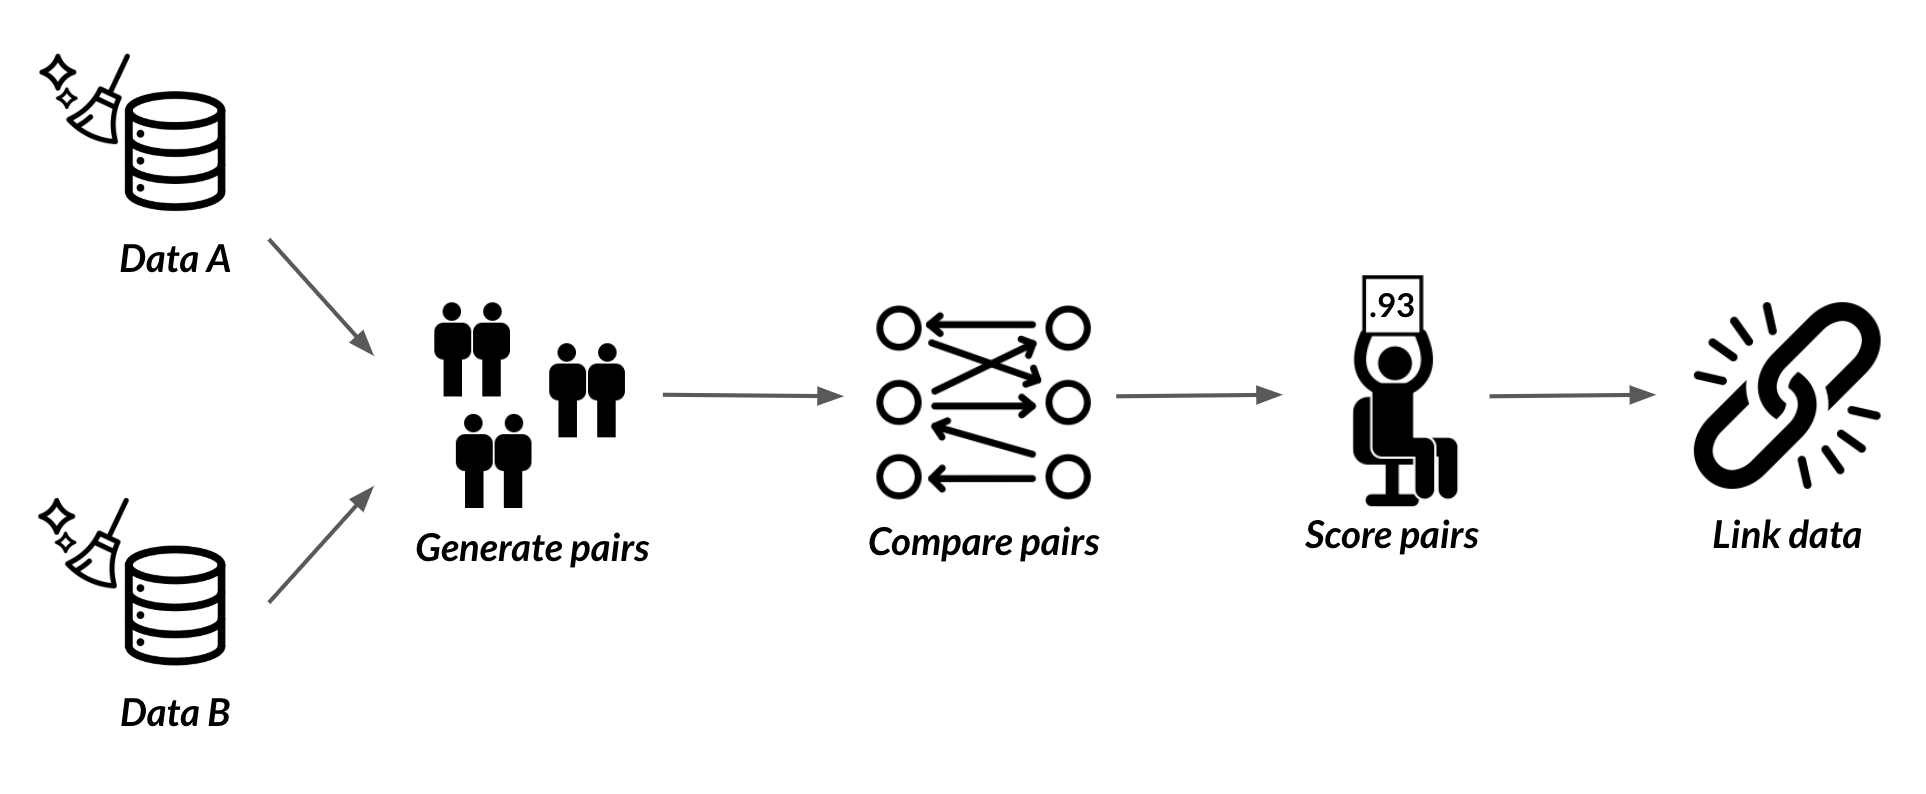
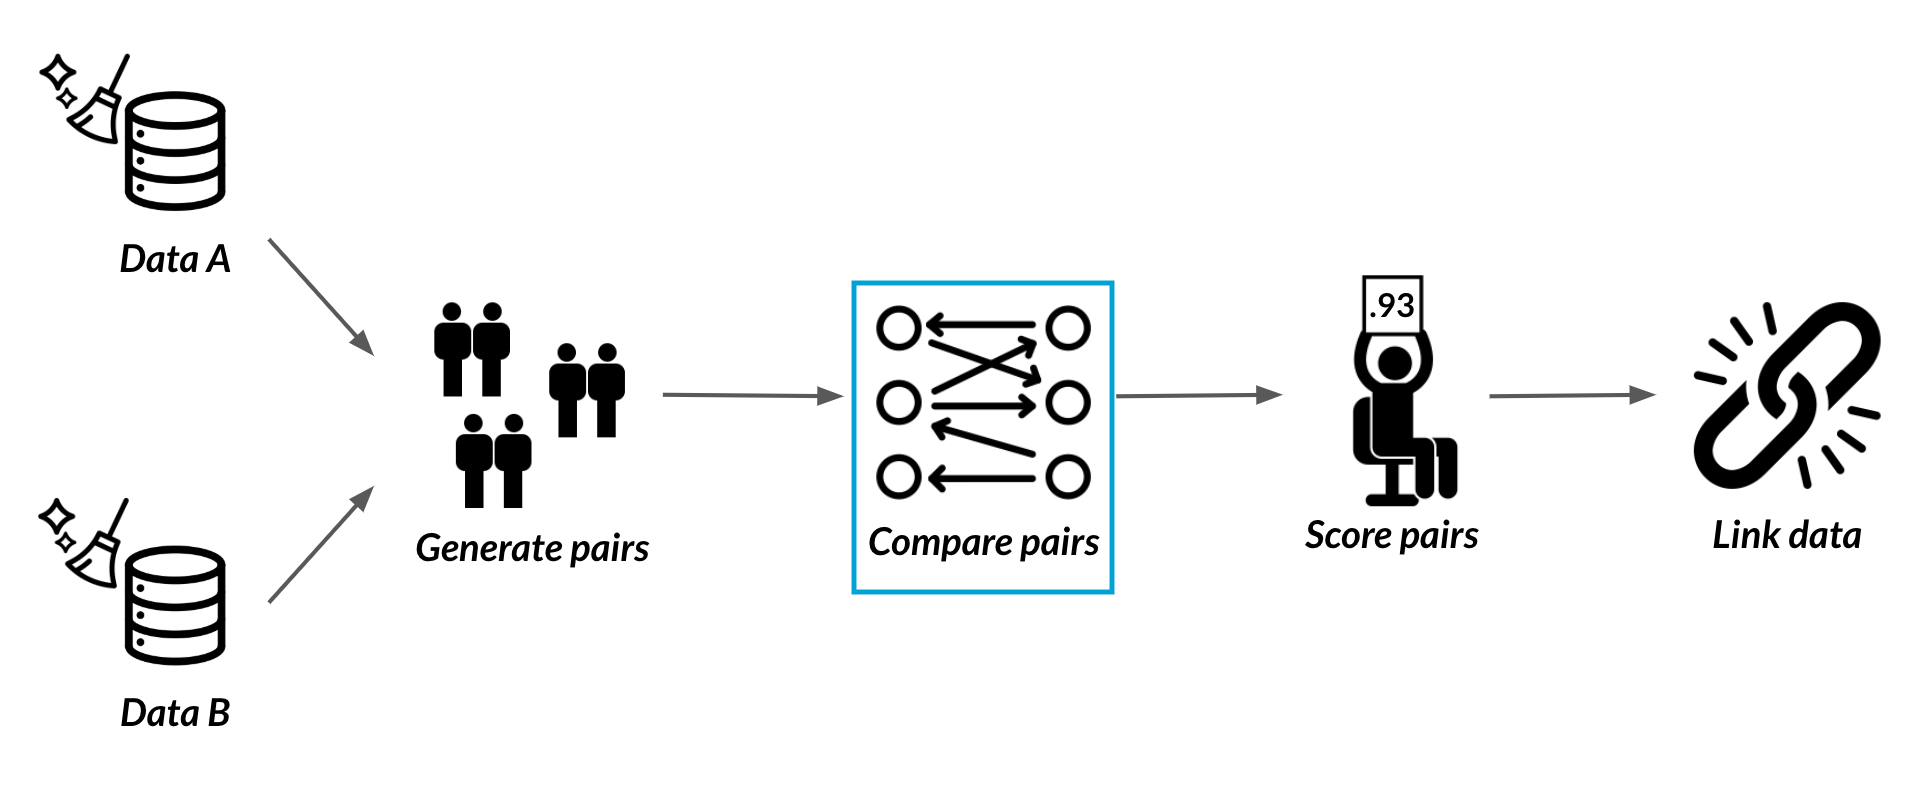
A sinistra, due database con scope, etichettati Data A e Data B

Pulizia dei dati in R

Cos'è il record linkage?

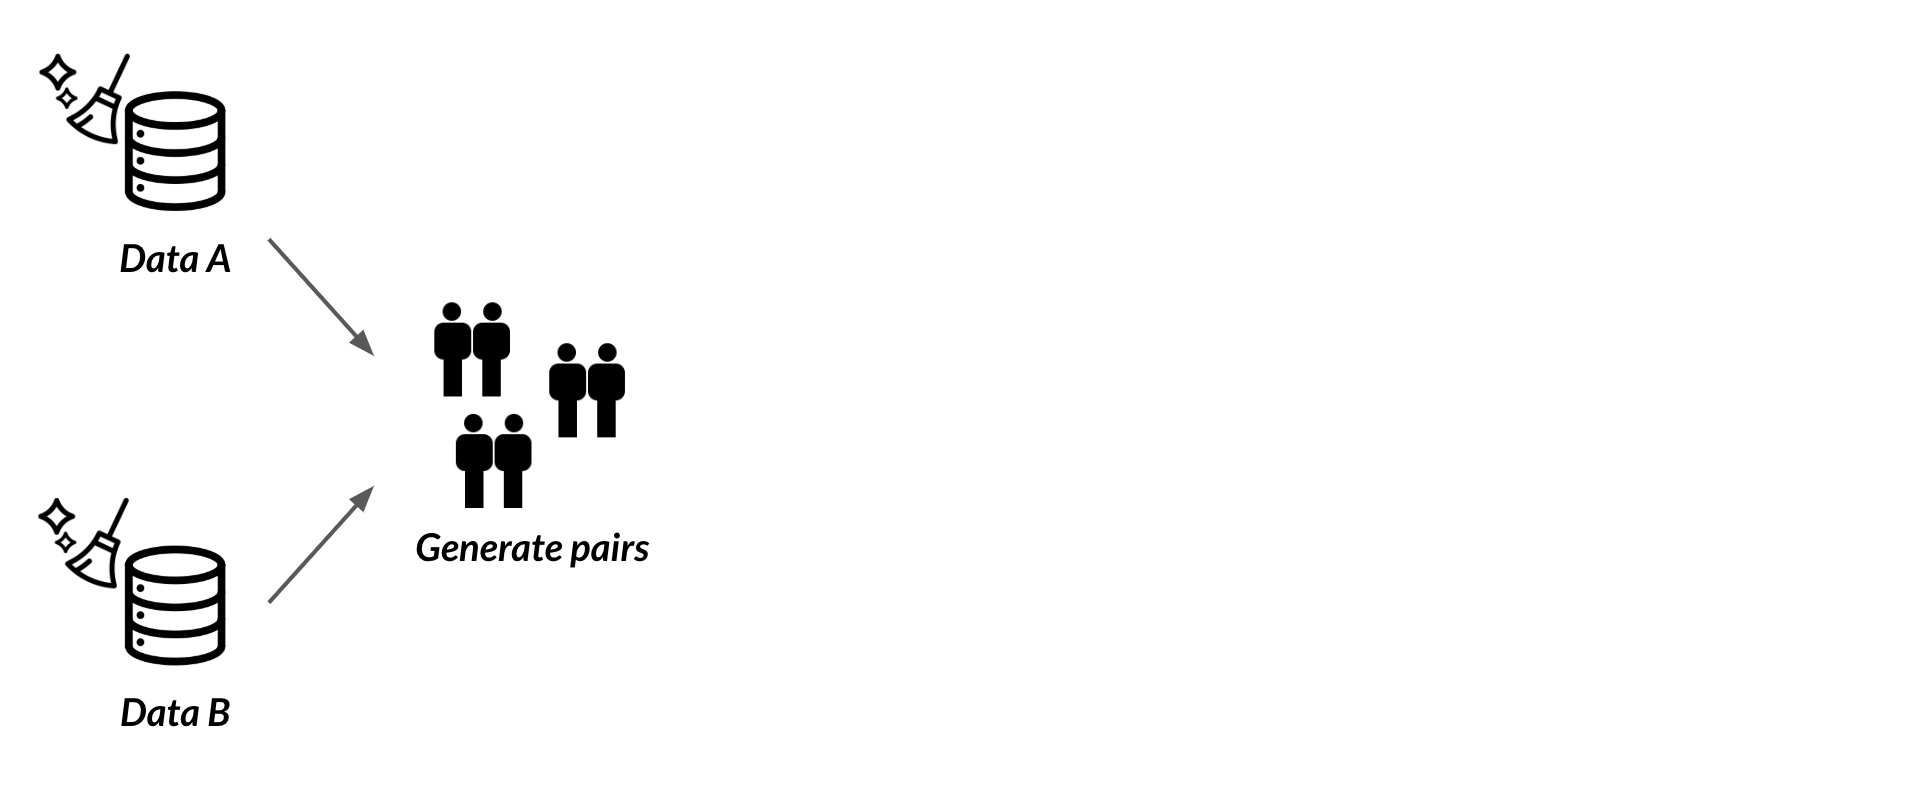
Frecce da Data A e Data B a tre coppie di persone, etichetta Genera coppie

Pulizia dei dati in R

Cos'è il record linkage?

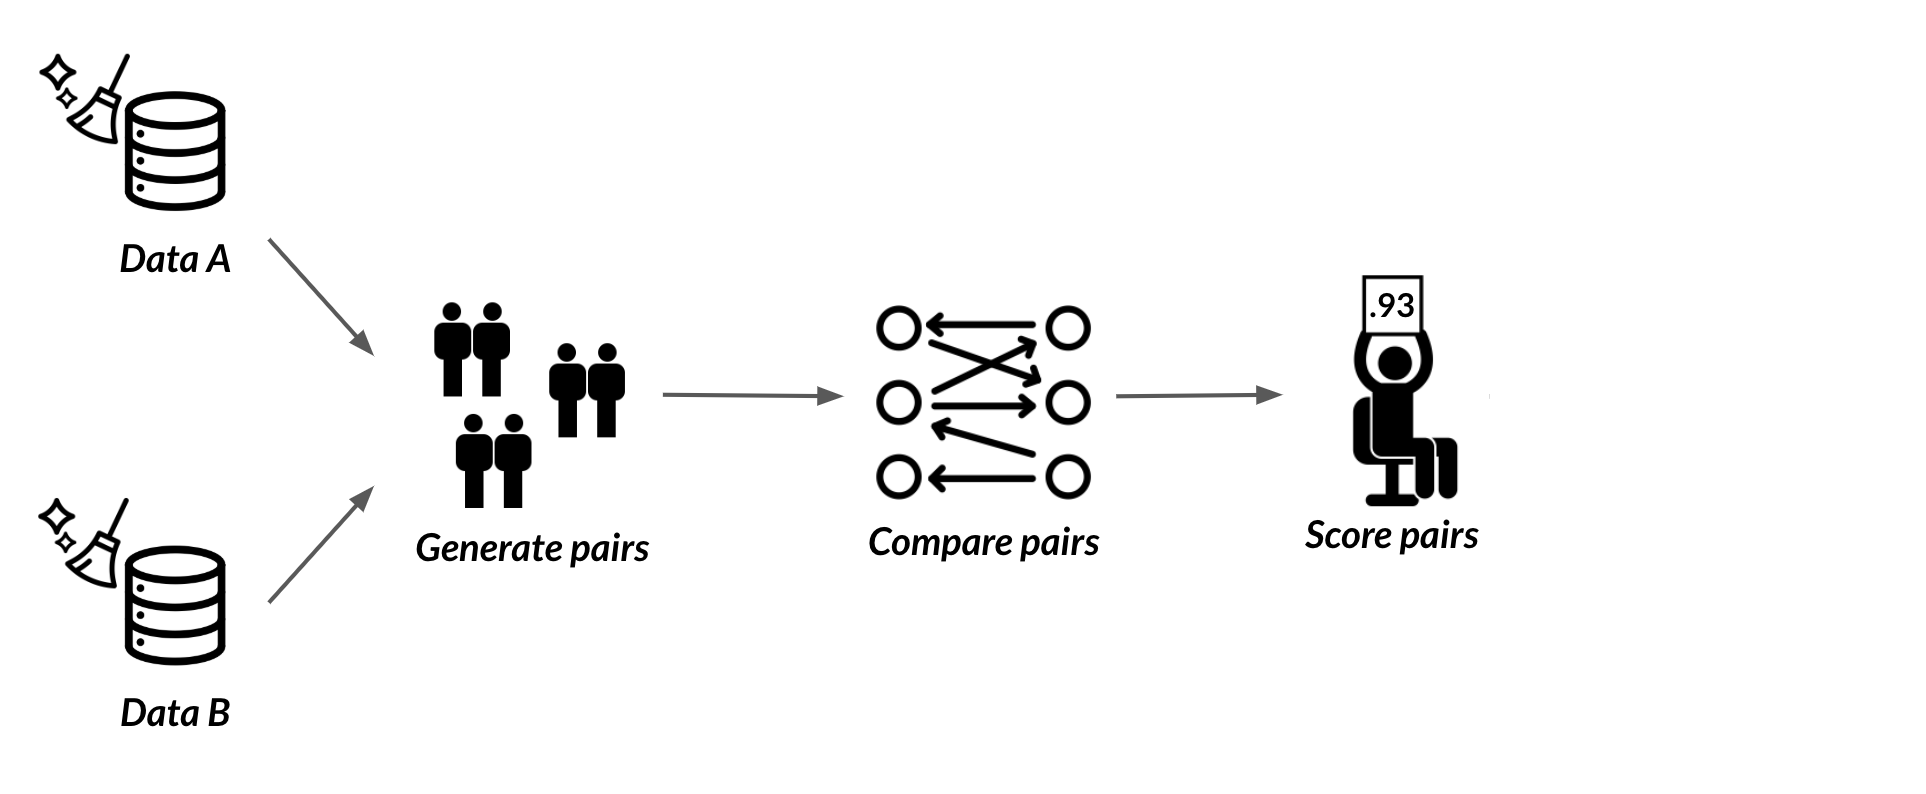
Una freccia da genera coppie a due colonne di cerchi con frecce che si puntano in varie direzioni. Descrizione: confronta coppie.

Pulizia dei dati in R

Cos'è il record linkage?

Freccia da confronta coppie a una figura che tiene un cartello con .93. Etichetta: assegna punteggi.

Pulizia dei dati in R

Cos'è il record linkage?

Freccia da assegna punteggi a una catena, etichetta collega dati.

Pulizia dei dati in R

Cos'è il record linkage?

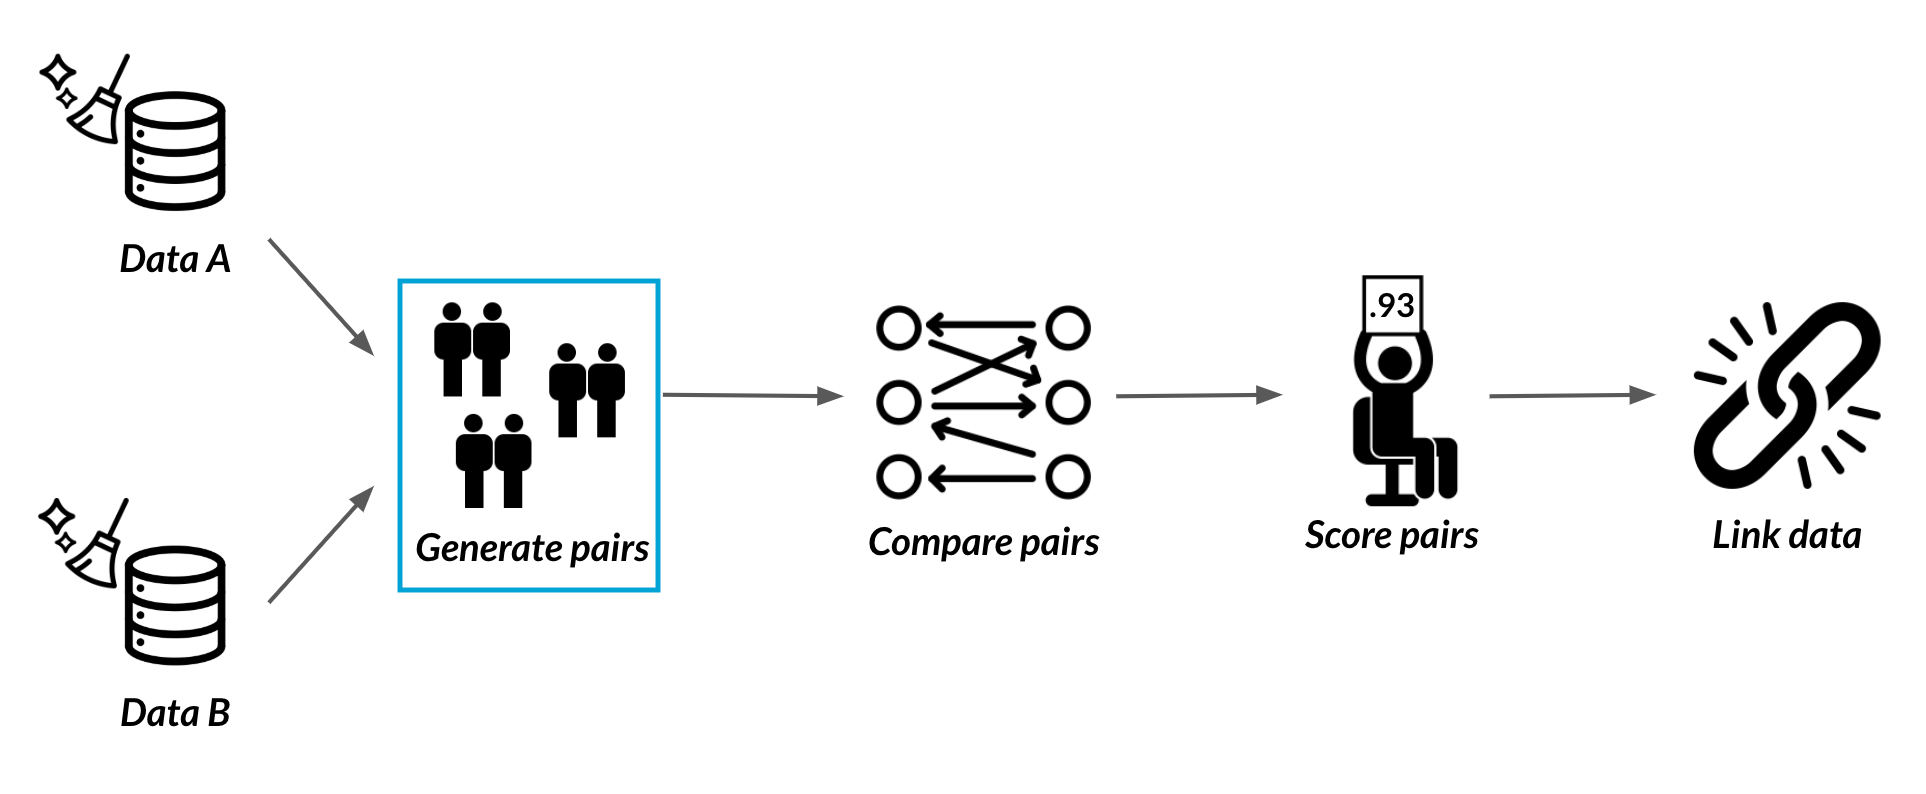
Stesso diagramma con un riquadro blu attorno al passo genera coppie

Pulizia dei dati in R

Coppie di record

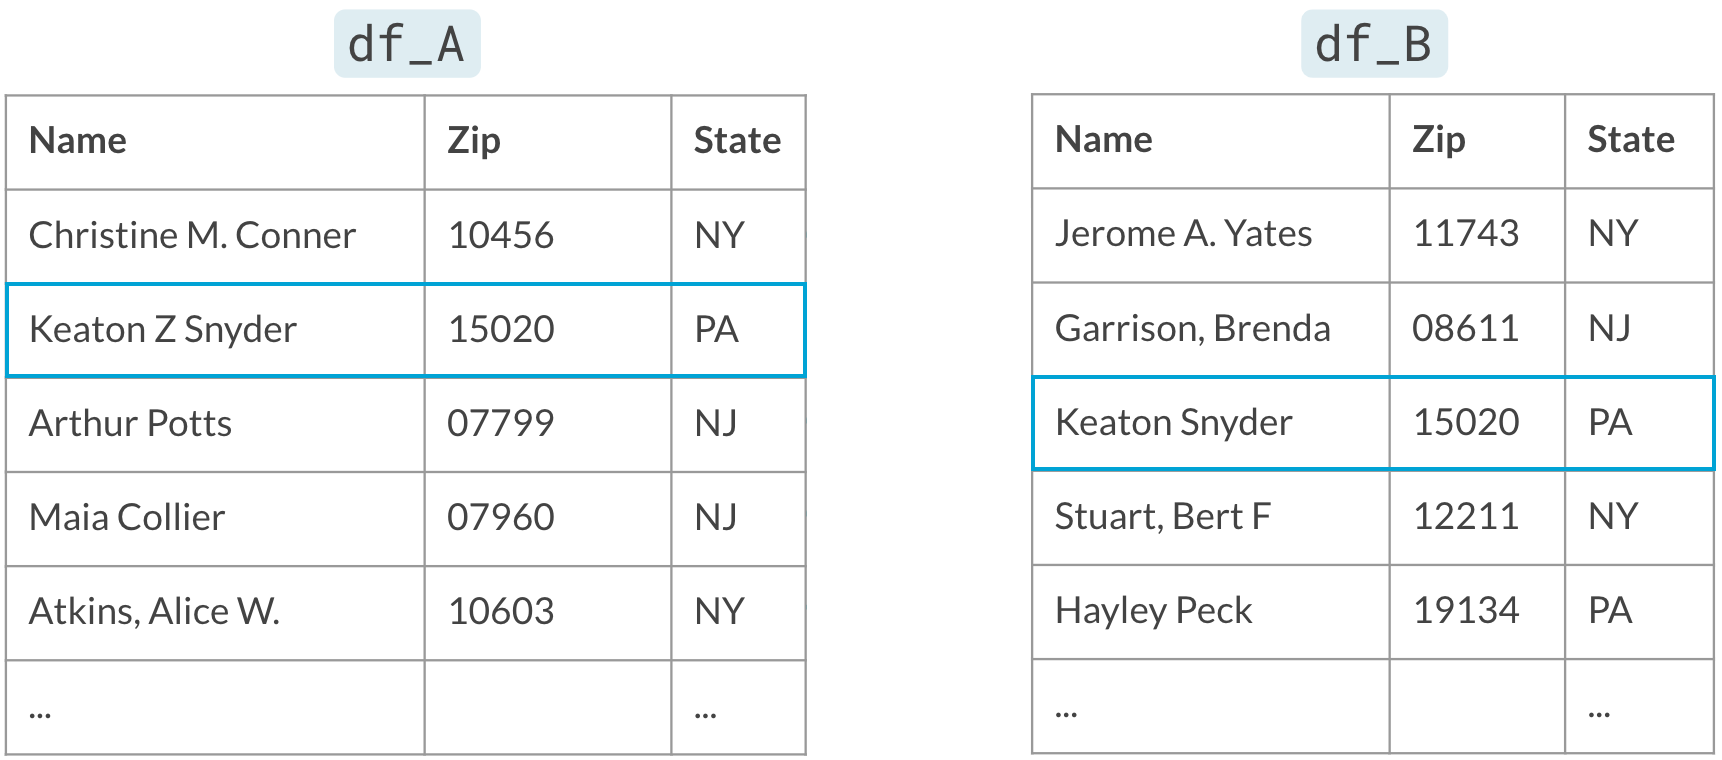
Due tabelle, df_A e df_B, ciascuna con nomi, CAP e stato. In df_A è evidenziata la riga per Keaton Z Snyder, zip 15020, stato PA. In df_B è evidenziata la riga per Keaton Snyder, zip 15020, stato PA.

Pulizia dei dati in R

Generare coppie

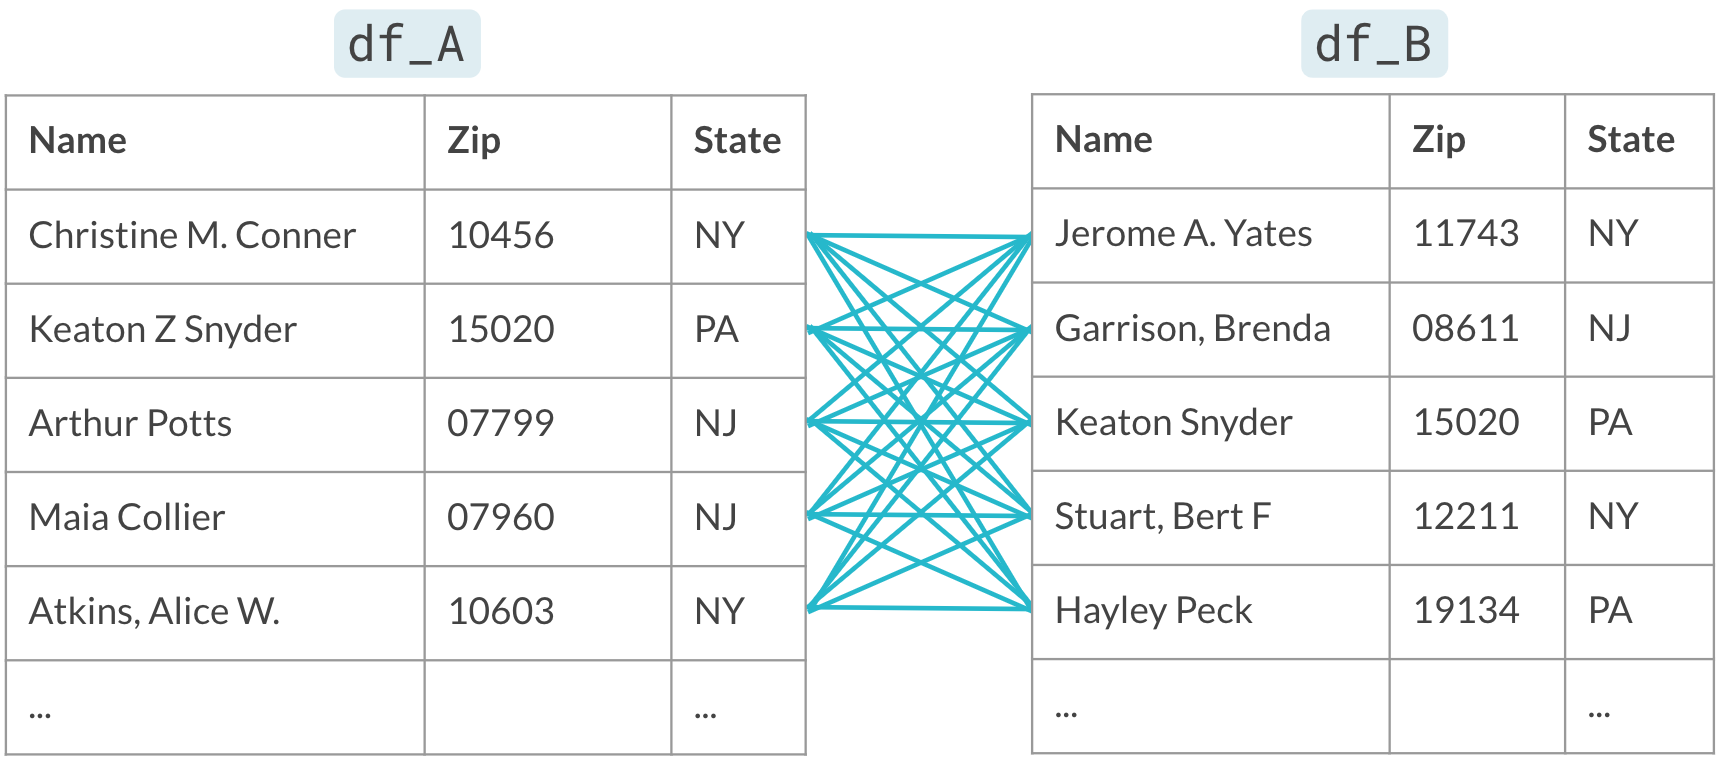
Stesse tabelle con linee da ogni riga di df_A a ogni riga di df_B per mostrare tutte le combinazioni.

Pulizia dei dati in R

Generare coppie in R

library(reclin)
pair_blocking(df_A, df_B)
Simple blocking
  No blocking used.
  First data set:  5 records
  Second data set: 5 records
  Total number of pairs: 25 pairs

ldat with 25 rows and 2 columns x y 1 1 1 2 2 1 3 3 1 ...
Pulizia dei dati in R

Troppe coppie

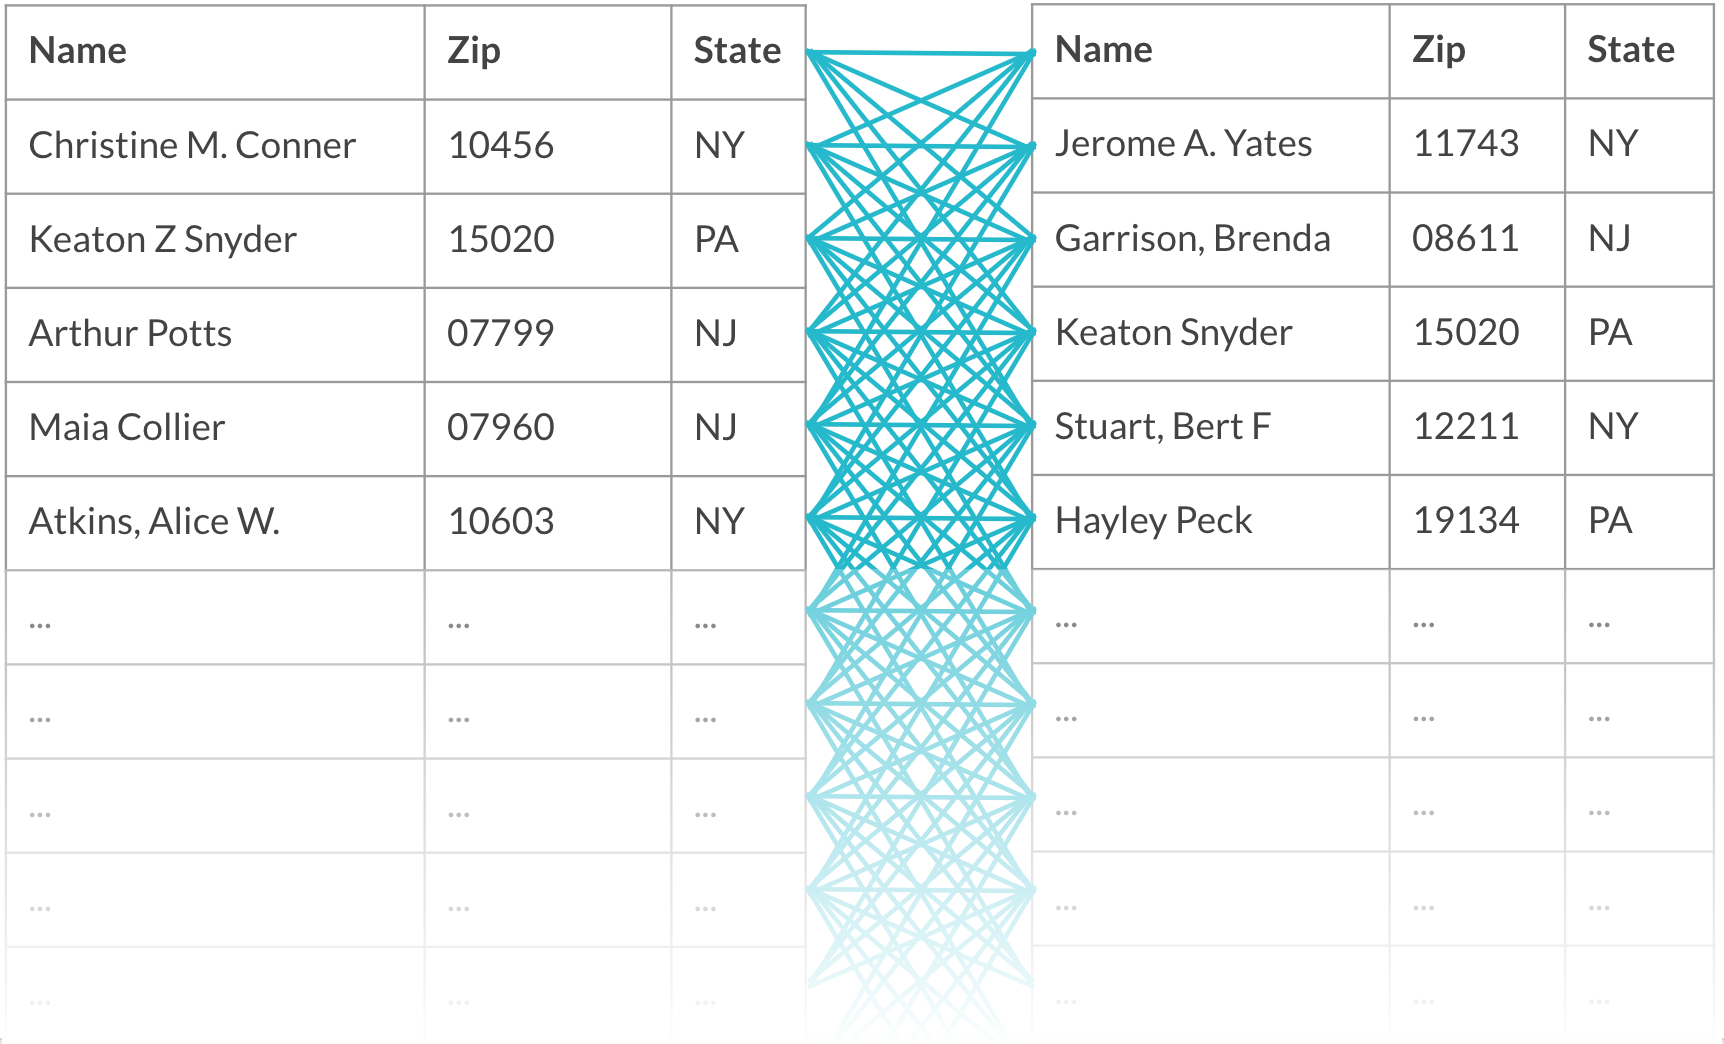
Stesse tabelle estese verso il basso con più righe e molte più linee tra ogni coppia.

Pulizia dei dati in R

Blocking

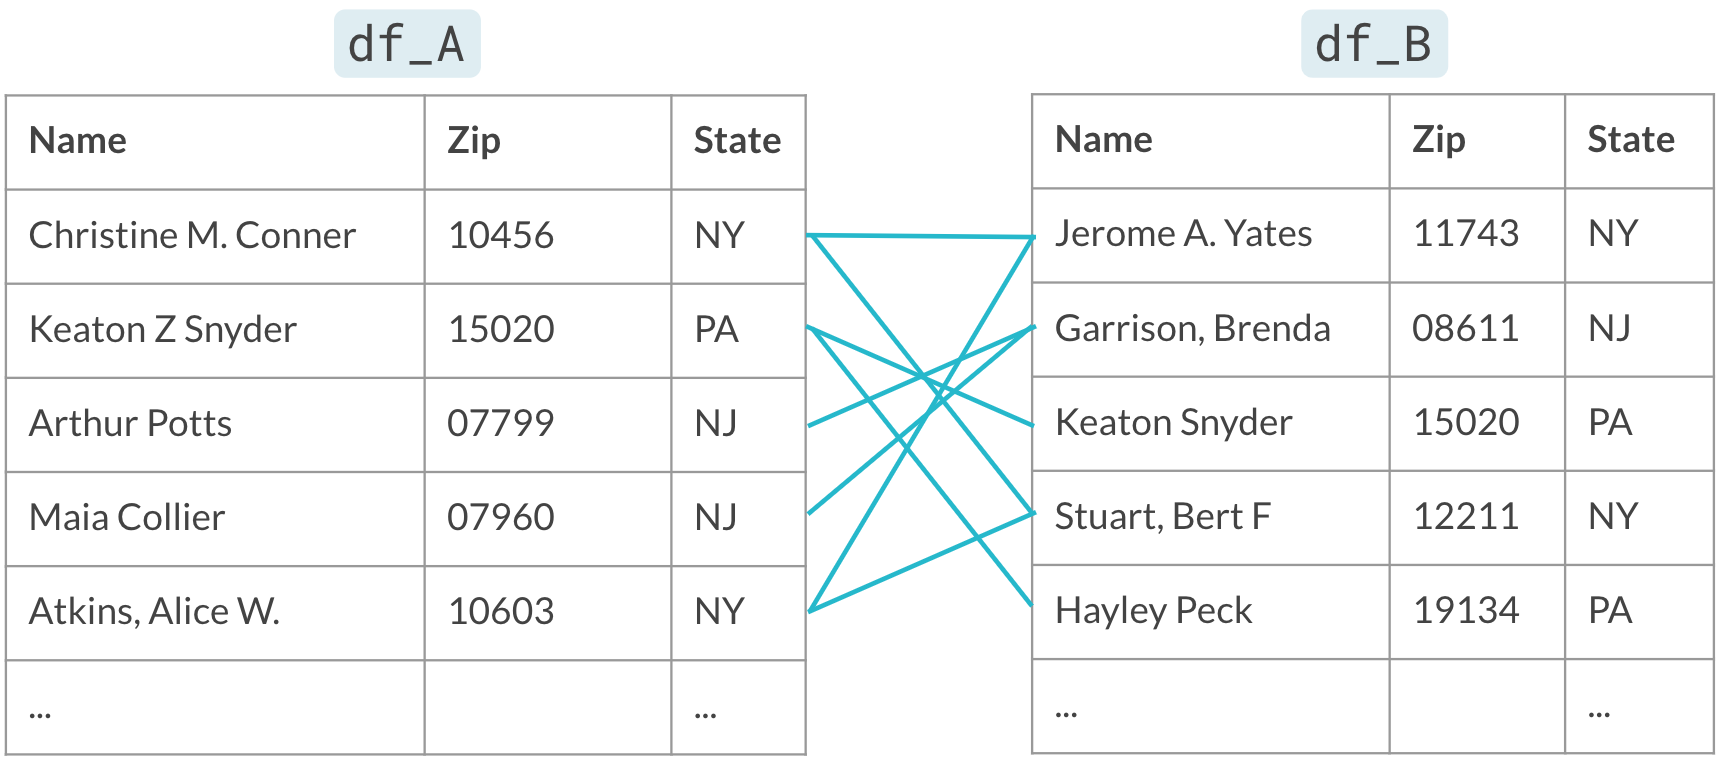
Stesse tabelle, ma solo le righe con lo stesso stato sono collegate da linee.

Considera le coppie solo quando concordano sulla variabile di blocco (State)

Pulizia dei dati in R

Pair blocking in R

pair_blocking(df_A, df_B, blocking_var = "state")
Simple blocking                                 ldat with 8 rows and 2 columns
  Blocking variable(s): state                     x y
  First data set:  5 records                    1 1 1
  Second data set: 5 records                    2 1 4
  Total number of pairs: 8 pairs                3 2 3
                                                4 2 5
                                                5 3 2
                                                6 4 2
                                                7 5 1
                                                8 5 4
Pulizia dei dati in R

Confrontare le coppie

Diagramma dei passaggi del record linkage con il passo confronta coppie evidenziato.

Pulizia dei dati in R

Confrontare le coppie

pair_blocking(df_A, df_B, blocking_var = "state") %>%

compare_pairs(by = "name", default_comparator = lcs())
Compare                                     ldat with 8 rows and 3 columns            
  By: name                                      x y      name
                                              1 1 1 0.3529412
Simple blocking                               2 1 4 0.3030303
  Blocking variable(s): state                 3 2 3 0.9285714
  First data set:  5 records                  4 2 5 0.2962963    
  Second data set: 5 records                  ...
  Total number of pairs: 8 pairs              8 5 4 0.3333333
Pulizia dei dati in R

Confrontare più colonne

pair_blocking(df_A, df_B, blocking_var = "state") %>%
  compare_pairs(by = c("name", "zip"), default_comparator = lcs())
Compare                                    ldat with 8 rows and 4 columns
  By: name, zip                              x y      name zip
                                           1 1 1 0.3529412 0.4
Simple blocking                            2 1 4 0.3030303 0.2
  Blocking variable(s): state              3 2 3 0.9285714 1.0
  First data set:  5 records               4 2 5 0.2962963 0.2
  Second data set: 5 records               ...
  Total number of pairs: 8 pairs           8 5 4 0.3333333 0.2
Pulizia dei dati in R

Comparatori diversi

  • default_comparator = lcs()
  • default_comparator = jaccard()
  • default_comparator = jaro_winkler()
Pulizia dei dati in R

Esercitiamoci!

Pulizia dei dati in R

Preparing Video For Download...