Introduzione al bootstrapping

Campionamento in R

Richie Cotton

Data Evangelist at DataCamp

Con o senza

Campionamento senza reinserimento
Carte da gioco su un tavolo da casinò.

Campionamento con reinserimento ("resampling")

Quattro dadi che rotolano.

Campionamento in R

Campionamento casuale semplice senza reinserimento

Popolazione
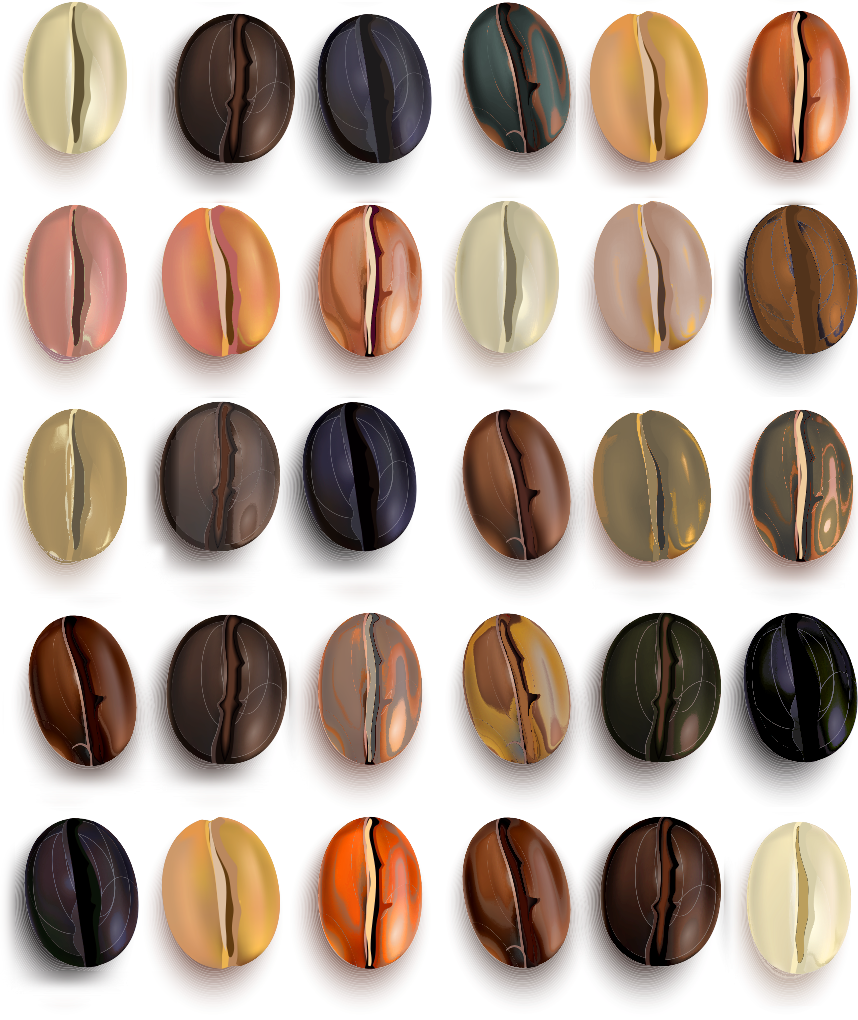
Chicchi di caffè disposti in righe e colonne.

Campione

Chicchi di caffè disposti in righe e colonne, per lo più in grigio.

Campionamento in R

Campionamento casuale semplice con reinserimento

Popolazione

Chicchi di caffè disposti in righe e colonne.

Campione

Un campione casuale di chicchi di caffè, alcuni dei quali ripetuti.

Campionamento in R

Perché campionare con reinserimento?

  • Considera i dati coffee_ratings come un campione di una popolazione più ampia di tutti i caffè.
  • Pensa a ciascun caffè del campione come rappresentativo di molti altri caffè che non abbiamo nel campione ma esistono nella popolazione.
  • Il campionamento con reinserimento è un modo per includere membri diversi di questi gruppi nel campione.
Campionamento in R

Preparazione dei dati sul caffè

coffee_focus <- coffee_ratings %>%
  select(variety, country_of_origin, flavor) %>%
  rowid_to_column()
glimpse(coffee_focus)
Rows: 1,338
Columns: 4
$ rowid             <int> 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11, 12, 13, 14, 15, ...
$ variety           <chr> NA, "Other", "Bourbon", NA, "Other", NA, "Other", N...
$ country_of_origin <chr> "Ethiopia", "Ethiopia", "Guatemala", "Ethiopia", "E...
$ flavor            <dbl> 8.83, 8.67, 8.50, 8.58, 8.50, 8.42, 8.50, 8.33, 8.6...
Campionamento in R

Resampling con slice_sample()

coffee_resamp <- coffee_focus %>%
  slice_sample(prop = 1, replace = TRUE)
# A tibble: 1,338 x 4
   rowid variety country_of_origin flavor
   <int> <chr>   <chr>              <dbl>
 1  1253 Bourbon Guatemala           6.92
 2   186 Caturra Colombia            7.58
 3  1185 Bourbon Guatemala           7.42
 4  1273 NA      Philippines         6.5 
 5  1042 Caturra Honduras            7.33
 6   195 Caturra Guatemala           7.75
 7  1219 Typica  Mexico              7   
 8   952 Caturra Honduras            7.5 
 9    41 Caturra Thailand            8.33
10   460 Caturra Honduras            7.67
# ... with 1,328 more rows
Campionamento in R

Caffè ripetuti

coffee_resamp %>% 
  count(rowid, sort = TRUE)
# A tibble: 844 x 2
   rowid     n
   <int> <int>
 1   704     5
 2   913     5
 3  1070     5
 4    16     4
 5   180     4
 6   230     4
 7   234     4
 8   342     4
 9   354     4
10   423     4
# ... with 834 more rows
Campionamento in R

Caffè mancanti

coffee_resamp %>% 
  summarize(
    coffees_included = n_distinct(rowid),
    coffees_not_included = n() - coffees_included
  )
# A tibble: 1 x 2
  coffees_included coffees_not_included
             <int>                <int>
1              844                  494
Campionamento in R

Bootstrapping

Il contrario del campionare da una popolazione.

Campionamento: passare da una popolazione a un campione più piccolo.

Bootstrapping: costruire una popolazione teorica a partire dal tuo campione.

Caso d'uso del bootstrapping

  • Capire la variabilità di campionamento usando un singolo campione.

Uno stivale da cowboy.

Campionamento in R

Processo di bootstrapping

  1. Crea un resample della stessa dimensione del campione originale.
  2. Calcola la statistica di interesse per questo campione bootstrap.
  3. Ripeti i passaggi 1 e 2 molte volte.

Le statistiche ottenute si chiamano statistiche bootstrap e, osservate per valutarne la variabilità, formano una distribuzione bootstrap.

Campionamento in R

Bootstrapping della media del gusto del caffè

# Passo 3. Ripeti molte volte
mean_flavors_1000 <- replicate(
  n = 1000,
  expr = {
    coffee_focus %>%
      # Passo 1. Resample
      slice_sample(prop = 1, replace = TRUE) %>%
      # Passo 2. Calcola la statistica
      summarize(mean_flavor = mean(flavor, na.rm = TRUE)) %>% 
      pull(mean_flavor)
  })
Campionamento in R

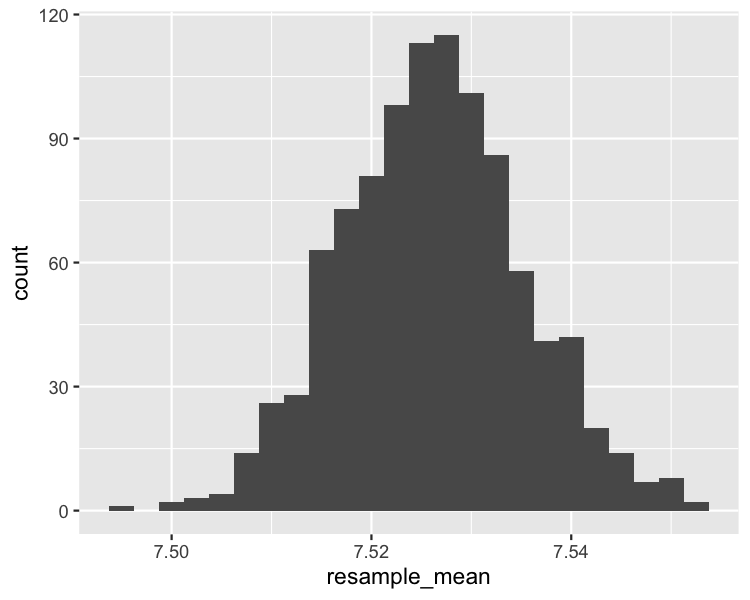
Istogramma della distribuzione bootstrap
bootstrap_distn <- tibble(
  resample_mean = mean_flavors_1000
)
ggplot(bootstrap_distn, aes(resample_mean)) +
  geom_histogram(binwidth = 0.0025)

Un istogramma della distribuzione bootstrap della media campionaria.

Campionamento in R

Esercitiamoci!

Campionamento in R

Preparing Video For Download...