Panoramica della classificazione del testo

Deep Learning per il testo con PyTorch

Shubham Jain

Instructor

Definizione di classificazione del testo

  • Assegnare etichette al testo
  • Dare significato a parole e frasi


Tipi di classificazione in Machine Learning

  • Organizza e dà struttura ai dati non strutturati
  • Applicazioni:

    • Analisi del sentiment nelle recensioni
    • Rilevamento dello spam nelle email
    • Tag dei notiziari con argomenti pertinenti
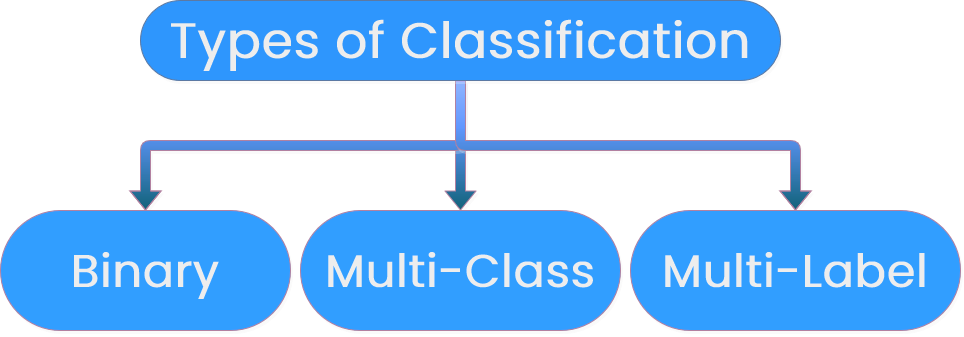
  • Tipi: binaria, multi-classe, multi-etichetta

Deep Learning per il testo con PyTorch

Classificazione binaria

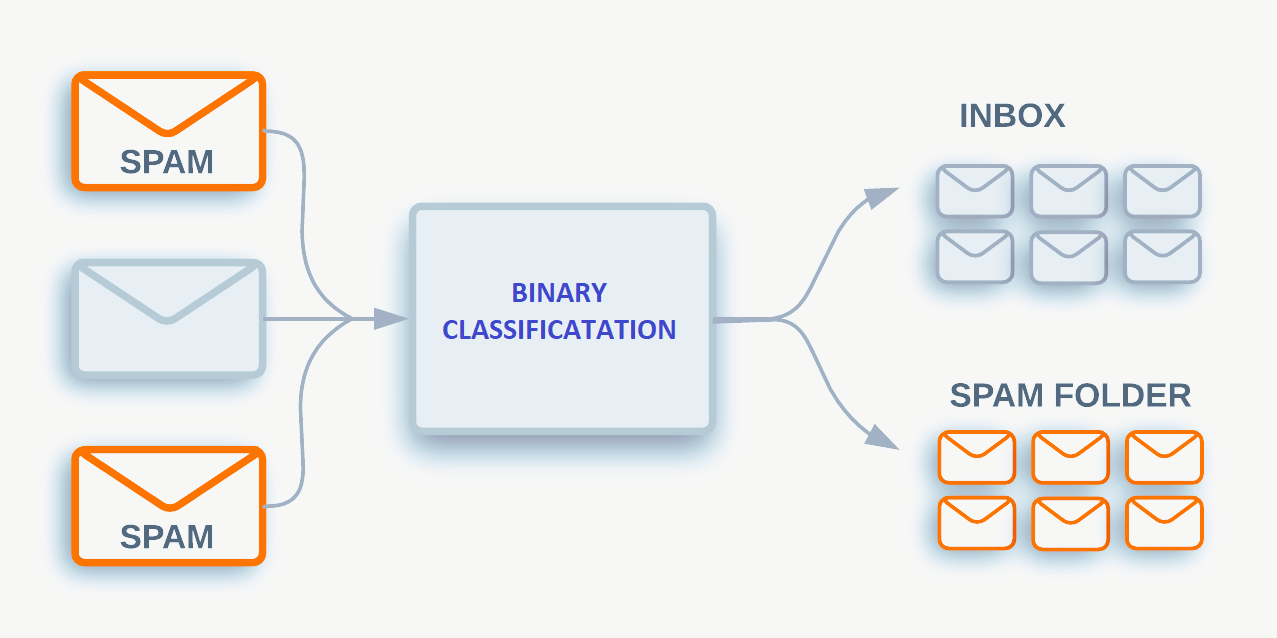
  • Smistare in due categorie
  • Esempio: rilevamento spam nelle email
  • Le email possono essere classificate come "spam" o "non spam"

Classificazione binaria

1 https://storage.googleapis.com/gweb-cloudblog-publish/images/image4_v2LFcq0.max-1200x1200.png
Deep Learning per il testo con PyTorch

Classificazione multi-classe

Classificazione delle notizie

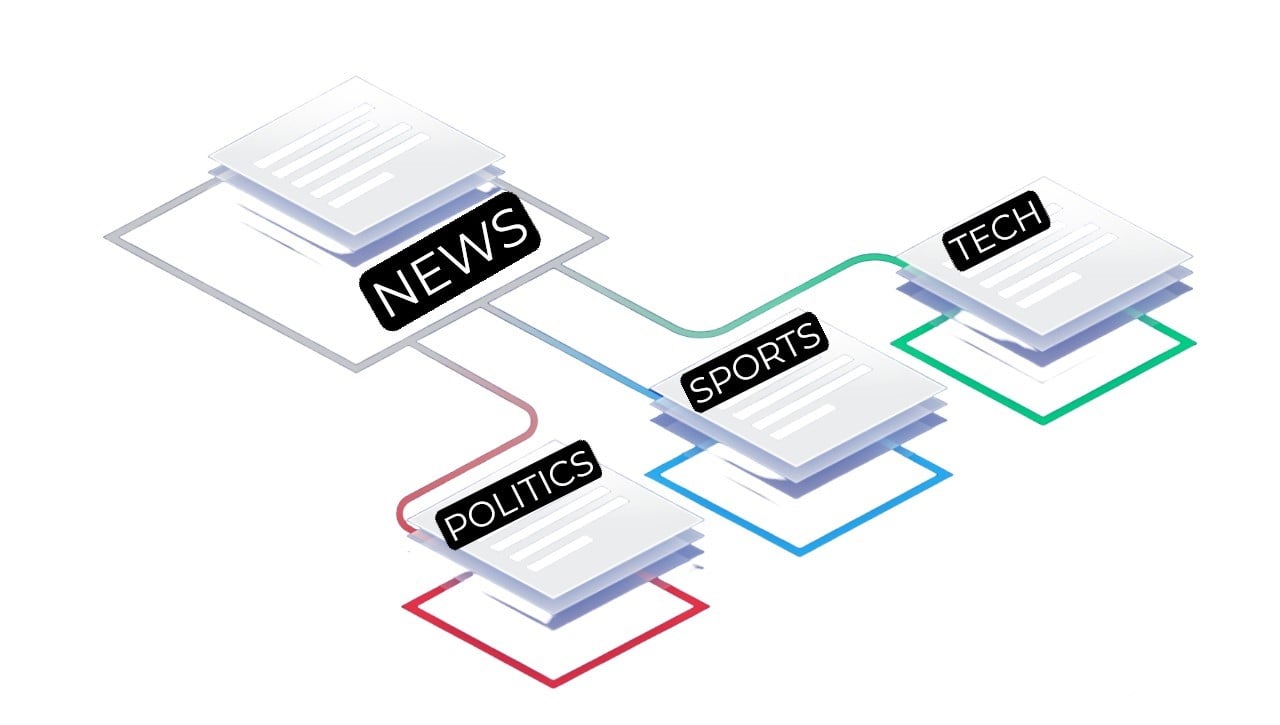
  • Smistare in più categorie
  • Esempio: Articoli di news in categorie come
    1. Politica
    2. Sport
    3. Tecnologia
Deep Learning per il testo con PyTorch

Classificazione multi-etichetta

  • Ogni testo può avere più etichette
  • Esempio: i libri possono avere più generi
    • Azione
    • Avventura
    • Fantasy
Deep Learning per il testo con PyTorch

Cosa sono i word embedding

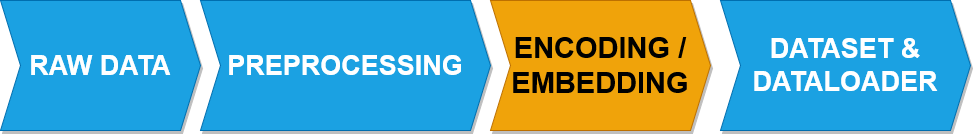
Pipeline di word embedding

Esempio di word embedding

  • Le tecniche di codifica viste prima sono un buon inizio
    • Spesso creano troppe feature e non colgono parole simili
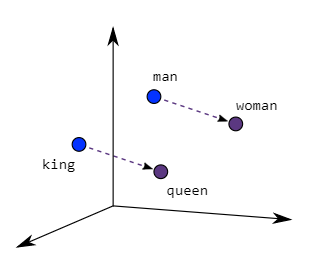
  • I word embedding mappano le parole in vettori numerici
  • Esempio di relazione semantica:
    • King e queen
    • Man e woman
Deep Learning per il testo con PyTorch

Mappatura parola-indice

  • Esempio:
    • "King" -> 1
    • "Queen" -> 2
  • Compatto ed efficiente dal punto di vista computazionale
  • Segue la tokenization nella pipeline
Deep Learning per il testo con PyTorch

Word embedding in PyTorch

  • torch.nn.Embedding:
    • Crea vettori di parole dagli indici


  • Input: indici per ['The', 'cat', 'sat', 'on', 'the', 'mat']
Embedding for 'the': tensor([-0.4689,  0.3164, -0.2971, -0.1291,  0.4064])
Embedding for 'cat': tensor([-0.0978, -0.4764,  0.0476,  0.1044, -0.3976])
Embedding for 'sat': tensor([ 0.2731,  0.4431,  0.1275,  0.1434, -0.4721])
Deep Learning per il testo con PyTorch

Uso di torch.nn.Embedding

import torch
from torch import nn

words = ["The", "cat", "sat", "on", "the", "mat"] word_to_idx = {word: i for i, word in enumerate(words)}
inputs = torch.LongTensor([word_to_idx[w] for w in words])
embedding = nn.Embedding(num_embeddings=len(words), embedding_dim=10)
output = embedding(inputs)
print(output)
tensor([[ 1.0624,  0.6792,  0.0459,  ... -1.0828, -0.4475,  0.4868],
         ...
         [1.5766,  0.0106,  0.1161,  ...,,  -0.0859, 1.3160,  1.3621])
Deep Learning per il testo con PyTorch

Uso degli embedding nella pipeline

def preprocess_sentences(text):
  # Tokenization
  # Stemming
  ...

# Word to index mapping
class TextDataset(Dataset): def __init__(self, encoded_sentences): self.data = encoded_sentences def __len__(self): return len(self.data) def __getitem__(self, index): return self.data[index]
def text_processing_pipeline(text):
    tokens = preprocess_sentences(text)
    dataset = TextDataset(tokens)
    dataloader = DataLoader(dataset, batch_size=2, 
                            shuffle=True)
    return dataloader, vectorizer

text = "Your sample text here." dataloader, vectorizer = text_processing_pipeline(text)
embedding = nn.Embedding(num_embeddings=10, embedding_dim=50) for batch in dataloader: output = embedding(batch) print(output)
Deep Learning per il testo con PyTorch

Esercitiamoci!

Deep Learning per il testo con PyTorch

Preparing Video For Download...