Attacchi avversari sui modelli di classificazione del testo
Deep Learning per il testo con PyTorch
Shubham Jain
Instructor
Cosa sono gli attacchi avversari?
Ritocchi ai dati di input
Cambiamenti malevoli calcolati, non casuali
Possono influenzare fortemente le decisioni dell'IA
Importanza della robustezza
Sistemi IA che giudicano commenti come tossici o innocui
IA che amplifica stereotipi negativi da dati distorti
IA che fornisce informazioni fuorvianti
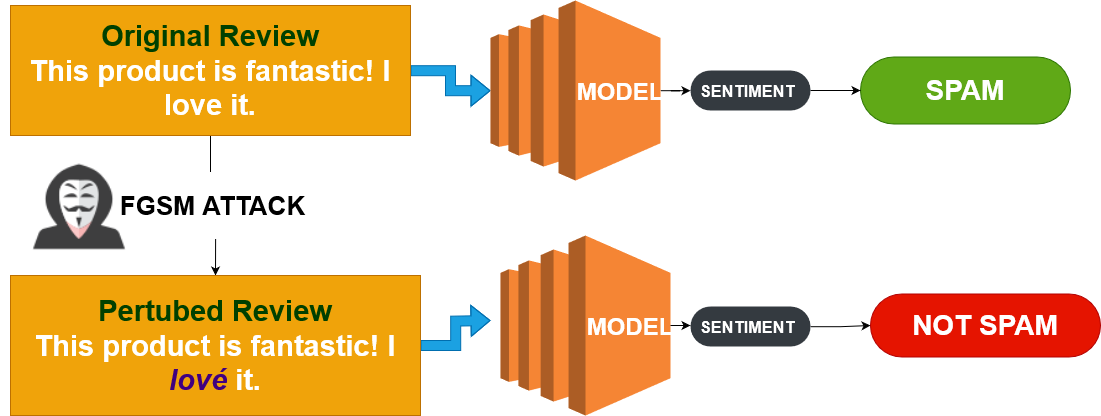
Fast Gradient Sign Method (FGSM)
Sfrutta ciò che il modello ha appreso
Apporta la minima modifica per ingannare il modello
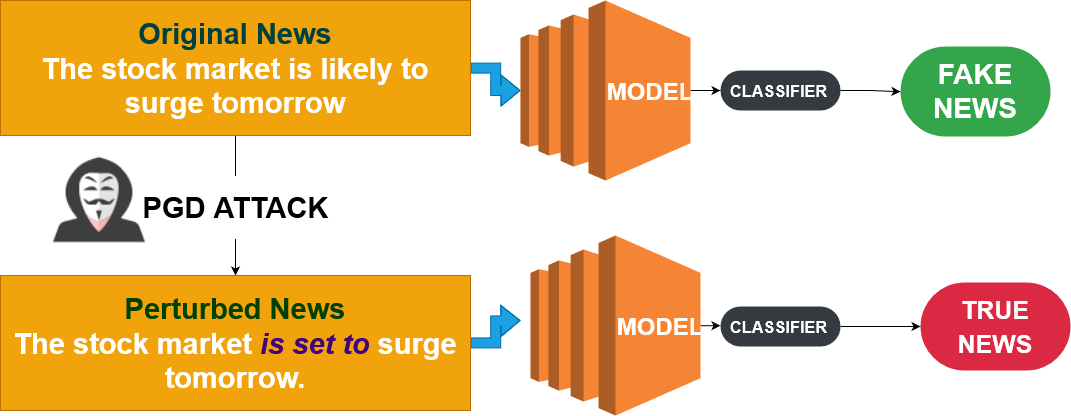
Projected Gradient Descent (PGD)
Più avanzato di FGSM: è iterativo
Cerca il disturbo più efficace
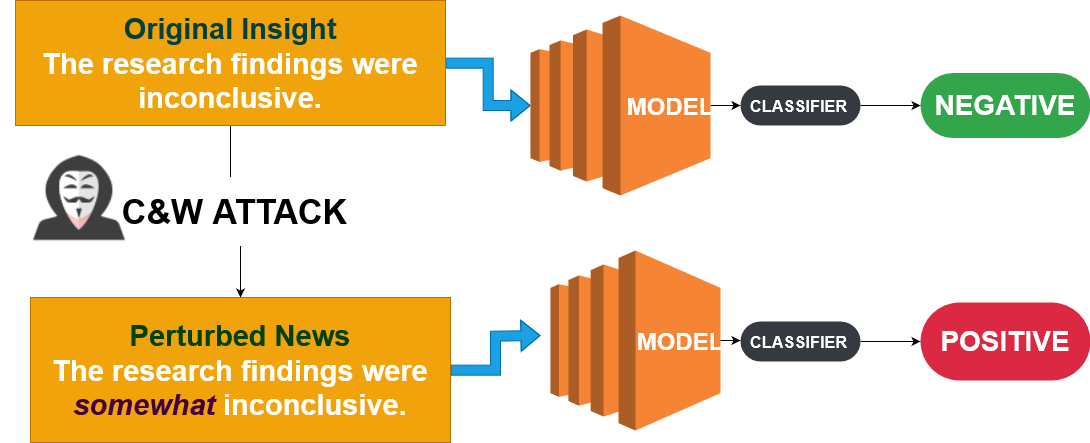
L'attacco Carlini & Wagner (C&W)
Punta a ottimizzare la funzione di perdita
Non solo ingannare, ma restare invisibile
Costruire difese: strategie
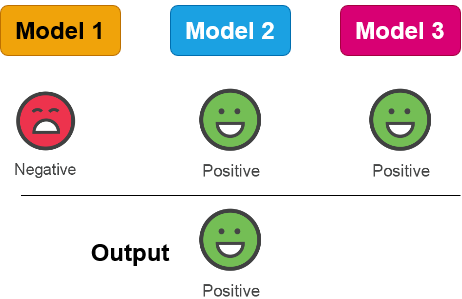
Model Ensembling:
Usa più modelli
Robust Data Augmentation:
Data augmentation
Adversarial Training:
Prevedi i tentativi di inganno
Costruire difese: strumenti e tecniche
PyTorch's Robustness Toolbox:
Rafforza i modelli di testo
Gradient Masking:
Aggiungi varietà ai dati di training per nascondere pattern sfruttabili
Regularization Techniques:
Mantieni l'equilibrio del modello
1
https://adversarial-robustness-toolbox.readthedocs.io/en/latest/, https://stock.adobe.com/ie/contributor/209161356/designer-s-circle
Esercitiamoci!
Deep Learning per il testo con PyTorch
Preparing Video For Download...