Metodi per raccogliere feedback di alta qualità

Reinforcement Learning from Human Feedback (RLHF)

Mina Parham

AI Engineer

Metodi per raccogliere feedback di alta qualità
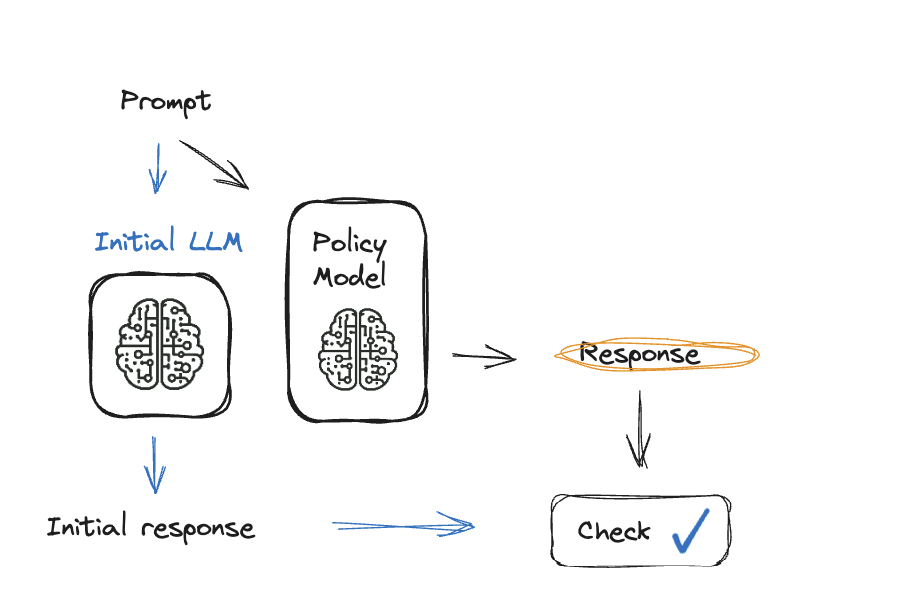
Il processo di RLHF, senza il modello di ricompensa.

Reinforcement Learning from Human Feedback (RLHF)

Metodi per raccogliere feedback di alta qualità

Il processo completo di RLHF.

Reinforcement Learning from Human Feedback (RLHF)

Confronti a coppie

  • Scegliere tra due opzioni:
  • Vantaggi: semplice, intuitivo, riduce i bias
  • Sfide: meno informazioni per etichetta
  • Esempio: Film A vs. Film B: "Quale preferisci?

Una persona con due cartelli in mano: uno con un'icona "Accettato" e uno con un'icona "Rifiutato".

Reinforcement Learning from Human Feedback (RLHF)

Confronti a coppie

def evaluate_responses(responses_A, responses_B):
    wins_A, wins_B = 0, 0
    for (response_A, score_A), (response_B, score_B) in zip(responses_A, responses_B):
        if score_A > score_B:
            wins_A += 1
        else:
            wins_B += 1
    success_rate_A = (wins_A / len(responses_A)) * 100
    success_rate_B = (wins_B / len(responses_B)) * 100
    return success_rate_A, success_rate_B
Reinforcement Learning from Human Feedback (RLHF)

Valutazioni

  • Assegnare un punteggio su una scala:

  • Vantaggi: feedback più dettagliato

  • Sfide: soggetto a bias, scale incoerenti
  • Esempio:
      Film A: 4/5
      Film B: 3/5
    

Illustrazione di una donna che tiene una stella con intorno icone di valutazione.

Reinforcement Learning from Human Feedback (RLHF)

Fattori psicologici

  • Bias cognitivi:
    • Effetto framing: come poni la domanda può influenzare le risposte
    • Effetto di posizione seriale: l'ordine delle opzioni può influenzare le scelte
    • Ancoraggio: informazioni precedenti condizionano le decisioni attuali

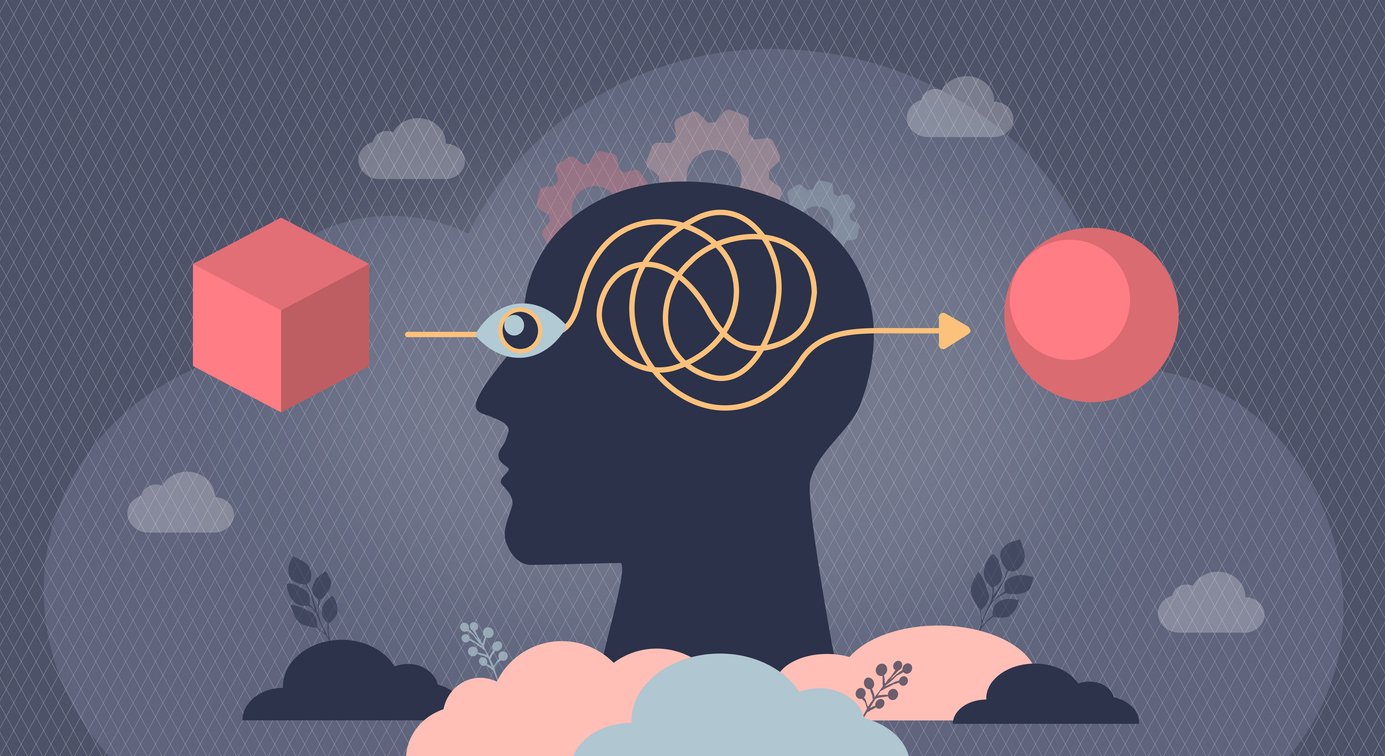
Immagine di una persona che vede un quadrato con gli occhi ma lo interpreta come un rettangolo nella mente, a illustrare il concetto di bias.

Reinforcement Learning from Human Feedback (RLHF)

Linee guida per raccogliere feedback di alta qualità
 

  • Carico cognitivo: utenti stanchi, feedback incoerenti
  • Formula bene le domande
    • Per ridurre i rischi dovuti al carico cognitivo.
  • Randomizza l'ordine delle query
    • Per minimizzare i bias di ancoraggio e framing
  • Raccogli dati diversi
    • Per mitigare il rumore.

Immagine di un uomo e una donna che analizzano feedback e testi.

Reinforcement Learning from Human Feedback (RLHF)

Esercitiamoci!

Reinforcement Learning from Human Feedback (RLHF)

Preparing Video For Download...