Training con PPO

Reinforcement Learning from Human Feedback (RLHF)

Mina Parham

AI Engineer

Fine-tuning con reinforcement learning
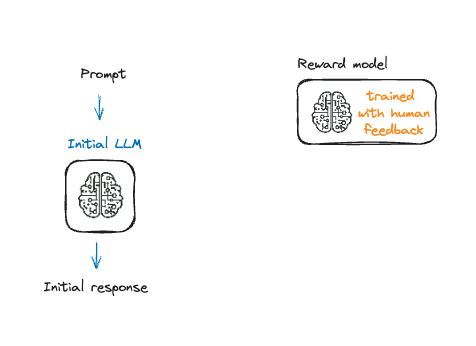
Il LLM iniziale e il modello di ricompensa nel processo RLHF.

Reinforcement Learning from Human Feedback (RLHF)

Fine-tuning con reinforcement learning
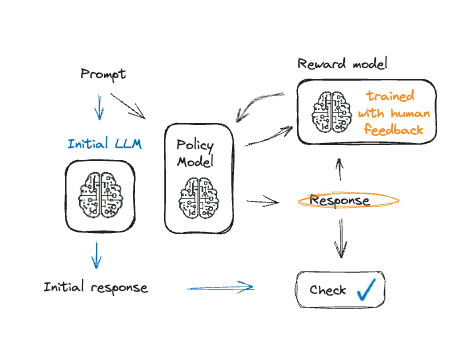
L'intero processo RLHF.

Reinforcement Learning from Human Feedback (RLHF)

Fine-tuning di un Language Model con PPO
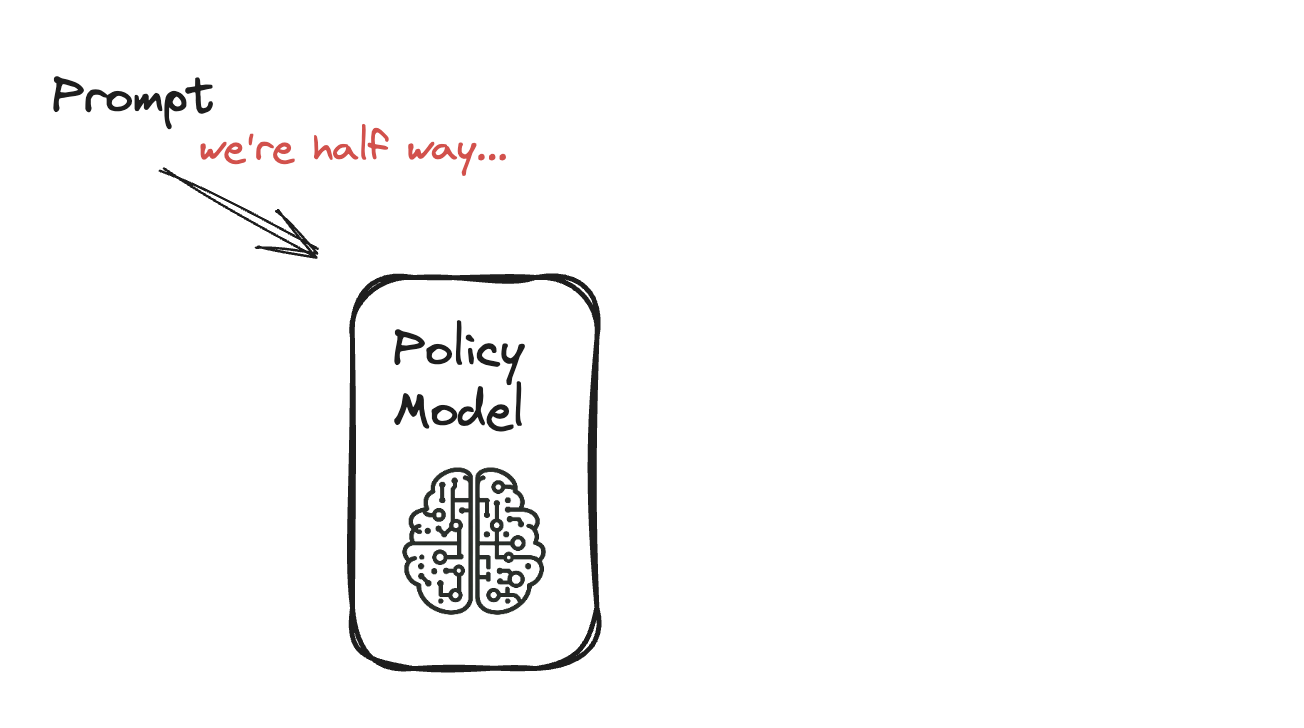
 

Schema di una query data a un LLM per generare una continuazione.

Reinforcement Learning from Human Feedback (RLHF)

Fine-tuning di un Language Model con PPO
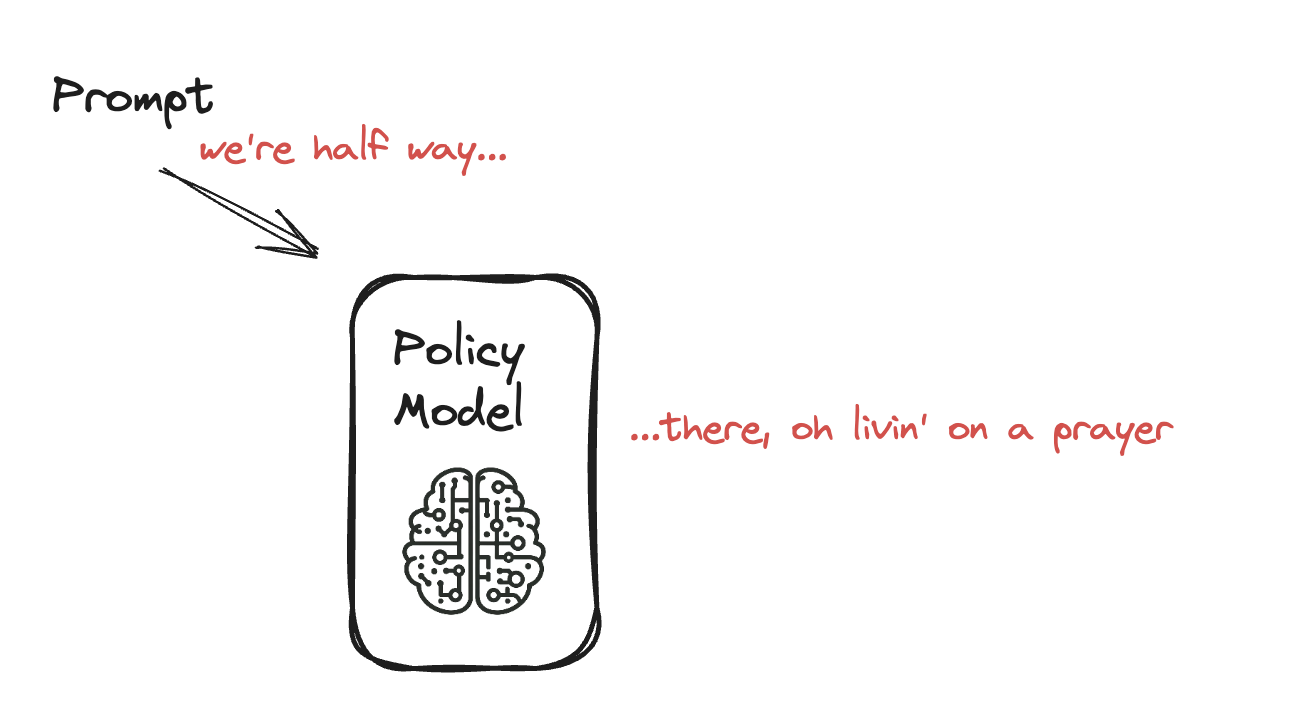
 

Schema di una query data a un LLM che completa: 'we're half way there, oh livin' on a prayer'.

Reinforcement Learning from Human Feedback (RLHF)

Fine-tuning di un Language Model con PPO
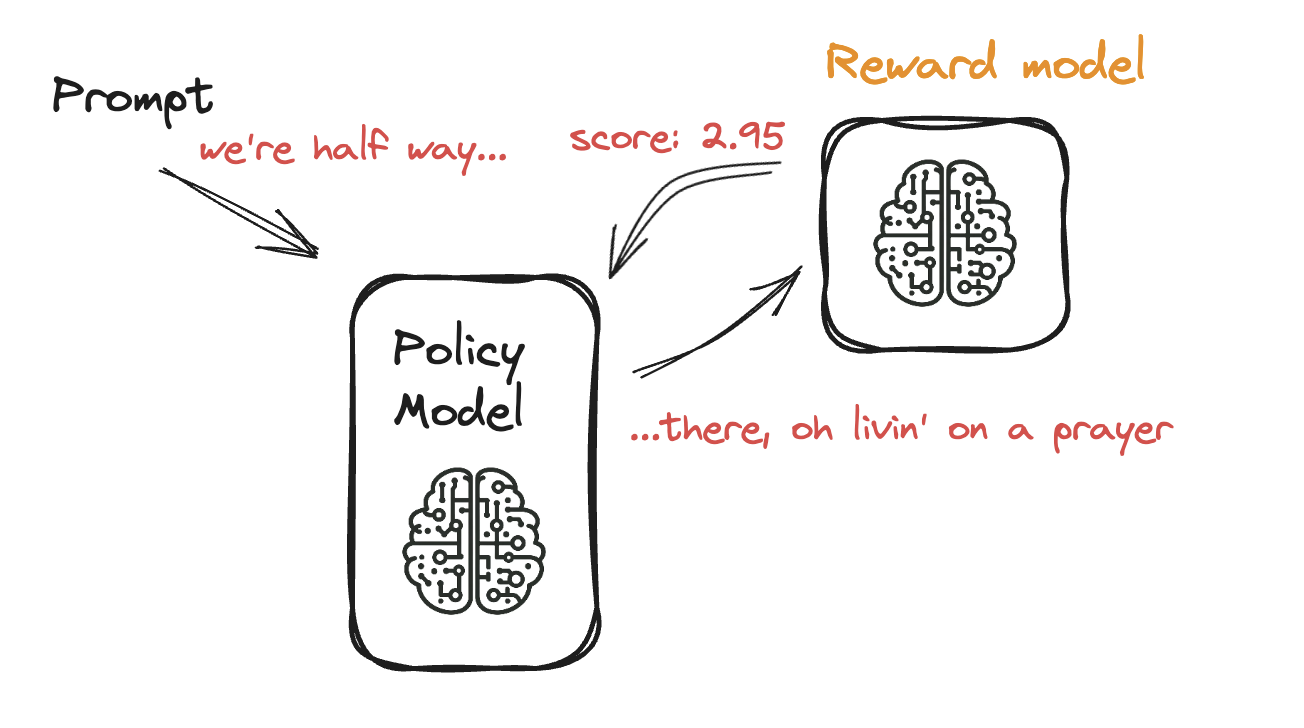
 

Schema di una query data a un LLM che completa: 'we're half way there, oh livin' on a prayer', con un altro LLM che valuta la risposta.

Reinforcement Learning from Human Feedback (RLHF)

Fine-tuning di un Language Model con PPO

  • PPO: aggiustamenti graduali al modello
  • Evita l'overfitting al feedback

Un robot e una lumaca che rappresentano il lento miglioramento dell'algoritmo.

Reinforcement Learning from Human Feedback (RLHF)

Implementare PPOTrainer con TRL

from trl import PPOConfig
config = PPOConfig(model_name="gpt2",learning_rate=1.4e-5)
from trl import AutoModelForCausalLMWithValueHead
model = AutoModelForCausalLMWithValueHead.from_pretrained(config.model_name)
tokenizer = AutoTokenizer.from_pretrained(config.model_name)
from trl import PPOTrainer
ppo_trainer = PPOTrainer(model=model,config=config,dataset=dataset,
                         tokenizer=tokenizer)
Reinforcement Learning from Human Feedback (RLHF)

Avvio del training loop

for epoch in tqdm(range(10), "epoch: "):


for batch in tqdm(ppo_trainer.dataloader):
# Get responses response_tensors = ppo_trainer.generate(batch["input_ids"])
batch["response"] = [tokenizer.decode(r.squeeze()) for r in response_tensors]
# Compute reward score texts = [q + r for q, r in zip(batch["query"], batch["response"])]
rewards = reward_model(texts)
stats = ppo_trainer.step(query_tensors, response_tensors, rewards) ppo_trainer.log_stats(stats, batch, rewards)
Reinforcement Learning from Human Feedback (RLHF)

Esercitiamoci!

Reinforcement Learning from Human Feedback (RLHF)

Preparing Video For Download...