Metriche del modello e regolazioni

Reinforcement Learning from Human Feedback (RLHF)

Mina Parham

AI Engineer

Perché usare un modello di riferimento?
  • Output senza senso

Una serie di emoji.

Reinforcement Learning from Human Feedback (RLHF)

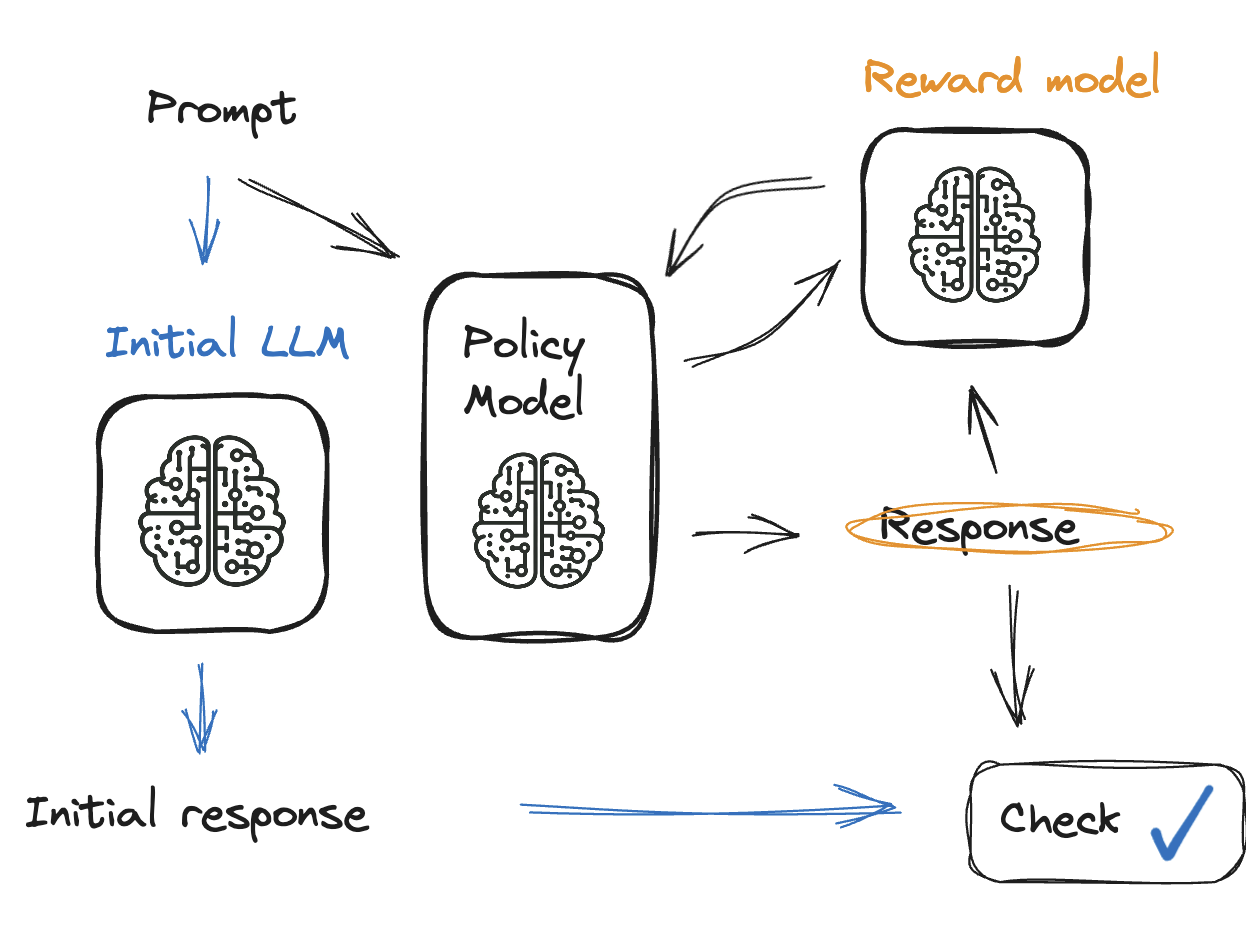
Verificare l'output del modello

Diagramma del processo RLHF con verifica della risposta.

Reinforcement Learning from Human Feedback (RLHF)

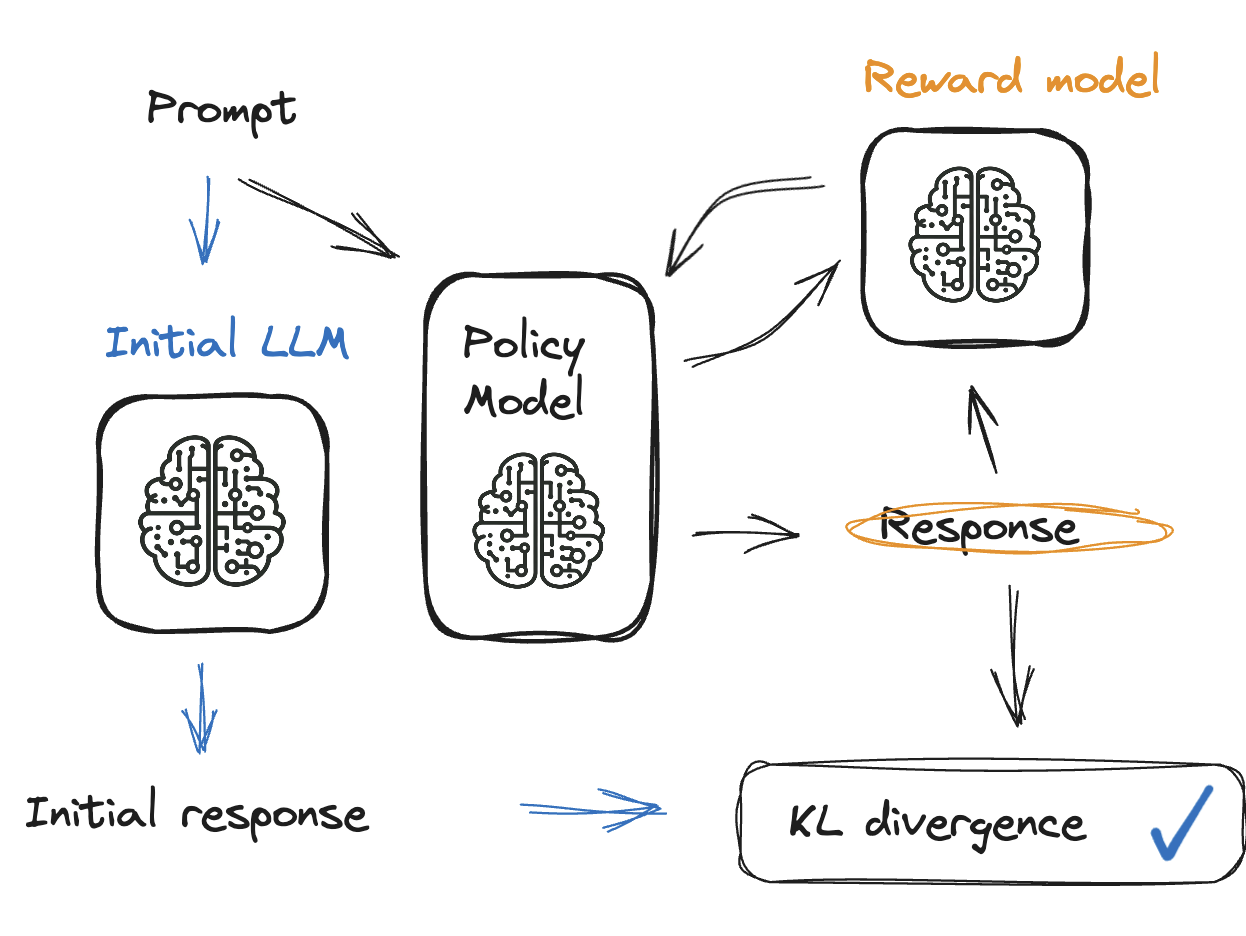
Soluzione: divergenza KL

Diagramma del processo RLHF con divergenza KL.

Reinforcement Learning from Human Feedback (RLHF)

Soluzione: divergenza KL

  • Alla reward model si aggiunge una penalità
  • La penalità reindirizza il modello se produce output non pertinenti
  • La divergenza KL confronta modello attuale e reward model
Un'icona che rappresenta una bilancia.

  • Tra 0 e 10, e mai negativa
Reinforcement Learning from Human Feedback (RLHF)

Regolare i parametri

generation_kwargs = {

"min_length": -1, # don't ignore the EOS token
"top_k": 0.0, # no top-k sampling
"top_p": 1.0, "do_sample": True, "pad_token_id": tokenizer.eos_token_id, "max_new_tokens": 32}


  • I parametri vengono passati al policy model
Reinforcement Learning from Human Feedback (RLHF)

Verificare la reward model

  • Verificare la reward model

  • Verificare l'output (reward)

reward_model_results.head()
|ID | Comment                                     |Sentiment |Reward|
|---|---------------------------------------------|----------|------|
| 1 | This event was lit! So much fun!            | Positive |  0.9 |
| 2 | Terrible experience, never attending again. | Negative | -0.8 |
| 3 | It was okay, nothing extraordinary.         | Neutral  |  0.2 |
| 4 | The event was poorly organized and chaotic. | Negative | -0.85|
| 5 | Had an amazing time with great people!      | Positive |  0.95|
Reinforcement Learning from Human Feedback (RLHF)

Verificare la reward model

  • 👍 👎 Controlla i casi estremi
    extreme_positive = reward_model_results[reward_model_results['Reward'] >= 0.9]
    extreme_negative = reward_model_results[reward_model_results['Reward'] <= -0.8]
    
  • 🧘 Assicurare un dataset bilanciato

    sentiment_distribution = reward_model_results['Sentiment'].value_counts()
    
  • 📊 Normalizzare la reward model

    from sklearn.preprocessing import MinMaxScaler
    scaler = MinMaxScaler(feature_range=(-1, 1))
    scaler.fit_transform(reward_model_results[['Reward']])
    
Reinforcement Learning from Human Feedback (RLHF)

Esercitiamoci!

Reinforcement Learning from Human Feedback (RLHF)

Preparing Video For Download...