Integrare fonti di feedback diverse

Reinforcement Learning from Human Feedback (RLHF)

Mina Parham

AI Engineer

Generalizzazione del modello migliorata
 

  • Rappresenta punti di vista e contesti diversi
  • Generalizza preferenze e valori

Immagine di mani con fumetti che rappresentano opinioni diverse.

Reinforcement Learning from Human Feedback (RLHF)

Bias ridotto

  • Mitiga i bias individuali
  • Produce output più equilibrati e corretti

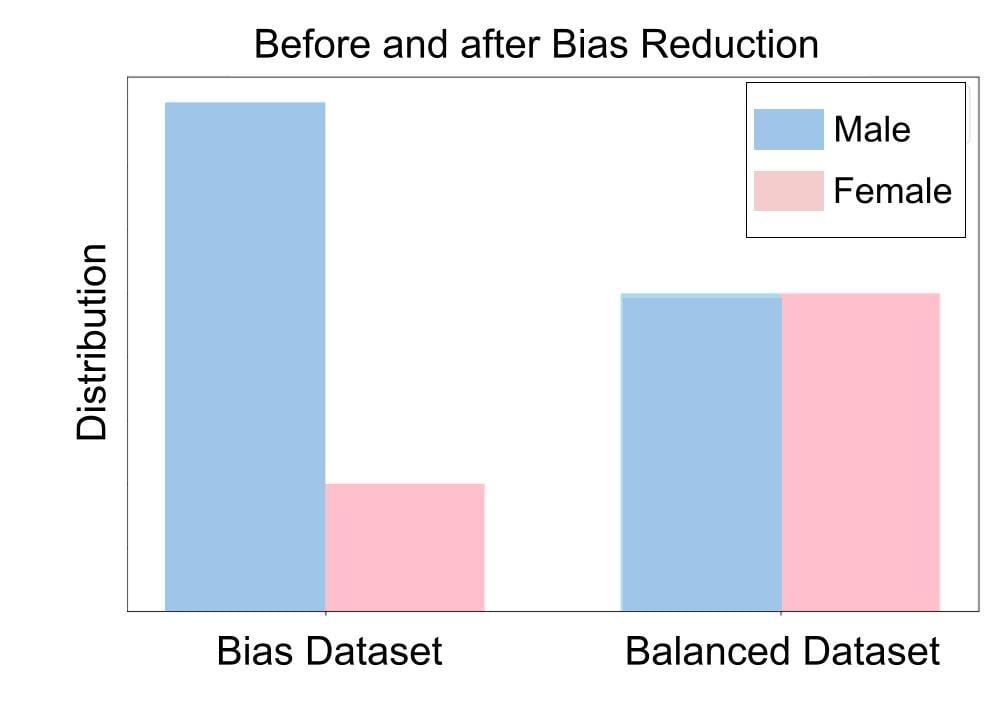
Un grafico a barre che mostra la differenza tra un insieme di dati sbilanciato verso il gruppo maschile e un insieme bilanciato con distribuzione uguale per uomini e donne

Reinforcement Learning from Human Feedback (RLHF)

Miglior allineamento ai valori umani

  • Preferenze umane complesse
  • Culture e background rappresentati

Icone che rappresentano un gruppo eterogeneo di persone

Reinforcement Learning from Human Feedback (RLHF)

Adattabilità potenziata

  • Il modello risponde a più bisogni e preferenze
  • Rappresenta punti di vista diversi

Un'icona con una persona ed emoji che indicano punti di vista diversi.

Reinforcement Learning from Human Feedback (RLHF)

Robustezza aumentata

  • Resistente a diversi tipi di input
  • Migliora le prestazioni

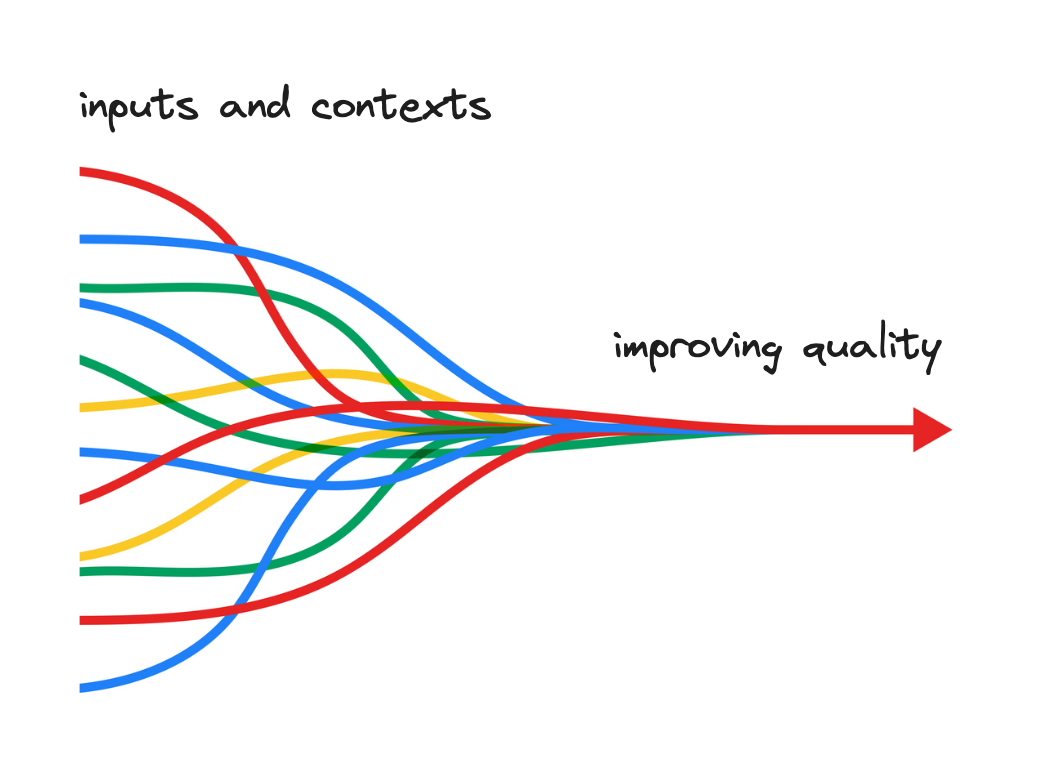
Schema che mostra una qualità migliore grazie a input e contesti diversi.

Reinforcement Learning from Human Feedback (RLHF)

Integrare dati di preferenza da più fonti

Dati di preferenza preference_df con fonti 'Journalist', 'Social Media Influencer' e 'Marketing Professional':
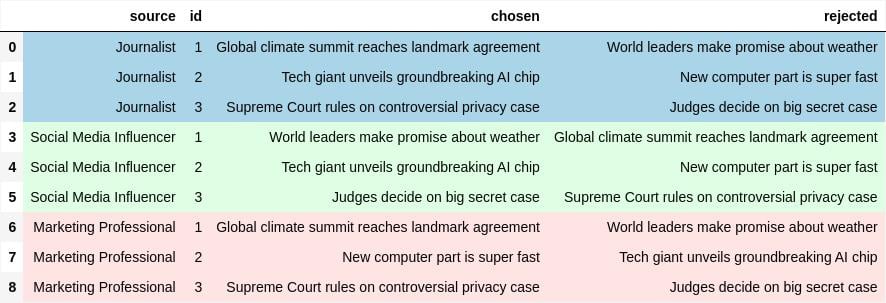
Una tabella che mostra dati strutturati da tre fonti diverse

Reinforcement Learning from Human Feedback (RLHF)

Majority voting

Questi dati di esempio si integrano facilmente raggruppando per 'id':

df_majority = preference_df.groupby(['id']).apply(majority_vote)

Poi, usando il majority voting:

from collections import Counter

def majority_vote(df):
    votes = Counter(zip(df['chosen'], df['rejected'])) 
    return max(votes, key=votes.get)
Reinforcement Learning from Human Feedback (RLHF)

Fonti di dati di preferenza inaffidabili

Dati di preferenza preference_df2 con gli stessi tre esperti:
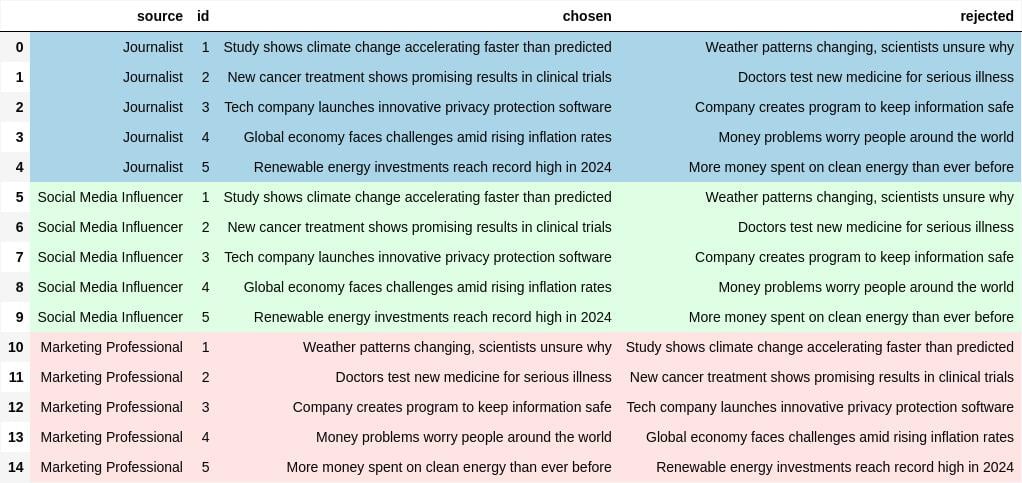
Una tabella che mostra dati strutturati da tre fonti diverse

Reinforcement Learning from Human Feedback (RLHF)

Fonti di dati di preferenza inaffidabili

  • Iterare sulle righe di preference_df2 per identificare le fonti inaffidabili:
df_majority = preference_df2.groupby('id').apply(majority_vote)

disagreements = {source: 0 for source in preference_df2['source'].unique()}
for _, row in preference_df2.iterrows(): if (row['chosen'], row['rejected']) != df_majority[row['id']]: disagreements[row['source']] += 1
detect_unreliable_source = max(disagreements, key=disagreements.get)
Reinforcement Learning from Human Feedback (RLHF)

Esercitiamoci!

Reinforcement Learning from Human Feedback (RLHF)

Preparing Video For Download...