Basi di spaCy
Natural Language Processing con spaCy

Azadeh Mobasher
Principal Data Scientist
Pipeline NLP di spaCy
import spacynlp = spacy.load("en_core_web_sm")doc = nlp("Here's my spaCy pipeline.")
- Importa
spaCy - Usa
spacy.load()per ottenerenlp, una classeLanguage- L'oggetto
Languageè la pipeline di elaborazione del testo
- L'oggetto
- Applica
nlp()a un testo per ottenere un contenitoreDoc
Pipeline NLP di spaCy
spaCy applica alcuni passaggi di elaborazione tramite la sua classe Language:
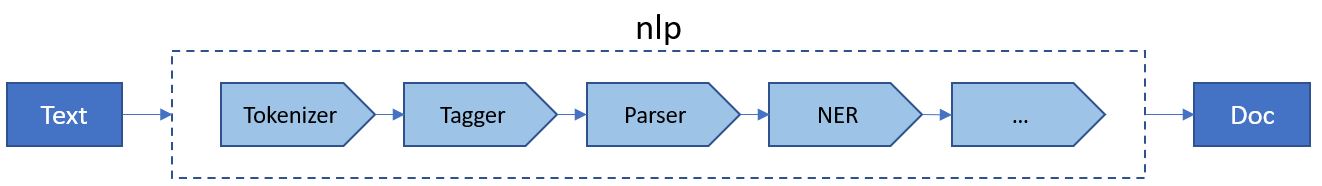
Oggetti contenitore in spaCy
- In
spaCyci sono più strutture dati per rappresentare il testo:
| Nome | Descrizione |
|---|---|
Doc |
Contenitore per accedere alle annotazioni linguistiche del testo |
Span |
Una porzione di un oggetto Doc |
Token |
Un singolo token: parola, punteggiatura, spazio, ecc. |
Componenti della pipeline
- La pipeline di elaborazione linguistica di
spaCydipende sempre dal modello caricato e dalle sue capacità.
| Componente | Nome | Descrizione |
|---|---|---|
| Tokenizer | Tokenizer | Segmenta il testo in token e crea l'oggetto Doc |
| Tagger | Tagger | Assegna le etichette morfosintattiche |
| Lemmatizer | Lemmatizer | Riduce le parole alla forma base |
| EntityRecognizer | NER | Rileva e etichetta le entità nominate |
Componenti della pipeline
Ogni componente ha funzionalità specifiche per elaborare il testo
- Language
- DependencyParser
- Sentencizer
Tokenizzazione
- Sempre la prima operazione
- Tutte le altre operazioni richiedono i token
- I token possono essere parole, numeri e punteggiatura
import spacy nlp = spacy.load("en_core_web_sm") doc = nlp("Tokenization splits a sentence into its tokens.")print([token.text for token in doc])
['Tokenization', 'splits', 'a', 'sentence', 'into', 'its', 'tokens', '.']
Segmentazione in frasi
- Più complessa della tokenizzazione
- Fa parte del componente
DependencyParser
import spacy nlp = spacy.load("en_core_web_sm") text = "We are learning NLP. This course introduces spaCy." doc = nlp(text)for sent in doc.sents: print(sent.text)
We are learning NLP.
This course introduces spaCy.
Lemmatizzazione
- Un lemma è la forma base di un token
- Il lemma di eats e ate è eat
- Migliora l'accuratezza dei modelli linguistici
import spacy nlp = spacy.load("en_core_web_sm") doc = nlp("We are seeing her after one year.")print([(token.text, token.lemma_) for token in doc])
[('We', 'we'), ('are', 'be'), ('seeing', 'see'), ('her', 'she'),
('after', 'after'), ('one', 'one'), ('year', 'year'), ('.', '.')]
Esercitiamoci!
Natural Language Processing con spaCy

