Natural Language Processing con spaCy
Azadeh Mobasher
Principal Data Scientist
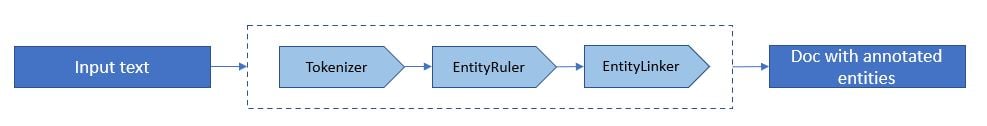
spaCy prima tokenizza il testo per creare un oggetto DocDoc viene elaborato in vari passaggi della processing pipeline
import spacy
nlp = spacy.load("en_core_web_sm")
doc = nlp(example_text)
spaCy per NER:print([ent.text for ent in doc.ents])
sentencizer: componente della pipeline spaCy per la segmentazione in frasi.text = " ".join(["This is a test sentence."]*10000)en_core_sm_nlp = spacy.load("en_core_web_sm") start_time = time.time() doc = en_core_sm_nlp(text)print(f"Finished processing with en_core_web_sm model in {round((time.time() - start_time)/60.0 , 5)} minutes")
>>> Finished processing with en_core_web_sm model in 0.09332 minutes
sentencizer:blank_nlp = spacy.blank("en")blank_nlp.add_pipe("sentencizer")start_time = time.time() doc = blank_nlp(text) print(f"Finished processing with blank model in {round((time.time() - start_time)/60.0 , 5)} minutes")
>>> Finished processing with blank model in 0.00091 minutes
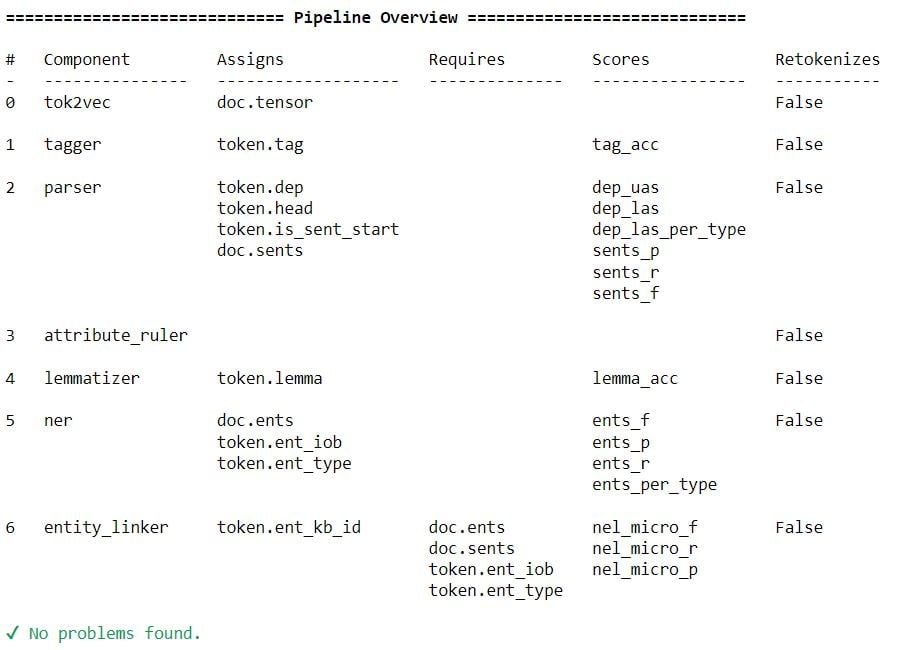
nlp.analyze_pipes() analizza una pipeline spaCy per determinare:
pretty su True verrà stampata una tabella invece di restituire solo i dati strutturati.import spacy
nlp = spacy.load("en_core_web_sm")
analysis = nlp.analyze_pipes(pretty=True)
Natural Language Processing con spaCy