Misurare la similarità semantica con spaCy

Natural Language Processing con spaCy

Azadeh Mobasher

Principal Data Scientist

Il metodo della similarità semantica


  • Processo di analisi dei testi per individuarne le somiglianze
  • Classifica i testi in categorie predefinite o rileva testi pertinenti
  • Il punteggio di similarità misura quanto due testi sono simili


What is the cheapest flight from Boston to Seattle?
Which airline serves Denver, Pittsburgh and Atlanta?
What kinds of planes are used by American Airlines?
Natural Language Processing con spaCy

Punteggio di similarità

  • Una metrica definita sui testi
  • Per misurare la similarità usa cosine similarity e word vectors
  • La cosine similarity è un numero tra 0 e 1
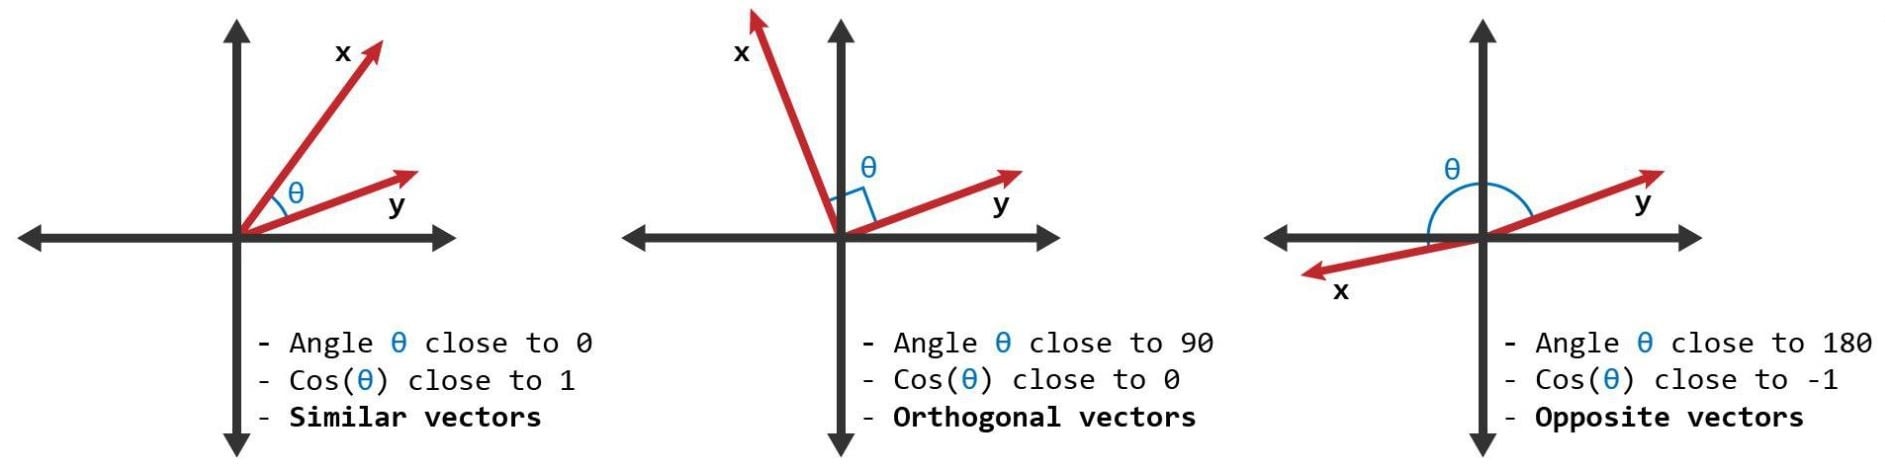
Cosine similarity and vectors

Natural Language Processing con spaCy

Similarità tra token

  • spaCy calcola i punteggi di similarità tra oggetti Token
nlp = spacy.load("en_core_web_md")
doc1 = nlp("We eat pizza")
doc2 = nlp("We like to eat pasta")

token1 = doc1[2] token2 = doc2[4] print(f"Similarity between {token1} and {token2} = ", round(token1.similarity(token2), 3))
>>> Similarity between pizza and pasta =  0.685
Natural Language Processing con spaCy

Similarità tra span

  • spaCy calcola la similarità semantica di due oggetti Span
doc1 = nlp("We eat pizza")
doc2 = nlp("We like to eat pasta")

span1 = doc1[1:]
span2 = doc2[1:]

print(f"Similarity between \"{span1}\" and \"{span2}\" = ", round(span1.similarity(span2), 3))
>>> Similarity between "eat pizza" and "like to eat pasta" =  0.588
print(f"Similarity between \"{doc1[1:]}\" and \"{doc2[3:]}\" = ",
        round(doc1[1:].similarity(doc2[3:]), 3))
>>> Similarity between "eat pizza" and "eat pasta" =  0.936
Natural Language Processing con spaCy

Similarità tra Doc

  • spaCy calcola i punteggi di similarità tra due documenti
nlp = spacy.load("en_core_web_md")

doc1 = nlp("I like to play basketball")
doc2 = nlp("I love to play basketball")
print("Similarity score :", round(doc1.similarity(doc2), 3))
>>> Similarity score : 0.975
  • Un'alta cosine similarity indica contenuti molto simili semanticamente
  • I vettori Doc per impostazione predefinita sono la media dei word vectors
Natural Language Processing con spaCy

Similarità tra frasi

  • spaCy trova contenuti pertinenti a una parola chiave
  • Trovare domande clienti simili alla parola price:
sentences = nlp("What is the cheapest flight from Boston to Seattle? 
                 Which airline serves Denver, Pittsburgh and Atlanta? 
                 What kinds of planes are used by American Airlines?")

keyword = nlp("price")

for i, sentence in enumerate(sentences.sents): print(f"Similarity score with sentence {i+1}: ", round(sentence.similarity(keyword), 5))
>>> Similarity score with sentence 1:  0.26136
Similarity score with sentence 2:  0.14021
Similarity score with sentence 3:  0.13885
Natural Language Processing con spaCy

Esercitiamoci!

Natural Language Processing con spaCy

Preparing Video For Download...